
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
语义智能=:部分@8 @ @-工具全程下游_:自我-优化工具包
Sunday, 16 November 2025
当工具跟踪自身时 @ ,# 自我进化@ MS K1_ 选择自己
注:: 这是Semantic Intelligence系列中的“.”部分 “7”部分 覆盖了整个 DES 架构的“MS K3”部分 这篇文章深入我所夸大的东西 工具本身如何运作@,轨道使用 @,进化}#, 并随着时间的流逝变得更聪明♪.
注:: 如果您认为“ 7” 部分的工作流程演变进化是 wrade @ MS K1 @ 等待您看到当发生时会发生什么 每个工具 拥有同样能力
内容部分 *\ 7 idd'\ t告诉你
在“7,”部分,我向大家展示了指导性合成进化:工作流程 计划「, 生成‘,} 执行 @, 评价@, 并改进{. 我提到『" tools " 一连串次数〞.
在这里,'我做了什么 '}解释:":
这些工具?}它们'}不是静态的{. 它们MS K3}没有固定的配置文件
它们是活生生的艺术品
- 每一赛事的音轨
- 从使用模式中学习
-
- 推动自身的执行工作
- 缓存成功响应
- 谈判健身行业
- 自动版本本身
- 在整个系统重新使用
换句话说, 工具是节点@. @ 节点是工具 @ .} 一切都在演变.
越来越怪异了
工具登记簿=: 自 己 - 扩张宇宙
让我向大家展示一下系统实际上拥有什么 :
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
这: index.json? 5,464线条 使用 stats,}版本历史_,}健康得分{,}和线条追踪.}
里面的每一个工具
- 使用计数器
- 跟踪评价的质量评分
- 保存版本历史
- RAG 内存文物链接
- 仓库性能衡量标准
- 成功职业记录
注:: 系统实际上运行时没有任何工具@. 效率稍低点 @; 和哑巴{. 没有这些工具,就能生成出正常的工作流程分解器}#. 它仍然会慢慢适应 但是它需要更多符号_'
让我们看看一个工具实际上是什么 .
工具解剖=:}更多于配置
@'_这里是系统上真正的工具定义@:}
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
注意那里有什么'
- 业绩分级 @-Cost@,}速度#,QQQ 质量
- 专业 - 这个工具是什么 良好 至
- 能力能力 - 最大输出长度 @, 上下文窗口
- 模板模板 如何援引它?
- 标签标记 -语义分类
但这里 否 在 YAML : 中
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
系统 增强 使用运行时间学习的静态定义@. @%
追踪每个请求的用量
这里“ ' @% ” 当你使用一个工具时会发生什么? “ MS K1@ label
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
追踪到的是什么?
- 援引元数据 -}工具 ID,}模型 ,}参数,}温度
- 业绩表现 实绩 @-_Lantency@,}记忆: ,}回应时间
- 质量质量 @-#_Evaluor 评分@,}用户反馈
- 缓缓 - 即时匹配再利用
- 适合性 - 多-维度评分
让我们看看这个缓存机制 .
从未计算两次
最聪明的点滴': 系统缓存工具在多个级别上的引用@. @%
*级别 \ 1: 精确匹配缓存
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
为什么这重要?
如果您要求系统“ " @ wwrite a haiku 有关代码$ MS K1}$2 ,} 第二次是 即时.}LLM doesn'}运行=.}RAG内存返回缓存结果 .}
但这里是聪明的一小段 它返回 BEST 版本 如果存在多个多@ . @%
实例::
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
系统 自动选择最高@-}质量缓存结果.
适应性超时学习@:停止猜测
系统知道每个模型需要多久才能响应.
问题:
不同模型的反应时间极不相同,
tinyllama@(2_B):} @ ~3#秒llama3@(8_B):} @ ~10#秒qwen2.5-coder@(14_B):} @ ~25#秒deepseek-coder-v2@(16_B):} @ ~60#秒
如果您设置一个全球超时@ ( @ say, @\ MS K2 @s @ MSSK3}您将浪费 @ MPK4 @ 秒等待时间 tinyllama# ,你杀了 deepseek 在完成前@. @%
适应性学习
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
如何运作?
- 每个模型的轨道响应时间
- 计算 95_%th 百分位数 @(}此时间前完成最大部分回复@)
- 添加安全缓冲
- 用作新的超时
结果:*
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
系统 学习每种模型的正确超时 而不是使用全局值@. @%
选择正确工具
当您要求系统做某事时“ , @ it does' @ t选择第一个匹配工具@ MS K2} 它运行一个 健身功能 横跨多个维度@. @%
健身计算@: @%
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
真实的示例@: @%
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
选中@: @% email_validator_workflow (*fitness *:} @190)#
系统选择 {\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080} 不是最有力量的.吗?
最能满足多种制约的
工具 Evolution %M:自 己-}#改进执行情况
工具 D't 保持静态\MS K1 它们演变=.
正在版本 @ & @ 更改检测@ MS K1 @
每个工具都有 定义 hash 以 YAML: 计算
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
当您编辑工具@' @s YAML:}时
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
下次加载@: @%
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
语义版本@: @%
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
正在断开更改@: @%
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
加载@ : @
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
系统 警告您要打破更改 并维护版本历史@. @%
RAG 整合@:工具作为语义艺术
每个工具都会在 RAG 内存中索引,用于语义搜索@: @%
在装入时间@ : @%
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
当你现在搜索:时
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
系统使用 RAG 嵌入器 查找相关工具@,}然后按 多维健身.
工具空间
在我们的系统中,我们保存向量 嵌入 解冻 这是一个矢量数据库, 它为我们提供了一个很好的方法 来查看我们的工具空间 @ .}这是我们的工作流程建设系统的记忆系统@.
切入工具目录\ ( yaml 文件的原始模板@ MSk0\ yaml 文件, 以及用于解析任务% MS K2 @ 和全线等配置 Pre-}创制區塊, 包括 @;
- 我们可以从新的!中建立 原始的提示@ - @
- 整个工作流文件 *\ - 和所有其他东西一样, 是一个实际的 python 脚本
- 每个工具都使用 @ -, 谁称之为 a tool@ MS K1, 当 ,
- 每个 Python 函数@ ( @ workflow 文件 @ MS K1} 生成的\ )
如此一来,所有工作站都是可作成和测试的, 因为每个 Python 元素都有一个测试套件 @ , BDD spec, 静态工具以校验正确性 {&多个 LLM 评估员以确保它有效\ MS K3}
副作用是每一个在工作流程中运行的代码都在那里 @,}准备检查,因为每个“'”#tool@'}创造导致可检查的 Python scripes.}
你可以看到那些太过热 和每块浮质一起 成为一套模拟链接的工具 比如:
- 添加“1”和“MS K1”
- 添加“1”和“切片”
- 添加麻木 x+ y
- 和优化的 x +%y 代码处理法
自然地在系统上专门研究这个系统... ...''s nature...
未来我们可能希望优化这些组群, 将代码库缩小为更小的 , 收紧\ ,\ 更多的最优化系统\ .\ {
我们可以追踪版本“, usings @,}变化和谎言,我们可以有选择地优化。 “'’Croup defrag' tnhe most used and fally 关键连接点”作为系统内在结构的一部分。
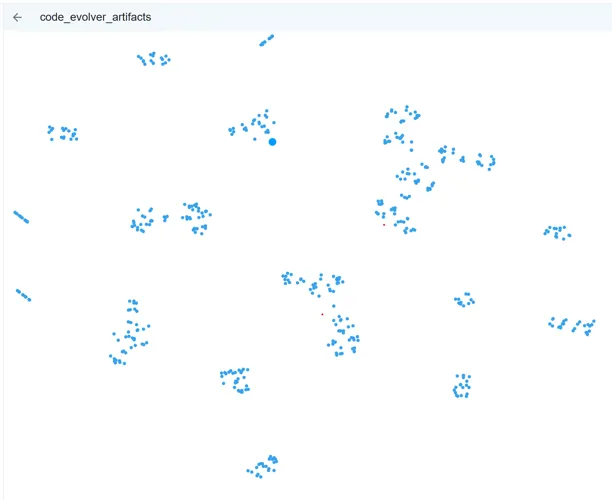
新兴富丰富的生态系统
让我们看看系统现在实际存在什么 .
LLM 工具 @(27#专家@):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
可执行工具@ : @%
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
OpenAPI 工具@: @%
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
工具总数 @: @% 50+
元数据总项目=%:} 5,464 线条 index.json
代码优化工具
让我给你们展示系统里最先进的工具 : code=_优化器.
定义: tools/llm/code_optimizer.yaml (317线!)
它能做什么 :
- 配置简介 基准执行情况
- 分析分析 @(CPU, I/OMS K3记忆@)
- 选择优化级别@: @%
- 改善=)
- -=YTET -伊甸园字幕组=- 翻译:
- 系统=-#一级重新设计@)
- 优化 在选定级别上的代码
- 更新测试 自动自动
- 配置简介 优化版
- 比较对比 在“/”之后
- 决定决定: 接受@ / reject
- 版本 被接受
- 缩略语 如果无断断点更改, 则使用
等级优化@: @%
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
成本管理#:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
测试整合@: @%
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
版本管理@: @%
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
这个 单一工具 交响乐团:
- 3 特征分析运行
- 多-级 LLM 优化
- 自动测试更新
- 业绩比较
- 成本上升
- 版本管理
- 自动-移民
和它#' 只有一个工具 在一个系统中 50+#工具.
模型选择器Name:LMs
多数元工具之一 @:# 模式@_ @ 选择器.
自然语言选择
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
它如何运作 :
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
系统分析自然语言 选择模型@. 您可以说 @:
- @"use gpt-4}为此而设 "
- 选择最快的模型"
- 这本书需要长的上下文 " *
- 使用最强大的代码llm="
它聪明地向右后端前进 .
OpenAPI 融合+:作为第一公民的外部工具@-}%Class Citizens
系统对待外部 API 的方式与内部工具相同@. @%
NMT 翻譯者
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
运行时@: @
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
追踪到的是什么?
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
外部API 获得相同的处理@:
- 跟踪使用使用情况
- 业绩计量
- 质量评分
- 健身性计算
- RAG 指数化
工作流文档员 @: Meta-}工具
最疯狂的工具之一 工作流程@_ @% documenter.
它能做什么 :
需要工作流程@( @a main.py 和文件@)}及 自动生成全面文档 M:
- 阅读代码
- 提取输入@/ @outputs
- 检测工具电话
- 分析复杂程度
- 正在生成美人鱼图
- 创建使用实例
- 正在写入 FAQs
- 保存到
README.txt
全部自动@ . @%
定义: tools/llm/workflow_documenter.yaml (11,803字符!)
输入:
{
    "workflow_path": "nodes/email_validator/main.py"
}
产出=:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
使用率示例
API 呼叫
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
Python 符号
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
共同使用案例
- 注册时验证表格
- 企业电子邮件的电子邮件域域校验
- 散装电子邮件列表清理
- API 投入输入验证
业绩表现 实绩
- 速度速度速战速决
- 费用成本免费的( 纯净Python ) *
- 准确性用于标准电子邮件格式的 : @ MPK1@
限制
- 没有验证电子邮件实际存在
- 不检查 DNS 记录
- RFC-}符合要求的边缘情况可能会失败
FAQ 孔径
@:_ 能够校验是否有电子邮件@? A:No,此唯一验证格式@.使用 DNSMS K3ZSMTP 检查是否存在 @.
支持国际域吗? A:是,但可能需要 punycode 转换@.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
用户: @ "I 需要一个转换温度的工具@"
系统@:
- 搜索类似工具的RAG
- 查找 @"unit@}converter "}{(}\ genneric conferationer)} 找到“MSK 0unite 翻譯者% k2} MSQ} 【 MSk3】 generic converser_ MSC4}
- 使用代码@ _ @ generator 创建专门化的 <% K1 textperature MS K2 converder "}
- 运行测试
- 评价质量
- RAG 仓库
- 登记册作为新工具
- 自动生成文档
- 添加到工具登记册
已创建的新工具 @ : @ s温@ MS K1 @ converter @ MPK2 @ yaml
- 版本@: @ @ 1.0.0 @
- 质量#:}0.88
- 速度#:}非常的-_fast
- 免费成本@:
- 以索引=.json注册
- 以RAG为索引
- 产生文件
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
系统 知道:吗?
- 有多少工具存在
- 哪些类型最常见
- 哪个标签很受欢迎
- 哪些工具最能被使用
和它 使用此数据 {\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}到:
- 建议类似的工具
- 找出空白@(}缺少工具类型 @)
- 优先优化 ( @Optimize high #-#%usage makings@)}
- 建议合并 {(} merge 类似低的}-=usage makings@)}
令人不适的实现
让我们往后退一步 想想我们实际上建造了什么
系统, 其中:
- 工具跟踪自己的使用情况
- 工具版本本身
- 工具发展其实施
- 工具生成其他工具
- 工具文件本身
- 工具根据健身情况自行选择
- 工具隐藏他们自己的职业
- 工具学习最佳超时
- 工具谈判交易@-offs @ @(}速度与质量对成本=)}
我们创造了一个自制的- 优化工具包,
- 自行展开 @ ( @ generates 新工具@ MS K1 @ {
- 改善自己 @( @优化现有工具@)}#
- 文档本身 @(_auto}-}Generates docs)
- 自行选择 @(fitness@-}基于routing_)
- 水箱本身 @ ( @ 等级记忆@ MS K1 @ @
- 版本本身@( @ 自动模版 @ ) @
- 学习自身 ( 适应性能调试
这是'#t 配置管理@.}
这是新兴的生态工具 .
工具是 @'}不是静态资源@.}它们='re 进化系统中活的文物.
这让 @ ( @ 以及为什么它@ MS K1 @ 怪异 @ I) @
改善关键路径
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
系统优化了自己的关键路径,没有人类的干预
适应性专业
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
该系统确定了一个模式,并创建了专门工具“.”
假设方案 @3:Cost@-}软件升级
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
该系统明智地花费了资金,以取得更好的成果。
当前库存工具
让我对现在实际存在的东西进行分类 .
LLM 工具@(27) @%
守则专家
code_explainer“-”解释自然语言的代码code_optimizer-=YTET -伊甸园字幕组=- 翻译:code_reviewer质量和安全审查fast_code_generator具有小型型号的快速发电security_auditor脆弱程度扫描performance_profiler- 代码特征分析和分析
内容专家 @:
long_form_writer(128QK上下文 @)content_generator-一般内容article_analyzer@- @ 文章结构@/_Qqualitysummarizer- 总结长内容proofreader-语法和风格seo_optimizer-SEO优化outline_generator-内容大纲
翻译: :
quick_translator@-_快速翻译@(}小型号#)translation_quality_checker- 校验翻译
文 件 @:
doc_generator-码文件technical_writer技术文件workflow_documenter-Auto-Generates工作流程文档
系统工具@: @%
general-=YTET -伊甸园字幕组model_selector-}选择最佳后端@/}模式task_to_workflow_router- 工作流程路径任务quick_feedback-快速分流signalr_connection_parser- Parses 信号连接signalr_llmapi_management- 管理信号LLM APIs
可执行工具 @ (19) @%
校验@:
call_tool_validator@ -_ 校验呼叫@ MS K1_ tool @ MPK2}使用率python_syntax_validator-语法校验mypy_type_checker-静态类型检查json_output_validator-JSON格式验证stdin_usage_validator- 校验 stdin 使用量main_function_checker-检查主机@()功能node_runtime_import_validator“-” 校验进口
分析=:
run_static_analysis- 运行静态分析工具performance_profiler- 配置代码性能
公共事业: :
save_to_disk磁盘耐久性unit_converter*- 单位转换random_data_generator- 测试数据生成buffer-缓冲管理workflow_datastore工作流量数据存储stream_processor-流处理sse_stream@ -_ 服务器@ MS K1}已存在事件
整合+:
connect_signalr- 讯号连接signalr_hub_connector- 枢纽连接signalr_websocket_stream-+WebSocket串流
文 件 @:
document_workflow-工作流文件生成器
OpenAPI 工具@(3) @%
nmt_translator-神经机器翻译API- 未来外部服务的其他服务
总和: 53 工具( 以及增长})
工具调用工具时工具的构成@: @%
{\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}这里是: 工具组成其他工具.
当一个合成工具进化时 每个使用它的工作流程都自动改进.
翻译管道
让我们看看系统上的一个实际复合工具 :
任务: 将这篇文章转译为西班牙文并验证质量*"
传统方法_:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
DSE 方法@:
该系统发现这种模式经常使用, 自动创建复合工具:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
{\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}关于这个
何时 nmt_translator 变换为 v2.0.0} @ (} @ mostK1 @ maybe # MS K2} 更快@ ),} 是复合工具 自动使用新版本不需要更改代码@. @
结果#: 使用的每一工作流程 validated_translator 更快地获得#20%} 未作任何修改.
代码审查委员会
这里的'是一个更酷的例子 : 平行工具构成.
任务: 校对:Soup
巧妙的方法 @:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE 平行组成@: @%
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
执行=:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
结果#: @35秒 @ → @ @ I20秒@ MS K3 更快 @ MPK4#
和何时 security_auditor 变换到 v3.0.0 @ @ @ (} @ say@ MS K2} @ * 30%} 更快地 @ MPK4} 整个委员会都自动得到快速=.}
基因传播工具作为复制单位
这里'是这个部分 '真正狂野的"MS K2" 工具就像基因一样.
观察:: 当工具证明有用时 @ , @ it 横跨整个系统.
真实的示例@:质量检查器模式Name
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
这是字面上的遗传传播 :
- 重复复制 - 工具被复制到新的工作流程
- 变异 -#工具进化@(_v1.0} @→{v2.0)}
- 选择 @- 更高健康度 @#=}更多使用量
- 专业 成功的型态产卵变种
- 继承继承权 儿童工具继承来自父母的元数据
代码路径是 ALWAYS 最佳, 因为 @ : @
- High-Fitness 工具更经常被选中
- 变换工具自动@ - @ 替换旧版本
- 共同模式出现特殊变式
- Low-Fitnity 工具被修剪
培训全过程同时进行
{\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}这是非常聪明的 您可以同时改进所有工具.
假想: 您的“ 20” 工作流程@ MS K1 @ 每个人使用“ I5-10” 工具 @ . 总计 @ MPK4 _ @ O~100 工具调用@.
传统制度#:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
DSE 系统@: @%
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
结果#:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
你同时训练了一个工具 并改进了EightEEN工作流程
当改进推广时 :\
真正狂野的部分 : * 通过依赖图显示的进化级联.
实例::
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
一个进化事件改进了ELEVEN工作流程,没有任何人工干预 .
总是-}有效代码路径
因为工具跟踪健身@ , @ 缓存结果 @ MS K1 @ 和自动=% k2\ evolve,_ 系统 总是运行现有最佳执行工具.
执行实例@:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
系统@: @%
- 总是使用最高@ - fitness 工具
- 总是使用最新的@ , @ best @ MS K1 @ spective 版本
- 总是缓存成功结果
- 总是跟踪业绩
- 随时间推移不断改进
每一步都优化代码路径@ : @
- 工具选择@(fitness @-}基于)
- 版本选择@ ( @ latestest @ ) @
- 如果可能的话,行刑
- 学习 #(\ 度量更新@)\ #
- 如果检测到降解 )\ \ }进化 (\ 触发
遗传视角
让'+%s精确地解释为什么这是 定向合成进化 并不只是@" @ changing与版本的拼接+":}#
作为 Genes @ :_ 的工具
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
直接进化:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
-=YTET -伊甸园字幕组=- 翻译:
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
遗传传播可视化
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 stroke:#ef4444,stroke-width:3px
    style T2 stroke:#10b981,stroke-width:3px
    style T3 stroke:#6366f1,stroke-width:3px
    style W1 stroke:#eab308,stroke-width:3px
    style W2 stroke:#eab308,stroke-width:3px
    style W3 stroke:#eab308,stroke-width:3px
    style U1 stroke:#f59e0b,stroke-width:3px
    style U2 stroke:#f59e0b,stroke-width:3px
遗传遗产_:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Neat,右 ?
{\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}真的疯狂吗?
我们建造了一个系统 在那里:
- 工具像基因一样复制
- 身体健康决定生存
- 由数据引导进化
- 通过依赖关系实现的改进级联
- 整个代码库自我优化
它不是比喻 .
实际定向合成进化
真正有效的是什么?
此系统运行数周后@ : @
管用的东西 @✓
- 跟踪使用使用情况 - 准确对计, 性能衡量标准
- 基于 Fitness @- @% 基础选择 真正选择更好的工具
- 等级级结扎 *- 多次请求的大规模加速
- 适应性超时 模特儿有合适的等待时间
- 工具版本 -Semver work *, 检测到的破碎变化
- RAG 指数化 -语义搜索找到相关工具
- 开放的APIPI一体化 - 外部API工作无缝
- 自动-文档 - 工作流程 @_}文件器出人意料的好
- 代码优化 - 等级级水平节省资金,提高质量
什么是' 粗略的\ ✗
- 工具爆炸 工具意味着选择瘫痪
- 重叠能力 @- 多工具做类似的事情
- 质量不一致 一些工具极佳 其它的普通
- 缓存无效 @-_ 很难知道缓存结果何时会过时
- 版本移民 移民有时会打破事物。
- 费用追踪 @- 很容易在云的优化上打击预算
- 文件流文件 -Auto-docs dono{'}在代码更改时总是更新
什么? 奇怪吗?
- 工具优化工具 - 代码优化器 优化代码生成器
- 连累演变 “-工具A 演进”“,触发了使用 A 的工具的演变。
- 新兴专业化 -系統產生超級{-特定工具
- 健身游戏 -=YTET -伊甸园字幕组=- 翻译:
- 版本扩散 某些工具的版本为 @15+#
- 自定义“ -” 优惠环 - 工具文档处理器已自制
未来#:}这下往何处去
如果工具能够 @ : @
- 跟踪使用情况
- 自我发展
- 生成新工具
- 自行选择
- 缓存引用
- 学习表现
什么是' @% 下一步 @ ?}
短时 @ ( @ next few weth months@ MS K1
- 工具合并 - 合并类似工具@, prune llow @-usage
- 适合性调适 “- ”更好多“-”维度评分
- 费用控制 更聪明的预算管理
- 版本修剪 -Auto-旧版本
- 文件同步 - 保持文件与代码同步
中期 (2025)
- 工具市场 @- 共享各种实例的工具
- 协作演变 - 多发DSE实例正在演变的共享工具
- A/B 测试 - 工具版本的自动比较
- 工具组成 - 自动将工具合并到工作流程中
- 性能预测 @- 预知工具在行刑前是否适合
野生想法 @(#真正有趣的东西 @MSSK1@%
- 工具育种 “- 结合成功工具创建混合体”
- 逆向演变 “- 工具, 竞相解决问题
- 工具生态系统 工具之间的共生关系
- 经济模型 @-_工具@ "}pid"}有关基于健身的任务
- Meta -工具 管理其他工具的工具
- 工具迁移工具迁移 - 将流行工具自动移动到更好的后端
- 自 己 - 血缘平衡 “-”工具可以记住失败, 并且永远不再重复“(” 。
Mession : @ it' @%s 工具一路往下
这里的' @%s what part Part *{7}(部分) <MSK 1\h\h#' 完全解释@:
**由工具构成的工作流程 . *** 构成工作流程的工具 @?}它们进化得太快了 管理进化的系统... ?... 还有工具... 追踪健身度量的测量标准@?Yep,工具 @.
{\fn黑体\fs22\bord1\shad0\3aHBE\4aH00\fscx67\fscy66\2cHFFFFFF\3cH808080}它把工具一直用到下面...
和每一个单':
- 跟踪其使用情况
- 衡量其业绩的业绩
- 逐步改善
- 了解自己的体格
- 缓存成功运行
- 版本本身
- 文件本身
我们没有建立代码生成器 .
我们设计了一个自制的-扩展工具箱 并生成代码.
区别问题 .
因为当工具变成进化单位时 当它们追踪自己的身体健康的时候 , 当它们繁殖和变异及竞争的时候
您没有工具箱@ . @ title
你有生态学 .
生态学不断演化
但是当进化破坏事物时会发生什么呢? 当工具突变引入一个关键错误\ ? 时,当优化使工具更糟糕而不是更好\ MASK1\ \
.来的地方 我们探索 @ -\ healing through lineage@ MS K1 意識修剪“—a system, 工具刚刚进化”“'t”, 他们记得每一个失败的“ ,prune shalls unfault blankets”", 并传播这些知识以防止在整个生态系统中发生类似的错误 ” @.
当工具可以打破自我时, 您的系统应该记住为什么而且永远不要重犯错误@ . @
技术资源
仓库@: @% 多数为lucid.dse
密钥文件@:
src/tools_manager.py核心工具管理src/rag_integrated_tools.py-=YTET -伊甸园字幕组=- 翻译:src/openapi_tool.py@ (313 @ line * ) @ * MS K2 OpenAPI 支持src/model_selector_tool.py(460线)}MS K2模擬選擇tools/index.json(5,464线)}MS K2 工具登记簿tools/llm/*.yaml(27#工具 )}-}LLM 专家定义tools/executable/*.yaml(19#工具 @)}-}可执行的工具tools/openapi/*.yaml“(3”工具“)” A- API集成
文 件 @:
LLMS_AS_TOOLS.md-LLM甄选制度WORKFLOW_DOCUMENTATION_TOOL.md-Auto-文件CHAT_TOOLS_GUIDE.md工具使用指南TOOL_PACKAGING.md-工具开发指南
系列导航:
- “1:Q 简单规则”部分 @,Z 复杂行为 I- 基金会
- 集体情报 通讯能改变一切
- 部分@3: @ self @ -_ 优化 改善自我的-Z系统
- 《新出现》 当优化成为智能时
- 部分=5:}进化 - 从优化到行业和文化
- 全球共识 - 定向进化和行星认知
- -=YTET -伊甸园字幕组=- 翻译: 实际建造它并观察它的演变
- 部件“8:” 工具全部向下 “←你在这里 ”“自我-优化工具包”。
- @ 9:_ self@ MS K1_ 治疗工具 - 线性@- 观测修补和恢复
- DISE 烹饪器 当理论遇到混乱的现实时
这是Semantic Intelligence系列中的“8”部分, “.” 部分“MS K2” 显示整个 DSE 架构“MSKO3” 这一文章揭示了系统轨迹中每个工具隐藏的复杂性“:” 这个文件显示了系统中每一个工具的使用方式 ‘,’ 进化了实施过程 , 缓存结果",}- 并参与了基于“MSK8” 选择“MSSK9 {该工具包不仅仅是一个资源“MS10” “I'” 一个进化生态,它扩展了“MSC12” 优化了@MSKK13 和文档本身“MSQK14 工具产生工具” . “工具改进工具” “MS K16 ” 并且整个系统随着时间变得更加精明 □.}
校对:Portnoy
这些探索与Sci-fi小说 @"MIchael}"有关新兴AI 和优化自身系统的影响的SCI=.}这里描述的工具是真正的实施过程,说明进化压力是如何创造专业化的吗?,健康功能如何引导选择_,以及自我--改善体系如何自然地发展生态=MS K7类似属性@.这是否导致Part+6,的行星-标度工具网络或完全出乎意料的东西{,还有待观察
标签: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology