
This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
पूर्ण पाठ खोज रहा है (Pt
Tuesday, 20 August 2024
परिचय
सामग्री की खोज किसी भी सामग्री भारी वेबसाइट का एक महत्वपूर्ण हिस्सा है।
इस श्रृंखला में अगला भाग:
दृष्टिकोण
वहाँ' पूरे पाठ खोज करने के लिए कई तरीके हैं जिनमें शामिल है
- सिर्फ मेमोरी डेटा संरचना खोज रहा है (एक सूची की तरह), यह कार्यान्वयन करने के लिए सापेक्ष रूप से सरल है लेकिन नहीं करता है
- एसक्यूएल सर्वर या पोस्टग्रेस जैसे डाटाबेस का उपयोग
- हल्के वजन खोज प्रौद्योगिकी का उपयोग जैसे लुसेनCity name (optional, probably does not need a translation) या SQLite FTS. यह दो उपरोक्त समाधानों के बीच एक मध्य आधार है। hood के नीचे Lucene का उपयोग करने के लिए amazing vector search capabilities
- एलास्टिक सर्च जैसे एक खोज इंजिन का उपयोग करना।
डाटाबेस पूर्ण पाठ खोज Postgres के साथ
इस ब्लॉग में मैंने हाल ही में अपने डाटाबेस के लिए पोस्टगर्स का उपयोग करने के लिए आगे बढ़ा है।
जब आप बनाते हैं DbContext आप निर्दिष्ट कर सकते हैं कि कौन से क्षेत्रों में पूर्ण पाठ खोज प्रकार्य सक्षम है
खोज भेक्टर एक डेटा संरचना है जो दस्तावेज़ में शब्दों और उनके स्थानों को समाहित करता है। यह इस को प्राप्त करने के लिए दो विशेष डेटा प्रकार का उपयोग करता है
- TSVector: एक विशेष PostgreSQL डेटा प्रकार जो शब्दावली की सूची भण्डारण करता है।
- TSQuery: एक अन्य विशेष डेटा प्रकार जो खोज क्वेरी को भंडारित करता है।
इसके अलावा यह एक रेटिंग फ़ंक्शन प्रदान करता है जो आपको खोज क्वेरी के साथ कितनी अच्छी तरह मिलते हैं पर आधारित परिणामों को दर्ज करने की अनुमति देता है PostgreSQL परिणामों को प्रासंगिकता के आधार पर श्रेणी निर्धारण करता है। इस रैंकिंग को संगणित करने के लिए ts_rank या ts _rankM SK2cd फ़ंक्शन का प्रयोग किया जाता है
आप पोस्टग्रस की पूर्ण पाठ खोज विशेषताओं के बारे में अधिक पढ़ सकते हैं यहाँ
इकाई फ्रेमवर्क
पोस्टग्रेस अस्तित्व फ्रेमवर्क पैकेज यहाँ पूर्ण पाठ खोज के लिए शक्तिशाली समर्थन प्रदान करता है
इसे करने के लिए हम हमारे Entities में परिभाषित की तरह विशिष्ट अनुक्रमणिका प्रकार जोड़ते हैं DbContext:
   modelBuilder.Entity<BlogPostEntity>(entity =>
        {
            entity.HasIndex(x => new { x.Slug, x.LanguageId });
            entity.HasIndex(x => x.ContentHash).IsUnique();
            entity.HasIndex(x => x.PublishedDate);

                entity.HasIndex(b => new { b.Title, b.PlainTextContent})
                .HasMethod("GIN")
                .IsTsVectorExpressionIndex("english");
  ...
यहाँ हम' एक पूरा पाठ अनुक्रमणिका जोड़ रहे हैं Title और PlainTextContent हमारे क्षेत्रों BlogPostEntityहम भी निर्दिष्ट कर रहे हैं कि अनुक्रमणिका का उपयोग करना चाहिए GIN अनुक्रमणिका प्रकार और english भाषा. यह महत्वपूर्ण है क्योंकि यह पोस्टग्रस को बताता है कि कैसे डेटा को सूचकांकित किया जाए और क्या भाषा शब्दों को रोकने और बंद करने के लिए प्रयोग करें
यह स्पष्ट रूप से हमारे ब्लॉग के लिए एक मुद्दा है क्योंकि हम कई भाषाएँ हैं english सभी पदों के लिए भाषा
हम भी हमारे एक अनुक्रमणिका जोड़ें Category अस्तित्व:
     modelBuilder.Entity<CategoryEntity>(entity =>
        {
            entity.HasIndex(b => b.Name).HasMethod("GIN").IsTsVectorExpressionIndex("english");;
...
इस कर Postgres डाटाबेस में प्रत्येक पंक्ति के लिए एक खोज वक्टर उत्पन्न करता है. यह वक्टर में शब्दों को समाहित करता है Title और PlainTextContent क्षेत्रों. हम तब दस्तावेज़ में शब्दों की खोज के लिए इस सदिश का उपयोग कर सकते हैं
यह SQL में एक to_tsvector फ़ंक्शन के रूप में परिभाषित करता है जो पंक्ति के लिए खोज भेक्टर उत्पन्न करता है।
SELECT to_tsvector('english', 'a fat  cat sat on a mat - it ate a fat rats');
to_tsvector
-----------------------------------------------------
'ate':9 'cat':3 'fat':2,11 'mat':7 'rat':12 'sat':4
यह हमारे डाटाबेस में एक माइग्रेसन के रूप में लागू करें और हम'खोजने के लिए तैयार हैं
खोज रहा है
टीएस भेक्टर अनुक्रमणिका
खोज के लिए हम उपयोग करेंगे का उपयोग करें EF.Functions.ToTsVector और EF.Functions.WebSearchToTsQuery एक खोज भेक्टर और क्वेरी बनाने के लिए फ़ंक्शनों. हम फिर उपयोग कर सकते हैं Matches खोज सदिश में क्वेरी के लिए ढूंढने का फ़ंक्शन
  var posts = await context.BlogPosts
            .Include(x => x.Categories)
            .Include(x => x.LanguageEntity)
            .Where(x =>
                EF.Functions.ToTsVector("english", x.Title + " " + x.PlainTextContent)
                    .Matches(EF.Functions.WebSearchToTsQuery("english", query)) // Search in title and content
                && x.Categories.Any(c =>
                    EF.Functions.ToTsVector("english", c.Name)
                        .Matches(EF.Functions.WebSearchToTsQuery("english", query))) // Search in categories
                && x.LanguageEntity.Name == "en") // Filter by language
            .OrderByDescending(x =>
                EF.Functions.ToTsVector("english", x.Title + " " + x.PlainTextContent)
                    .Rank(EF.Functions.WebSearchToTsQuery("english", query))) // Rank by relevance
            .Select(x => new { x.Title, x.Slug })
            .ToListAsync();
EF.Functions.WebSearchToTsQuery फ़ंक्शन सामान्य वेब खोज इंजन वाक्य संरचना पर आधारित पंक्ति के लिए क्वेरी उत्पन्न करता है
SELECT websearch_to_tsquery('english', '"sad cat" or "fat rat"');
       websearch_to_tsquery
-----------------------------------
 'sad' <-> 'cat' | 'fat' <-> 'rat'
इस उदाहरण में आप देख सकते हैं कि यह एक क्वेरी उत्पन्न करता है जो दस्तावेज़ में शब्द "sad catM SK1 या "fat rat" की खोज करता है। यह एक शक्तिशाली विशेषता है जो हमें जटिल प्रश्नों के लिए आसानी से खोजने की अनुमति देता है
जैसा कि कहा गया befpre इन तरीकों दोनों खोज भेक्टर और पंक्ति के लिए क्वेरी उत्पन्न करें. हम फिर उपयोग Matches खोज सदिश में क्वेरी के लिए ढूंढने के लिए फ़ंक्शन Rank प्रासंगिकता के आधार पर परिणामों को श्रेणीबद्ध करने का कार्य
जैसा कि आप देख सकते हैं यह एक साधारण क्वेरी नहीं है, लेकिन यह बहुत शक्तिशाली है और हम शब्दों के लिए खोज करने की अनुमति देता है Title, PlainTextContent और Category हमारे क्षेत्रों BlogPostEntity और इन को प्रासंगिकता के आधार पर श्रेणीबद्ध करें
वेबएपीआई
इन का उपयोग करने के लिए हम एक साधारण WebAPI अंतबिंदु बना सकते हैं जो एक क्वेरी लेता है और परिणाम वापस करता है
[ApiController]
[Route("api/[controller]")]
public class SearchApi(IMostlylucidDbContext context) : ControllerBase
{
    [HttpGet]
    public async Task<JsonHttpResult<List<SearchResults>>> Search(string query)
    {;

        var posts = await context.BlogPosts
            .Include(x => x.Categories)
            .Include(x => x.LanguageEntity)
            .Where(x =>
                EF.Functions.ToTsVector("english", x.Title + " " + x.PlainTextContent)
                    .Matches(EF.Functions.WebSearchToTsQuery("english", query)) // Search in title and content
                && x.Categories.Any(c =>
                    EF.Functions.ToTsVector("english", c.Name)
                        .Matches(EF.Functions.WebSearchToTsQuery("english", query))) // Search in categories
                && x.LanguageEntity.Name == "en") // Filter by language
            .OrderByDescending(x =>
                EF.Functions.ToTsVector("english", x.Title + " " + x.PlainTextContent)
                    .Rank(EF.Functions.WebSearchToTsQuery("english", query))) // Rank by relevance
            .Select(x => new { x.Title, x.Slug })
            .ToListAsync();

        var output = posts.Select(x => new SearchResults(x.Title.Trim(), x.Slug)).ToList();

        return TypedResults.Json(output);
    }
Generated Column and TypeAhead
इनका उपयोग करने के लिए एक वैकल्पिक दृष्टिकोण है 'simple' TsVector Indices खोज वक्टर को भंडारित करने के लिये एक उत्पन्न स्तंभ का प्रयोग करना और फिर इसे खोजने के लिए इस्तेमाल करना
यहाँ हम अपने परिवर्धित करें BlogPostEntity स्तम्भ का एक विशेष प्रकार जोड़ने के लिए
   [DatabaseGenerated(DatabaseGeneratedOption.Computed)]
    public NpgsqlTsVector SearchVector { get; set; }
यह एक संगणित स्तंभ है जो पंक्ति के लिए खोज भेक्टर उत्पन्न करता है
तब हम इस अनुक्रमणिका को अपने अस्तित्व परिभाषा के भीतर स्थापित करें ( अभी पुष्टि करने के लिए, लेकिन यह भी हमें एक भाषा स्तंभ प्रत्येक पोस्ट के लिए निर्दिष्ट करके अनेक भाषाओं का होना अनुमति दे सकता है
   entity.Property(b => b.SearchVector)
                .HasComputedColumnSql("to_tsvector('english', coalesce(\"Title\", '') || ' ' || coalesce(\"PlainTextContent\", ''))", stored: true);
आप ' यहाँ देखेंगे कि हम उपयोग HasComputedColumnSql खोज सदिश उत्पन्न करने के लिए PostGreSQL फ़ंक्शन को स्पष्ट रूप से निर्दिष्ट करें
डेटाबेस में यह प्रत्येक पंक्ति के लिए उत्पन्न किया है, जो दस्तावेज़ में 'lexemes' और उनके स्थान हैं
"'1992':464 '1996':468 '20':480 '200':115 '2007':426 '2009':428 '2012':88 '2015':397 '2018':370 '2020':372 '2021':288,327,329,399 '2022':196,243,245,290 '2024':156,158,198 '25':21,477,486,522 '3d':346 '6':203,256 '8':179,485 '90':120,566 'ab':282 'access':221 'accomplish':14 'achiev':118 'across':60 'adapt':579 'advanc':134 'applic':168,316,526 'apr':155,197 'architect':83,97,159 'architectur':307,337 ...
खोज एपीआई
तब हम इस स्तंभ को दस्तावेज़ में शब्दों की खोज के लिए उपयोग कर सकते हैं Matches खोज सदिश में क्वेरी के लिए ढूंढने के लिए फ़ंक्शन Rank प्रासंगिकता के आधार पर परिणामों को श्रेणीबद्ध करने का कार्य
       var posts = await context.BlogPosts
            .Include(x => x.Categories)
            .Include(x => x.LanguageEntity)
            .Where(x =>
                // Search using the precomputed SearchVector
                x.SearchVector.Matches(EF.Functions.ToTsQuery("english", query + ":*")) // Use precomputed SearchVector for title and content
                && x.Categories.Any(c =>
                    EF.Functions.ToTsVector("english", c.Name)
                        .Matches(EF.Functions.ToTsQuery("english", query + ":*"))) // Search in categories
                && x.LanguageEntity.Name == "en") // Filter by language
            .OrderByDescending(x =>
                // Rank based on the precomputed SearchVector
                x.SearchVector.Rank(EF.Functions.ToTsQuery("english", query + ":*"))) // Use precomputed SearchVector for ranking
            .Select(x => new { x.Title, x.Slug })
            .ToListAsync();
You'l lsee here that we also use a different query constructor EF.Functions.ToTsQuery("english", query + ":*") जो हमें एक TypeAhead प्रकार प्रकार प्रकार कार्यात्मकता प्रदान करने के लिए अनुमति देता है (जहां हम e टाइप कर सकते हैं .gM SK2 'cat' और प्राप्त कर सकते है
इसके अलावा यह हमें मुख्य ब्लॉग पोस्ट क्वेरी को सिर्फ में क्वेरि के लिए खोजने की सरलता प्रदान करता है SearchVector स्तंभ. यह एक शक्तिशाली विशेषता है जो हमें शब्दों के लिए खोजने की अनुमति देता है Title, PlainTextContent. हम अभी भी ऊपर दिखाए गए सूचकांक का उपयोग करने के लिए CategoryEntity.
x.Categories.Any(c =>
                    EF.Functions.ToTsVector("english", c.Name)
                        .Matches(EF.Functions.ToTsQuery("english", query + ":*")))
फिर हम का उपयोग करें Rank क्वेरी के आधार पर प्रासंगिकता द्वारा परिणामों को श्रेणीबद्ध करने का फ़ंक्शन
x.SearchVector.Rank(EF.Functions.ToTsQuery("english", query + ":*")))
यह हम अंत बिंदु के रूप में निम्नलिखित का उपयोग करने देता है, जहां हम एक शब्द के पहले कुछ अक्षरों में पास कर सकते हैं और वापस सभी पोस्ट जो उस शब्द से मिलते हैं
आप देख सकते हैं यहाँ कार्य में API ढूंढें /api/SearchApiइस साइट के लिए स्वैगर सक्षम किया गया है इसलिए आप API को कार्य में देख सकते हैं लेकिन अधिकांश समय यह इस के लिए आरक्षित होना चाहिए
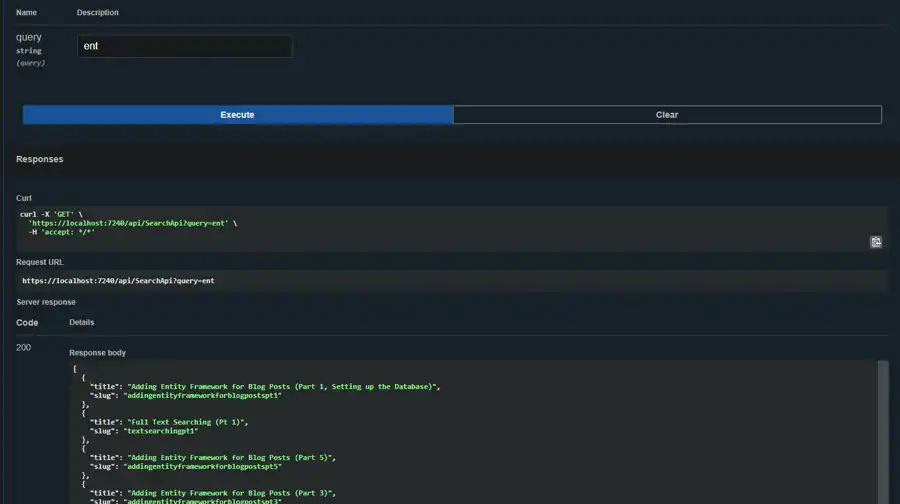
भविष्य में मैं इस प्रकार्य का उपयोग करता है साइट पर खोज बॉक्स में एक TypeAhead सुविधा जोड़ूंगा
अंत में
आप देख सकते हैं कि यह है-'-Postgres और Entity फ्रेमवर्क का उपयोग करके शक्तिशाली खोज कार्यात्मकता प्राप्त करने के लिए संभव है। However it has complexities and limitations we need to account for.