
Збудовування в основному зрозуміле-nmtМSK1 ProdukціяM SK2Ready (EasyNMT compatibleMSC4 Translation Service


Введение
Швидка implementaція API, яка докорінно копує API EasyNMT (https ://github.comM SK3UKPLabMSC4EasyNMTMska5 чудова, але залишена нейронна машинаMСК6машинаМСК7проект перекладуMSК8 Але я МСК9 додав так багато чудових властивостей, які збільшують надійність і роблять його готовим до використання в виробничому системіMСК10 Думайте, що швидкий переклад є самовіддаленим
З самого початку цього блогу , велика пристрасть була автоматичними - перекладанням блогових статей МSK2 Так, я знаю, що МSK3google робить це МСК4 в браузерах і т.д. MСК5etcMСК6 але це не головна річ М СК8 Я хотів знати, як це зробити M СК9 До того ж, М Ск10 приємно зустрічатися з людьми, які не читають англійської M Sк11 не читатимуть англійської М Sк12 навіть, якщо вони читатимуть Англійську як втору мову М ็ Sк13 це M ็ Ск14 набагато важче розшифровувати М Шк15 Тож я зрозумів, як зробити це, М S к16 а також поділився тим, як побудувати таку систему М ס к17 О, і це дало мені ідеї про те, як використовувати її в АSP М с к18 NET для автоматичної локалізації тексту | М С к19 включно з динамічним текстом | M С ্ С К 20 за допомогою Сигналу Р Ми С ’ нк21 гнучка система актуалізації в реальному часі М М С К 22 Мі С ์ 23залишатися на зв 'язку!).
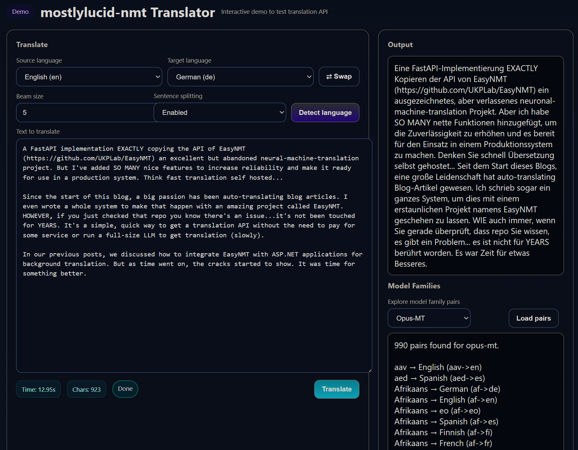
О, і я ' зробив демо тут ; httpsM SK2nmtdemo.mostlylucid МSK4net МSK5demo мSK6 це мSK7 працює лише на старому лептопі без ҐПУ, але це дає вам ідею M( і дозволяє мені перевірити небезпеку
По суті, люди пишуть жахливі тексти, які є дуже шумними для машини, щоб працювати ефективніше. МСК1 So a lot was figuring out how to work around issues with EasyNMT ( it was really ever a research project). Now mostlylucid-nmt designed to be a battle tested (well translating the tens of thousands of words on here !) useful system for any translation. Kind of a BabelFish API МSK3
Він також має всі уроки, що я маю з трьох десятиліть будування виробничих серверів & системи . Відміняючись від МSK2 кодів, щоб сказати клієнту відключити МSK3 повертання метадань про переклади, щоб допомогти клієнтам МСК4 додаткові кінцеві точки, щоб отримати більше даних і сторінка демонстрації що дозволяє мені в процесі розвитку, як і вам, мати гру
Я написав цілу систему для того, щоб це сталося з дивовижним проектом під назвою EasyNMT. Якимось чином, якщо ви тільки-но перевірили те репо, яке знаєте там ' є проблемою МSK3 це МSK4 не було торкано протягом декількох років M SK5 ЦеM SK6 простий , швидкий спосіб отримати API для перекладу без потреби платити за певну послугу або запускати повний MSC8 розмір LLM, щоб отримати переклад Mska9 повільно Mska10
У наших попередніх постах, ми обговорювали те, як інтегрувати EasyNMT з ASP.NET-приложениями для фонового перекладуM SK2 Але з часом , розриви почали проявлятисяMSC4 Настав час для чогось кращого
Як зазвичай, все це' доступно на GitHub і є безкоштовною для використання і т.д.


Демо...гляньте пізніше на демо-сторінкуM SK1
Цілковита інтерактивна демонстраційна сторінка (mostly) (at http://<server>:<port>/demo або просто корінь)
Що це таке?
Перед тим, як ми зануримося у швидкий старт
Найвизначніші aktualiзації (vM SK1 - Розвідка МSK3 Прозорість
Новое в v3.1: Найновіша версія додає значних покращень надійності, видимості ефективностіM SK1 і інтелектуального вибору моделей!
1. Смарт-модель Caching з видимістю - Подивіться, що саме відбувається
- ✓ Rejestrування Cache HIT:
Reusing loaded model for en->de (3/10 models in cache) - ✗ Запис Cache MISS:
Need to load model for en->fr (3/10 models in cache) - Переслідування статусу キャッシュа: Показує відсоток використання та завантажені моделі
- Застереження про виведення: Виczyść попередження, коли кэш повний і моделі викидають
- Збільшена пропускна спроможність: По замовчуванню розмір кэшу збільшується до 10 моделей МSK2 з МSK3
- Записування моделей пристроїв Per-: Подивіться, яку GPU використовує кожен модель
2. Поширений прогрес завантаження - Нічого більше не цікавить, чи він застряг
- Размер перед загрузкою: Показує загальний розмір загрузки (e.gM SK3 МSK4Сточний розмір МSK5 | | GB | ")
- Перерахунки файлів: Показує число файлів, які потрібно завантажити
- Дисплей пристрою: Показує ціле urządzenie (GPUM SK2CPUМSK3 у баннері
- Стовпчики прогресу: Красивий прогрес tqdm для кожного файлу ( коли на TTY)
- Баннер завершення: Виczyść повідомлення про успіх, коли модель готова
- До прикладу::
====================================================================================================
  🚀 DOWNLOADING MODEL
  Model: facebook/mbart-large-50-many-to-many-mmt
  Family: mbart50
  Direction: en → bn
  Device: GPU (cuda:0)
  Total Size: 2.46 GB
  Files: 6 main files
====================================================================================================
[Progress bars for each file...]
====================================================================================================
  ✅ MODEL READY
  Model: facebook/mbart-large-50-many-to-many-mmt
  Translation: en → bn is now available
====================================================================================================
3. ДаніM SK1Driven Intelligent Pivot Selection - Ніяких незрячих спроб
- Розумна логіка перетинів: знаходить мови, де існують обидві ноги повороту
- Уникають невдачливих спробМSK0 Виграв ' не спробував → це МSK3 млрд, якщо це ’ МSK4 ’ млрд не існує
- До прикладу: en→bn:
[Pivot] Languages reachable from en: 85 languages [Pivot] Languages that can reach bn: 42 languages [Pivot] Found 38 possible pivot languages [Pivot] Selected pivot: en → hi → bn (both legs verified) - Приоритет відхилення: Англійська → Іспанська МSK2 Французька
- Прозоре журналування: Подивіться, чому кожен поворот був обраний або пропущен
4. Установлений автоматичний зворотній спуск - Жодного подвійногоМSK1тривалостіM SK2
- І завжди намагається відхилятися: Навіть якщо вибрана сім 'я " повинна МSK2 підтримувати пару
- Один спроба на сім 'ю: Жодного повторення однієї моделі двічі
- Наприклад, поток:
Request: en→bn with opus-mt
Trying families: ['opus-mt', 'mbart50', 'm2m100']  ✓ All three!
opus-mt: Failed (model doesn't exist)
mbart50: Success! (auto-fallback worked)
5. Прозорість GPU - Зрозумійте, де є ваші моделі
- Кожна навантаження моделі показує:
Loading mbart50 model on GPU (cuda:0) - Після навантаження підтверджує:
Model loaded on device: cuda:0 - Сообщение про успіх включає в себе:
Successfully loaded... on GPU (cuda:0)
6. Півот-модель Caching - Швидка повторна використання pivot
- Обидві ноги винта відокремлені від інших:
en->hi,hi->bn - Наступного разу: en→hi or hi →bn neededM SK2 миттєвий кэш hit!
- Виczyść журналування:
[Pivot] Both legs loaded and cached. Ready to translate.
7. За МSK1Попроси вибрати модель - Вже працює в демоM SK1
- Випадок демонстрації дозволяє вибрати опуст-mt, mbartM SK2 або mMST3mMSC4
- Повага до зворотнього кінця
model_familyпараметр за запит - Моделі відокремлені сім 'єю для миттєвого переключення
Найвизначніші aktualiзації (vM SK1
1. Удосконалена сторінка демонстрації - Produkція - готовий інтерактивний інтерфейс M SK2
- Полний порт зору (100vw/100vhM SK2 для ефективного досвіду перекладу
- Правильно спроектовані від dropdowns (не більше заплутаних данихM SK1писок данихМSK2
- Перемикання сім 'ї живих моделей (Opus-MTM SK2 mBARTMSC3 MMska4MMske5
- Дальне завантаження мови на основі wybraneї моделі
- Рухливі вихідні ділянки для великих перекладів
2. Производительність -Optimовані domyślne МSK0 " Найшвидше, наскільки це можливо МSK2 виходити з коробки :
- ҐПУМSK0 FP16 включеноM SK2 BATCH_SIZEMST4 MAXMSC5INFLIGHTMSSK6 MS(optimal for single GPU )
- Процесор: WEB _ Конкуренція МSK2 MAX \ _ \ INFLIGHT =4, \ BATCH
- Гвидкий відключенняМSK0 5-секундний приголомшливий тайм-аут МSK2не більше
- Контейнери плавно зупиняються без жахливих повідомлень SIGKILL
3. Оптимізація виробництва - Меньше , швидші зображенняM SK2
- Утворили залежність від тесту (pytest, pytestM SK2covMSC3 з будівок виробництва
- Заpisує ~200MB на зображення
- Зображення процесора: M SK1GB (повне), | | МSK4GB
- Зображення з GPU: МSK1ГБ МSK2повнеM SK3 ♫ ~6-8ГB ♫ МSK5мин ♫
- Все використовувати
requirements-prod.txtдля мінімального відбитка
4. Комплексне тестування МSK1 Тестування навантаження - Впевнитися, що все
- Програмне забезпечення тестування API МСК0 тестиМSK1 для здоров 'яМСК2 перекладМ СК3 виявленняMСК4 відкриття
- k6 тестування завантаження з реалістичними схемами руху
- Кроссові скрипти для перевірки platform (PowerShell + BashM SK2
- Тести на завантаження моделей та зворотний відхилення від перекладу
- Автоматизовані тести на дим для швидкої перевірки
5. Документація для запуску МСК0 ProdukціяМSK1 готова з першого дня:
- 4 сценарії налаштування : Макс. пропускна спроможність МSK2 Низка траєкторія часу M SK3 висока конкуренція
- Докер Створити приклади з конфігураціями GPU/CPU
- Kubernetes manifests with PVC, resource limitsM SK1 health checks
- Ось приклади Azure Container Instances
- Руководство щодо тестування та рекомендації щодо контролю
- Конкуренція з торгами пропускною спроможністю
6. Три родини моделей - Виберіть те, що найкраще під ваші потреби
- Opus-MTМSK0 1200+ париM SK2 найкраща якість МSK3паратні моделі )
- mBART50МSK0 50 мовиM SK2 одиниці МSK3 модель GB , | МSK5 пари
- ММSK0M100МSK0 100 мовиM SK2 одиниці МSK3 модель GB , | МSK5 пари
7. АвтоM SK1Fallback - Розумно вибирає найкращу модель, доступну
- Установити первинну сім 'ю (eM SK1g., OpusMSC3MT для якостіMスク4
- Автоматично перевіряє mBART50/MM SK1M\100, якщо пара недоступна
- Максимальний потік, не втрачаючи якості
8. Модель відкриття - Модельи, які доступні динамічно
/discover/opus-mt- Всі пари 1200+ від Hugging Face/discover/mbart50- Всі пари mBARTM SK1/discover/m2m100- Всі пари MM SK1MMSC2
9. Minimalні зображення - МеньшеM SK1 гнучкі введення :
- Ніхто не завантажив моделей (загрузити наM SK1побажання)
- Том- відображає persistent cache
- Перемикайте родини моделі без перебудови
10. Єдиний Докерний Репозитор - Всі варіанти в одному місці
scottgal/mostlylucid-nmt:cpu( або:latestМSK0 - Процесорscottgal/mostlylucid-nmt:cpu-min- мінімальний процесорscottgal/mostlylucid-nmt:gpu- GPU з CUDA 12.6scottgal/mostlylucid-nmt:gpu-min- Minimalний GPU
11. Правильна версія - Усі зображення включають версії на даний час
- Наименовані ярлики (
latest,min,gpu,gpu-min) завжди вказує на найновішу будівлю - Невідмінні значки для версії (e.gM SK2
20250108.143022) для з 'єднування конкретних будівель - Повні ярлики OCI для відстежування версій, дата побудовиM SK1 та комп 'ютерних комп' ютерів
12. Останні базові зображення - Удосконалення безпеки та ефективностіM SK1
- Python 3.12-slim для зображення процесора (адреси Python МSK1 нестабільностіM SK2
- ЦUDA 12.6 з Убунту 24.04 для зображення графічного процессора (недавній стег NVIDIA МSK2
- PyTorch з CUDA 12.4 (совладна з CUDA 12.6 тривалість запуску
- Усі залежності оновлені до останніх безпечних версій
13. Застежені попередження загрози - Майбутнє - непошкодливіM SK2
- Вибрані недоречні перетворники_CACHE ( тепер за допомогою HFM SK2HOME)
- Kompatibilна з трансформаторами v5
Швидкий старт (5 MinuтиM SK1
Хочете просто отримати переклад? Тут ' найпростіший спосіб запуску
Доступні зображення Докера
Всі варіанти доступні з один репозитор з різними ярликами:
| Метка МSK1 Полне ім 'я зображення | МSK2 | Размер | Описание | |||
|---|---|---|---|---|---|---|
cpu ( або latest) |
scottgal/mostlylucid-nmt:cpu МSK0 ~2.5 ГБ МSK2 Процесор з кодом вихідним |
Розгортання обчислювальної процесора | ||||
cpu-min |
scottgal/mostlylucid-nmt:cpu-min МSK0 ~1.5 ГБ МSK2 Minimalний розмір процесора , без попередньо завантаження моделей M SK4 Об 'єм - макетований кэш MSC6 гнучкий |
|||||
gpu |
scottgal/mostlylucid-nmt:gpu |
МSK1ГБ МSK2 ГПЗ з CUDA 12.6 ♫ ♫ МSK4 ♫ джерело ♫ | ♫ Розгортання обчислювальних ҐПЗ для виробництва ♫ | |||
gpu-min |
scottgal/mostlylucid-nmt:gpu-min МSK0 ~4 ГБ МSK2 Minimalний розмір GPU , без моделей, які завантажені до комп 'ютера |
Найменші зображення рекомендують для:
- Розгортання виробництва з об 'ємом
- Використовуючи mBART
- Залишити розмір контейнера невеликим
- Можливість переключати сімейні моделі без перебудови
Найпростіший старт (Opus-MT CPUM SK2
1. Притягніть і запустітьM SK1
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  scottgal/mostlylucid-nmt
2. Перевести якийсь текст
curl -X POST "http://localhost:8000/translate" \
  -H "Content-Type: application/json" \
  -d '{
    "text": ["Hello, how are you?"],
    "target_lang": "de"
  }'
Відповідь:
{
  "translated": ["Hallo, wie geht es Ihnen?"],
  "target_lang": "de",
  "source_lang": "en",
  "translation_time": 0.34
}
Пришвидшений GPU (10x швидшийM SK1
Потрібний NVIDIA Docker runtime:
docker run -d \
  --name mostlylucid-nmt \
  --gpus all \
  -p 8000:8000 \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu
З довготривалою моделью
Скачаймо моделі один раз і тримаємо їх над контейнером.
Linux/Mac:
docker run -d \
  --name mostlylucid-nmt \
  -p 8000:8000 \
  -v $HOME/model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  scottgal/mostlylucid-nmt:cpu-min
Windows (PowerShell):
docker run -d `
  --name mostlylucid-nmt `
  -p 8000:8000 `
  -v ${HOME}/model-cache:/models `
  -e MODEL_CACHE_DIR=/models `
  scottgal/mostlylucid-nmt:cpu-min
Windows (CMD):
docker run -d ^
  --name mostlylucid-nmt ^
  -p 8000:8000 ^
  -v %USERPROFILE%/model-cache:/models ^
  -e MODEL_CACHE_DIR=/models ^
  scottgal/mostlylucid-nmt:cpu-min
Моделі завантажуються автоматично після першого використання і зберігаються у вашому локальному каталогі!
перевірка здоров 'я:
curl http://localhost:8000/healthz
МSK0 - це МSK1 хвилинний швидкий старт ! Для розгортання виробництва , конфігурація
Ця інтерактивна демонстраційна сторінка
Даний сервіс має повну функцію інтерактивна демонстраційна сторінка що дає змогу легко перевірити tłumaczenia без написання коду
http://localhost:8000/demo/
Веб-страна для демонстрації надає повне середовище тестування перекладу з:
1. Вибір мови
- Auto-вказівки на населені мови з онлайн-сервісу
- Swap source/target languages with one click
- Obsługа всіх мов 100+, конфігурованих у службу
2. Розумний текстовий синтез
- Автоматично обробляє великі текстові вхідні дані будь-якого розміру
- Інтелектно розділяється за абзацами, зберігаючи структуру dokumentu
- Повертається до поділу речень на дуже довгі абзаци
- Показує прогрес у перекладах -chunk1Translating chunk МSK2
- Непошкодливо реорганізує шматки з відповідною відстані
3. Виявление мови
- Визначати джерело мови одним кліком
- Автоматично заповнює вихідний код
- Работає з текстом до символів 5000
4. Заawansовані варіанти
- Розмір промені: Контроль якості перекладу
- Вищі значення = кращий рівень якості, але повільніше
- Нижчі значення = швидший пропускна спроможність
- Розділ речення: Перемикати автоматичне розділення речень
- Ввімкнуто (defaultM SK1 розділяє довгі тексти на речення для кращої якості
- Неможливе: Переводить цілий текст в один блок МSK1швидше для коротких текстів
МSK0 Реальний-Статистика часу
- Час перекладу: Показує справжній сервер
- Число символів: Перерахунки наживо, як ви набираєте
- Індикатор статі: Неактивний → Перевод МSK2 ЗавершенийM SK3Error
6. Модель Family Discovery
- Познайомтеся з доступними парами перекладів для кожної родини моделей:
- Opus-MT: МSK1 мовні пари
- mBART50МSK0 50 мов
- ММSK0M100МSK0 100 мов
- Дивіться, які пари мов доступні перед перекладом
Як текстовий друк працює
Демо реалізує штучне відокремлення тексту з боку клієнта:
// Example: Translating a 5000-word article
Input: Long article with multiple paragraphs

Step 1: Split by paragraphs (preserves structure)
  → Paragraph 1 (800 chars)
  → Paragraph 2 (1200 chars)
  → Paragraph 3 (600 chars)
  ...

Step 2: Group into ~1000 character chunks
  → Chunk 1: Paragraphs 1-2
  → Chunk 2: Paragraph 3-4
  → Chunk 3: Paragraphs 5-6

Step 3: Translate each chunk sequentially
  → Shows progress: "Translating chunk 1/3..."
  → Shows progress: "Translating chunk 2/3..."
  → Shows progress: "Translating chunk 3/3..."

Step 4: Reassemble with paragraph breaks
  → Final output: Complete translated article with preserved formatting
Чому використовувати Demo?
швидке тестування
- Випробувати переклади без написання коду
- Проверити доступність мовних пар
- Порівняйте якість перекладу з різними розмірами промені
- Випробовуємо крайні cases (еmoji, символиM SK2 особливі символи
Допоможність розвитку
- Подивіться на конкретний API запит/формат відповіді
- Перевірити стан здоров 'я служби перед інтеграцією
- Випробувати ефективність з різними розмірами тексту
- Відкрийте доступні моделі сімей
Відповідь клієнта
- Показує правильні шаблони використання API
- Демонструє подолання помилок (429, розпізнавання мовиM SK1
- Наприклад, застосування блокування
- Реальний-логіка пробування світу
Наприклад, використання
Простій переклад:
- Поміщайте текст: M SK1 Привіт, Як ви сьогодні?
- Виберите ціль: німець
- Нажмите "ПеревестиM SK1
- РезультатМSK0 "Здоров 'я МSK2 wie geht es Ihnen heuteM SK3
Довгий переклад dokumentu:
- Завішіть цілий блог (5000+ словаM SK1
- Демо автоматично перетворює його на оброблені шматочки
- Показує прогрес, як кожен шматок перекладає
- Возв 'язує повністю перекладений документ
Розпізнавання мови:
- Помістити текст на невідомому мові
- Нажмите "Визначати мовуM SK1
- Демо ідентифікує мову і запускає поновлення
- Готовий негайно перекласти
Технические деталі
Веб-страна для демонстрації - ":".
- Самодостатній-: Одноразовий HTML-файл з вбудованим JavaScript
- Нуль залежності: Ніхто не потребує зовнішньої бібліотеки
- Мобільна дружба: Відповідальний дизайн працює на всіх приладах
- Готова виробництво: Таку ж логіку відокремлення можна використовувати в ваших програмах
Доступ до живої демонстрації на /demo/ на вашому прикладі!
Проблеми з EasyNMT
Тепер це не dumping на EasyNMT він нічого не міг зробити, і я збудував Багато проектів користуються ним.МSK0 Це ' просто стає довгою в зубі, тож МSK2 які проблеми ми маємо ?
О, мій МСК0 там МSK1 багато . EasyNMT було збудовано майже десять років тому МКС3 Технологія перейшла на МКС4 плюс він ніколи не мав наміру бути виробництвом МСС5 система рівня МСК6 Ось деякі проблеми МПС7
- Він скасується...a LOTM SK1 Це не для того, щоб відновлюватися від проблем, так часто просто падає над
- МSK0 - це SUPER PICKY щодо свого введення Емотики МСК0 символи МSK1 навіть цифри можуть його заплутати .
- Він не przeznaczony для будь-якого навантаження Розгляньте вище. Він ніколи не був розроблений для того, щоб бути
- МСК0 не був розроблений для оновлення своїх моделей або бути (легкоМSK1 збудованим з вбудованогоM SK2в моделіх.
- Його графічний процессор CUDA стародавній так повільніше, ніж потрібно
- Ви можете нічого не виправити. Код Python є на репо, але знову не дуже.
- Немає зворотнього тиску чи черги. Посилати надто багато запитів, і це просто заважає
- Немає можливості спостереження. Коли все йде не так, ви летите сліпо.
Рішення: Найчастіше люцидніM SK1NMT
Тож я вирішив побудувати новий і покращений EasyNMT найбільш зрозуміле-nmt. Це не МСК1, це не просто робота на патчу, МСК2, це МСК3, це повна переробка, думаючи про використання для виробництва. МСК4, ось тут МСК5, що робить його кращим
Multi-Model Family Support
НайчастішеLucid-NMT тепер підтримує три родини моделей перекладу, дає вам гнучкість, враховуючи ваші потреби
ОпусМSK0МТ (ХельсинкиM SK2НЛПМ SK3 МSK4 По замовчуванню
- Покрытие: Пара перекладів для мов 150+
- Архітектура: Відокремлена модель за напрямок перекладу
- Якість: Найкраще в цілому якість перекладу
- Використовуйте Cas: Режиссерські переклади, коли йдеться про якість
- Розмір моделі: 300-500MB за напрямок
- Наприклад: Англійська→Германська - інша модель, ніж німецька
mBART50 (FacebookM SK2
- Покрытие: МSK0 мови, всіM SK2 до- усі переклади
- Архітектура: Єдина багатомовна модель
- Якість: Хороша якість, особливо для основних мов
- Використовуйте Cas: Космічний простір- обмежені запуски або багато мовних пар
- Розмір моделі: МSK0ГБ (одинковий модель для всіх МSK2 мов
- перевага: Одна модель працює з парами перекладів 2,450
ММSK0M100 M SK2Facebook)
- Покрытие: МSK0 мови, всіM SK2 до- усі переклади
- Архітектура: Єдина багатомовна модель
- Якість: Хороша якість з найширнішою мовами
- Використовуйте Cas: Максимальна мова
- Розмір моделі: МSK0ГБ (одинковий модель для всіх МSK2 мов
- перевага: Одна модель працює з парами перекладів 9,900
Перемикання легко - просто встановив MODEL_FAMILY змінна середовища:
# Opus-MT (default, best quality)
MODEL_FAMILY=opus-mt

# mBART50 (50 languages, single model)
MODEL_FAMILY=mbart50

# M2M100 (100 languages, broadest coverage)
MODEL_FAMILY=m2m100
Автоматичний модель сім 'ї Fallback - NEWM SK1
Одна з найпотужніших нових властивостей - автоматичний зворотній зв 'язок між моделями сімей. Це гарантує максимальное поширення мовних пар, в той час як пріоритетність якості перекладуM SK1
Як це працює:
- Ви встановили
MODEL_FAMILYМSK0e.gM SK2opus-mtдля кращої якості) - Якщо ви запропонуєте переклад, який не доступний у головній сім 'ї
- Система автоматично перевіряє наступну сім 'ю у зворотньому порядку
- Це триває, доки не знайдеться відповідний модель
Прикладний сценарій:
# Set primary to Opus-MT (best quality)
MODEL_FAMILY=opus-mt
AUTO_MODEL_FALLBACK=1
MODEL_FALLBACK_ORDER=opus-mt,mbart50,m2m100

# Request Ukrainian → French
# 1. Try Opus-MT first (not available)
# 2. Automatically fall back to mBART50 (available!)
# 3. Translation succeeds with mBART50
Прибутки:
- Максимальна поява: Obsługа мов 100+ без управління численними депозиціями
- Якість пріоритету: І завжди використовує найкращу модель для кожної пари
- Нульова konfigurація: Робиться автоматично, не потрібна ручна допомога
- Прозоре журналування: Подивіться, яку модельну сім 'ю використовували для кожного перекладу
Konfiguracja:
# Enable auto-fallback (default: enabled)
AUTO_MODEL_FALLBACK=1

# Set fallback priority (default: opus-mt → mbart50 → m2m100)
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"

# Disable for strict single-family mode
AUTO_MODEL_FALLBACK=0
Ця функція ідеальна для виробничих середовища, де ви хочете мати максимальное покрытие, не втрачаючи якості!
Найголовніше покращення
- Multi-модель сімейної підтримки - Вибирати з OpusM SK1MT (1200+ пари), mBARTMSC4 МSK5 мовиMska6 або MMske7MM Ska8 | МSK9 мови | .
- Ідентичні точки відкриття моделей - Динамично запитувати доступні моделі Hugging Face для кожної сім 'їM SK1
- Надійні вхідні дані - ЕмоїкиМSK1 НомериMSC2 СимволиМСК3 Навімкніть на неїMСК4 Услуга тепер включає в себе комплексне очищування входу та замаскування символівМ СК5
- Вимагати черги і зворотнього тиску - Сконструйований МSK1 в семафорі МSK2 базується на чергах з розумним повторенням - після підрахунку \ .
- Камера LRU - Автоматично управляє VRAM, викидаючи старі моделі, коли кэш заповнюється
- Сучасна підтримка CUDA - Використовує PyTorch з CUDA 12.6, підтримує FP16/BFMSC3 для МSK4x покращення швидкостіM SK5
- Produkція- Готова обсервабельність - перевірки здоров 'яM SK1 тести на готовність , статус кэшу МSK3 структурне завантаження .
- Гарний відключення - Ніяких сиротних запитів чи корумпованих держав
- Зручний інтерфейс API - Drop - в замінні для існуючих інтеграцій
- Відхилення від перекладу - Якщо не існує прямого мовного пару, ' не доступна, МSK2 автоматично переводить через англійську мову. МSK3 або вибраний поворот.
- Minimalні зображення Докера - Нова
-minваріанти з об 'ємом- картований кэш для менших застосуваньM SK1
Чому NMT більше LLM для перекладу?
Ви можете подумати:: M SK1Чому використовувати dedykowanу службу NMT, коли LLM, як-от GPTMSC2 Claude, чи Llama можуть перекладати?
Швидший
NMT ( найбільш яскравий МSK1nmtM SK2
- CPU: M SK1 секунд на речення
- GPU (FPM SK1 ~0.05-0.2 секунд на речення
- Batch processing: M SK1 sentences/second on GPU
LLMs:
- GPT-4: M SK1 секунд на żądaння ( API затримка МSK3 генерація
- Llama 3 70BM SK2 | | 3 | секунди на речення | 4 | локальний | 5 |
- Claude 3: 2-8 секунд за запитом МSK2 API затримкаM SK3
Справжній приклад: Перекладання блогу 1000-слова
- найбільш зрозуміле-nmt (GPUM SK2МSK0 5-10 секунд
- API GPT-4МSK0 30-60 секунд
- Місцевий Ллама 70BМSK0 2-5 хвилин
Коли ви перекладаєте сотні блогових постів на мови 12+ ,, різниця в швидкості дуже велика
Розмір моделі: M SK1MB проти 140GB
Моделі NMT:
- Опус-MT M SK1по напряму): 300-500MB
- mBART50 M SK1все 50 мови
- ММSK0ММСК1 М СК2все MСК3 мови
- Загалом для мов 100+
LLMs:
- Ллама МSK0 8BM SK2 ≥~16ГБ
- Ллама МSK0 70BM SK2 ≥~140ГБ
- Мекстраль 8xM SK1B: ~90GB
- GPT-4: Не доступна для self-hosting
Вплив на зберігання:
# NMT: Fits on a USB stick
du -sh model-cache/
2.5G    model-cache/

# LLM: Needs serious storage
du -sh llama-models/
140G    llama-models/
Побажання ресурсів: Laptop vs Server Farm
Розгортання процесора NMT:
- Працює добре на: M SK1 ядрами процесора, \4 ГБ оперативної пам 'яті
- зображення дронта: M SK1ГБ
- Інференція: лише CPU , не потребує GPU
- ВартістьМСК0 МSK1місяця
Побажання LLM:
- Llama 3
- Менькі моделі 7BM SK1B МSK2 Все ще 16-32 Minimalний розмір оперативної пам 'яті
- Kosztи API : $0.03-0.30 за МSK2 टोकони МSK3 збільшується швидко M SK4
- Самої-hosting: M SK2month для серйозного GPU
Справжнє порівняння витрат на 10,000 блогові переклади:
| Metodа МSK1 Вартість МSK2 Час | |||
|---|---|---|---|
| більш-менш яскраво зрозумілаM SK1nmt | |||
| переважно яскравоіM SK1nmt МSK2ГПЗ МSK3 M | \ $50/місячна ГПЗ VPS МСК6 | МSK7 хвилини \ МSK8 | |
| ГПЗ МSK1 API МSK2 $150-300 | |||
| Claude API МSK1 МSK2 ♫ ♫ | ♫ | ||
| Местна Лама МSK1B МSK2 $1000+/місячне обладнання M | МSK5 години МСК6 |
Якість: ЦільМSK1 Побудований проти OgólnогоM SK2Цель
Сила NMT:
- Треновані спеціально для перекладу
- Сpójна якість ( той самий вхід = той же виход МSK2
- Ні. " галюцинаціїM SK1 МSK2 чистий переклад
- Дозволяє добре форматувати технічну zawartość, кодM SK1
- Не потрібна швидка інженерія
Проблеми LLM:
- ⚠️ Іноді додає інтерпретації, які не є в оригінальному
- ⚠️ Якість змінюється з швидким формулюванням
- ⚠️ Може бути МSK1творючоюM SK2 з технічними умовами
- ⚠️ Потрібна ретельна швидка інженерія
- ⚠️ Непередбачувані з краями
Прикладний сценарій:
Input: "The API returns a 429 status code when rate limited."

NMT (Opus-MT): "Die API gibt einen 429-Statuscode zurück, wenn sie ratenbegrenzt ist."
(Accurate, preserves technical terms)

LLM (might do): "Die API sendet den Fehlercode 429, wenn zu viele Anfragen gestellt werden."
(Interprets rather than translates, adds context not in original)
Коли використовувати кожен
Використовуйте NMT (mostlylucidMSL1nmtM SL2 колиMsl3
- Вам потрібен послідовний, швидкий переклад в масштабі
- Budget matters (selfM SK1hosting or high volume)
- Ви' перекладаєте технічну інформаціюM SK1 код, структуровані дані
- Ви маєте детермінативний вихід: ( той самий вихід:
- Ви хочете працювати на ЦПЗ або скромному апараті
- Ви – МСК0 – будуєте автоматизовані труби перекладу
Використовуйте LLM, коли:
- Вам потрібна творча адаптація, не переклад
- Контекст та культурні нюанси важливі більше, ніж швидкість
- Ви робите низькі МСК1 об 'єм МSK2 один - без перекладів
- Вам потрібно перекласти + підсумувати + переписати в один крок
- Ви не проти змінних витрат і повільнішого обробки
На нижній лінії
Для Автоматичний переклад блогів ( мій пристрій для використання ), НМТ є чіткого переможцем МSK2
- Перекладає блогові записи на мови 12 в МSK2 хвилини
- Працює на $50/місячному VPS
- Сpójна якість на всіх посадах
- Уся установка: Один контейнер для докерів
Випробовування цього з LLM коштуватиме сотні доларів на місяць за тарифи API або потребувати $2000+ GPU сервер для самої -host. Різниця в швидкості робить NMT єдиним практичним вибором для виробництва трубок перекладу
TL;DRM SK1 NMT має на меті- збудований для перекладу , працює на скромній комп 'ютері МSK2 і є МSK3x швидшим, ніж LLMs. Якщо вам потрібен швидкийM SK5 послідовний M SK6 вартість - ефективні переклади в масштабах MSC8 NMT перемагає
Уявлення про архітектуру
flowchart LR
    A[HTTP Client] --> B[API Gateway]
    B --> C[Translation Endpoint]
    C --> D{Has Capacity?}
    D -->|Yes| E[Translation Service]
    D -->|No| F[Queue with 429]
    F --> E
    E --> G[Process Pipeline]
    G --> H[Get Model from Cache]
    H --> I[Translate]
    I --> J[Return Response]
    J --> A
Показовий потік простий:
- Клієнт надсилає запит на переклад до API Gateway (Gunicorn + Uvicorn workers)
- Ґейтеві API маршрути до точки перетворення
- Перевірка можливостей: Система перевіряє, чи вона здатна виконувати завдання
- Так → Запрос негайно відправляється до Служби перекладу
- Ні → Запрос в черзі МSK1 klient отримує HTTP МSK2 з
Retry-Afterзаголовок
- Служба перекладу обробляє запит за допомогою трубопроводу:
- Інпутна санітарія і розділення речей
- Замаскування символів (еmojisM SK1 особливих символів
- Перетворення, використовуючи приховані моделі
- Викривання символів і процес обробки після-
- Модель (LRU) надає моделі перекладуM SK2
- Cache hit → швидка реакція
- Похибка → Завантаження з HuggingFace Hub
- Cache full → Auto-evict old modelsM SK2 clear CUDA memory
- Відповідь повертається до клієнта
Дизайн ключів: Механізм зворотнього тиску ( черга МSK1 HTTP 429) запобігає падінням під навантаженням МSK3 Коли переповнена мSK4 черги по службі просять замість того, щоб помирати M, даючи клієнтам розумний час повторного спроби через Retry-After заголовки.
Як це працює: Deep Dive
Подача потоку
Коли запрос на переклад приходить в ",", ось тут, МSK1 , що відбувається?
sequenceDiagram
    participant Client
    participant API
    participant Queue
    participant Translator
    participant Cache
    participant Model

    Client->>API: POST /translate
    API->>Queue: Acquire slot

    alt Queue has space
        Queue-->>API: Slot acquired
        API->>Translator: Process translation
        Translator->>Translator: Sanitize input
        Translator->>Translator: Split sentences
        Translator->>Translator: Chunk text
        Translator->>Translator: Mask symbols
        Translator->>Cache: Get model (en→de)

        alt Cache hit
            Cache-->>Translator: Return cached model
        else Cache miss
            Cache->>Model: Load from Hugging Face
            Model-->>Cache: Pipeline loaded
            Cache->>Cache: Evict old if at capacity
            Cache-->>Translator: Return model
        end

        Translator->>Model: Translate batches
        Model-->>Translator: Translations
        Translator->>Translator: Unmask symbols
        Translator->>Translator: Post-process
        Translator-->>API: Translations
        API->>Queue: Release slot
        API-->>Client: 200 OK + translations
    else Queue full
        Queue-->>API: Overflow error
        API-->>Client: 429 Too Many Requests\nRetry-After: X seconds
    end
Вхідна технологічна труба
Даний сервіс використовує складну багатоступенчату трубку, щоб працювати з нерозбірливою реальністю.
graph LR
    A[Raw Input] --> B{Sanitize?}
    B -->|Yes| C[Check Noise]
    B -->|No| D[Split Sentences]
    C -->|Is Noise| Z[Return Placeholder]
    C -->|Valid| D

    D --> E[Enforce Max Length]
    E --> F[Chunk for Batching]
    F --> G{Symbol Masking?}

    G -->|Yes| H[Mask Digits/Punct/Emoji]
    G -->|No| I[Translate]
    H --> I

    I --> J{Direct Model?}
    J -->|Available| K[Direct Translation]
    J -->|Not Available| L{Pivot Fallback?}

    L -->|Yes| M[src→en→tgt]
    L -->|No| Z
    K --> N[Unmask Symbols]
    M --> N

    N --> O[Remove Symbol Loops]
    O --> P[Join Chunks]
    P --> Q[Final Translation]
Вхідна санітарія
Однією з найбільших покращень є надійне введення даних.
Розпізнавання шуму:
- Сигнали управління стрічками (за винятком \t, МSK3nM SK4 \rMSC6
- Проверяє мінімальний відсоток символів (по замовчуваннюM SK1 МSK2
- Вираховує алфанійний відсоток (по замовчуваннюM SK1 має бути МSK2
- Відмовляє чисті емоції, чисте пунктуаціюM SK1 або чистий білий простір
Спеціальне масування символів: Чому символи масок? Моделі перекладу тренуються на текстіM SK1 не на емоціях чи особливих символах . Вони можуть їх заплутати або зруйнувати МSK3 Тому ми
- Витягніть всі цифри, пунктуаціюM SK1 і емоції як супутні запуски
- Заміняйте їх символами офіцера:
⟪MSK0⟫,⟪MSK1⟫, і т.д. - Перевести замаскований текст
- Відтворити оригінал символів на їхніх позиціях
Наприклад:
Input:  "Hello 👋 world! Price: $99.99"
Masked: "Hello ⟪MSK0⟫ world⟪MSK1⟫ Price⟪MSK2⟫ ⟪MSK3⟫"
                 (👋)        (!)      (:)    ($99.99)
Пошта-ПроцесуванняM SK1 Після перекладу ми видалили "symbol loopsM SK2 - повторювані символи, які не були
Source: "Hello world"
Bad translation: "Hola mundo!!!!!!!"
Cleaned: "Hola mundo"  # Removes the !!!! loop
Розділ речення &
Далі тексти розділяються розумно:
graph TD
    A[Long Text] --> B[Split on . ! ? …]
    B --> C{Sentence > 500 chars?}
    C -->|Yes| D[Split on word boundaries]
    C -->|No| E[Keep sentence]
    D --> E

    E --> F[Group into chunks ≤900 chars]
    F --> G[Translate each chunk]
    G --> H[Join with space]
Це гарантує
- Моделі не пошкоджують на величезних входах
- Ми можемо ефективно давати
- Контекст зберігається в межах раціональних кордонів
Модель Caching & Zarządzanie пам 'яттю
Cache LRU розумний щодо пам 'яті GPU:
stateDiagram-v2
    [*] --> CheckCache
    CheckCache --> CacheHit: Model exists
    CheckCache --> CacheMiss: Model not loaded

    CacheHit --> MoveToEnd: Update LRU order
    MoveToEnd --> ReturnModel

    CacheMiss --> CheckCapacity
    CheckCapacity --> LoadModel: Space available
    CheckCapacity --> EvictOldest: Cache full

    EvictOldest --> MoveToCPU: Free VRAM
    MoveToCPU --> ClearCUDA: torch.cuda.empty_cache()
    ClearCUDA --> LoadModel

    LoadModel --> AddToCache
    AddToCache --> ReturnModel
    ReturnModel --> [*]
Чому це важливо:
- Пам 'ять GPU цінна
- Моделі перекладу - 300-500MB кожен
- Завантаження моделей повільне (1-3 секундиM SK1
- Ми зберігаємо найновіші моделі 6 гаряче
- Старі моделі автоматично викидають
В черзі & Пришвидшений тиск
Замість того, щоб скасуватися під навантаженням, queues requests service
# Semaphore limits concurrent translations
MAX_INFLIGHT = 1  # On GPU, 1 at a time for efficiency
MAX_QUEUE_SIZE = 1000  # Up to 1000 waiting

# When full:
# - Returns 429 Too Many Requests
# - Includes Retry-After header
# - Estimates wait time based on average duration
Перепробування підрахунку є розумним:
avg_duration = 2.5 seconds (tracked with EMA)
waiters = 100
slots = 1
estimated_wait = (100 / 1) * 2.5 = 250 seconds
clamped = min(250, 120) = 120 seconds
Retry-After: 120
Перетворення на Пivot
Не всі мовні пари мають прямі моделі на Hugging Face
graph LR
    A[Ukrainian Text] --> B{Direct uk→fr?}
    B -->|Exists| C[Translate Directly]
    B -->|Missing| D[Pivot via English]

    D --> E[uk→en]
    E --> F[en→fr]
    F --> G[French Result]
    C --> G
Це збільшує затримку, але гарантує покрытие для всіх підключених мовних пар.
Код Deep Dive: Круто Explained
Дозвольте дослідити деякі з найцікавіших частин кодової бази! Це реальні моделі виробництва, які роблять сервіс надійним і ефективним.
1. Smart LRU Cache with GPU Memory Management
Однією з найкрутіших характеристик є інтелектуальна модельна кэша, яка знає, як керувати пам 'яттю GPU:
# src/core/cache.py
from collections import OrderedDict
import torch

class LRUPipelineCache:
    """LRU cache that automatically cleans up GPU memory when evicting models."""

    def __init__(self, capacity: int):
        self.cache = OrderedDict()  # Maintains insertion order
        self.capacity = capacity

    def get(self, key: str):
        """Get model from cache, moves it to end (most recently used)."""
        if key not in self.cache:
            return None
        self.cache.move_to_end(key)  # Mark as recently used
        return self.cache[key]

    def put(self, key: str, value):
        """Add model to cache, evicting oldest if at capacity."""
        if key in self.cache:
            self.cache.move_to_end(key)
        else:
            self.cache[key] = value

        # If cache is full, evict the oldest model
        if len(self.cache) > self.capacity:
            oldest_key, oldest_pipeline = self.cache.popitem(last=False)

            # MAGIC: Move evicted model to CPU to free GPU memory
            try:
                oldest_pipeline.model.to("cpu")
                if torch.cuda.is_available():
                    torch.cuda.empty_cache()  # Tell GPU to release memory
                logger.info(f"Evicted {oldest_key}, freed GPU memory")
            except Exception as e:
                logger.warning(f"Failed to clean GPU memory: {e}")
Що тут відбувається?
OrderedDict: Як у звичайному словникуM SK1 але пам 'ятає, що додалося замовлення- LRU (Скоріш за все, що було використано: Коли кэш заповнюється, , викидає модель, яку не використовували впродовж найдовшого часу
- Обновлення GPU: Коли ми виїжджаємо з моделі ,, ми explicitly переміщуємо її до пам 'яті процесора і кажемо GPU звільнити свої ресурси
- Чому це важливо?: Без цього , пам 'ять GPU заповнюватиметься і скасується після завантаження МSK2 моделейM SK3
2. Автоматичний модель сім 'ї
Ця розумна властивість автоматично намагається запропонувати багато моделей штучного інтелекту, якщо перша не має'пауэр мови, який вам потрібенM SK1
# src/services/model_manager.py
def get_pipeline(self, src: str, tgt: str):
    """Try to get translation model, with automatic fallback to other providers."""

    # Determine which model families support this language pair
    families_to_try = []

    if config.AUTO_MODEL_FALLBACK:
        # Try families in priority order: opus-mt → mbart50 → m2m100
        for family in config.MODEL_FALLBACK_ORDER.split(","):
            if self._is_pair_supported(src, tgt, family.strip()):
                families_to_try.append(family.strip())

    # Try each family until one succeeds
    last_error = None
    for family in families_to_try:
        try:
            model_name, src_lang, tgt_lang, _ = self._get_model_name_and_langs(src, tgt, family)

            if family != config.MODEL_FAMILY:
                logger.info(f"Using fallback '{family}' for {src}->{tgt}")

            # Load the model from HuggingFace
            pipeline = transformers.pipeline(
                "translation",
                model=model_name,
                device=device_manager.device_index,
                src_lang=src_lang,
                tgt_lang=tgt_lang
            )

            self.cache.put(f"{src}->{tgt}", pipeline)
            return pipeline

        except Exception as e:
            last_error = e
            logger.warning(f"Family '{family}' failed for {src}->{tgt}: {e}")
            continue  # Try next family

    # All families failed
    raise ModelLoadError(f"{src}->{tgt}", last_error)
Що тут відбувається?
- Бажаний ланцюг: Якщо в Опусі не буде украинськогоM SK1MT не будеUkrainiйського →Французського МSK4 автоматично спробувати mBART50, тоді MMSC6MMスク7
- Немає ручного втручання: Пользовачі просто просять переклад і отримують найкращу доступну модель
- Помилка в обробці: Якщо всі сім 'ї зазнають невдачі , ми викидаємо чітку помилку з останнім причиною невдач
- Смарт-качування: Успішні моделі зберігаються в кэші з ключем для мовних пар
3. Показ Queue з зворотним тиском МSK1HTTP 429
Produkція- сортування в чергах, що запобігає падінням сервера під навантаженням
# src/services/queue_manager.py
import asyncio
from contextlib import asynccontextmanager

class QueueManager:
    """Manages request queuing and backpressure."""

    def __init__(self, max_inflight: int, max_queue: int):
        self.semaphore = asyncio.Semaphore(max_inflight)  # Limit concurrent translations
        self.max_queue_size = max_queue
        self.waiting_count = 0
        self.inflight_count = 0
        self.avg_duration_sec = 5.0  # Exponential moving average

    @asynccontextmanager
    async def acquire_slot(self):
        """Try to get a translation slot, track metrics, handle queueing."""

        # Check if queue is too full
        if self.waiting_count >= self.max_queue_size:
            # Calculate how long client should wait before retrying
            retry_after = self._estimate_retry_after()
            raise QueueOverflowError(self.waiting_count, retry_after)

        self.waiting_count += 1
        try:
            # Wait for available slot (this is the queue!)
            await self.semaphore.acquire()
            self.waiting_count -= 1
            self.inflight_count += 1

            start_time = time.time()
            yield  # Let the translation happen

            # Update average duration for retry-after estimates
            duration = time.time() - start_time
            alpha = config.RETRY_AFTER_ALPHA  # Smoothing factor (0.2)
            self.avg_duration_sec = alpha * duration + (1 - alpha) * self.avg_duration_sec

        finally:
            self.inflight_count -= 1
            self.semaphore.release()

    def _estimate_retry_after(self) -> int:
        """Smart calculation: how many waiting / how many slots * avg time per request."""
        if self.inflight_count == 0:
            return config.RETRY_AFTER_MIN_SEC

        # If 10 people waiting and 2 slots available, and each takes 5 seconds:
        # retry_after = (10 / 2) * 5 = 25 seconds
        retry_sec = (self.waiting_count / self.semaphore._value) * self.avg_duration_sec

        # Clamp between min and max
        return max(
            config.RETRY_AFTER_MIN_SEC,
            min(int(retry_sec), config.RETRY_AFTER_MAX_SEC)
        )
Що тут відбувається?
- Семафор: Як гравець у клубі МSK1 дозволяє людям тільки ввійти в один раз
max_inflight) - Менеджер контексту (
@asynccontextmanager): Автоматично відстежує показники і очищає - Розумна спроба-за: Кажуть клієнтам МSK1 повертаються в МSK2 секунду " залежно від глибини черги та середнього часу запити
- Експоненційний середній рух: Розріджує піки в проміжку часу запиту
- Чому це важливо?: Під сильною навантаженнямM SK1 повертає HTTP 429 замість того, щоб скасувати або чергати нескінченно
4. Символ-маскинг магії
Захищає особливих символів (емозікиM SK1 символи ), які можуть зруйнувати моделі перекладу
# src/utils/symbol_masking.py
import re

def mask_symbols(text: str) -> tuple[str, dict[str, str]]:
    """Replace special symbols with placeholders before translation."""

    originals = {}
    masked_text = text
    placeholder_counter = 0

    # Pattern: Match emojis, symbols, special punctuation
    # \U0001F300-\U0001F9FF = emoji range
    # [\u2600-\u26FF\u2700-\u27BF] = misc symbols
    symbol_pattern = re.compile(
        r'[\U0001F300-\U0001F9FF\u2600-\u26FF\u2700-\u27BF'
        r'\u00A9\u00AE\u2122\u2139\u3030\u303D\u3297\u3299]+'
    )

    for match in symbol_pattern.finditer(text):
        symbol = match.group()
        placeholder = f"__SYMBOL_{placeholder_counter}__"
        originals[placeholder] = symbol
        masked_text = masked_text.replace(symbol, placeholder, 1)
        placeholder_counter += 1

    return masked_text, originals

def unmask_symbols(text: str, originals: dict[str, str]) -> str:
    """Restore original symbols after translation."""
    for placeholder, original in originals.items():
        text = text.replace(placeholder, original)
    return text
Наприклад, використання:
# Before translation:
text = "Hello! 👋 Check out this cool feature 🚀"

# Mask symbols:
masked, originals = mask_symbols(text)
# masked = "Hello! __SYMBOL_0__ Check out this cool feature __SYMBOL_1__"
# originals = {"__SYMBOL_0__": "👋", "__SYMBOL_1__": "🚀"}

# Translate the masked text:
translated = translate(masked, "de")  # → "Hallo! __SYMBOL_0__ Schau dir diese coole Funktion an __SYMBOL_1__"

# Unmask symbols:
final = unmask_symbols(translated, originals)
# final = "Hallo! 👋 Schau dir diese coole Funktion an 🚀"
Що тут відбувається?
- Модель регекса: Matches emoji and special symbol Unicode ranges
- Система позиціонерів: Swaps
👋з__SYMBOL_0__тимчасово - Чому це важливо?: Моделі перекладу іноді зашкоджують або видаляють еmoji. - це чудово зберігає їх.
5. Розумний текстовий синтез
Перетворює довгі тексти на шматки, які відповідають обмеженням моделі, зберігаючи межі речення:
# src/utils/text_processing.py
def chunk_sentences(sentences: list[str], max_chars: int = 900) -> list[list[str]]:
    """Group sentences into chunks that fit within model's max input length."""

    chunks = []
    current_chunk = []
    current_length = 0

    for sentence in sentences:
        sentence_len = len(sentence)

        # If this sentence alone is too long, it goes in its own chunk
        if sentence_len > max_chars:
            if current_chunk:
                chunks.append(current_chunk)
                current_chunk = []
                current_length = 0
            chunks.append([sentence])
            continue

        # If adding this sentence exceeds limit, start new chunk
        if current_length + sentence_len + 1 > max_chars:
            chunks.append(current_chunk)
            current_chunk = [sentence]
            current_length = sentence_len
        else:
            current_chunk.append(sentence)
            current_length += sentence_len + 1  # +1 for space

    # Don't forget the last chunk!
    if current_chunk:
        chunks.append(current_chunk)

    return chunks

def split_sentences(text: str, max_sentence_chars: int = 500) -> list[str]:
    """Split text into sentences, enforcing max length."""

    # Split on common sentence terminators
    sentences = re.split(r'([.!?…]+\s+)', text)

    result = []
    for sentence in sentences:
        if not sentence or sentence.isspace():
            continue

        # If sentence is too long, split on word boundaries
        if len(sentence) > max_sentence_chars:
            words = sentence.split()
            current = []
            current_len = 0

            for word in words:
                if current_len + len(word) + 1 > max_sentence_chars:
                    result.append(' '.join(current))
                    current = [word]
                    current_len = len(word)
                else:
                    current.append(word)
                    current_len += len(word) + 1

            if current:
                result.append(' '.join(current))
        else:
            result.append(sentence.strip())

    return result
Що тут відбувається?
- Розділ речення: Використовує регекс для розділення
.!?…зберігаючи пунктуацію - Зжерливе відокремлення: Упаковує якомога більше речень в кожен шматок, не перевищуючи обмеження
- Розрив межи слова: Якщо одна речення надто довга,
- Чому це важливо?: Моделі перекладу мають обмеження для введення кодів.
6. Async Model Discovery with Caching
Динамично відкриває доступні моделі перекладу від HuggingFace:
# src/services/model_discovery.py
import httpx
from datetime import datetime, timedelta

class ModelDiscoveryService:
    """Discovers available translation models with 1-hour cache."""

    def __init__(self):
        self._cache = {}  # Cache results to avoid hammering HuggingFace API
        self._cache_ttl = timedelta(hours=1)
        self._hf_api_base = "https://huggingface.co/api/models"

    async def discover_opus_mt_pairs(self, force_refresh: bool = False):
        """Query HuggingFace for all Helsinki-NLP Opus-MT models."""

        cache_key = "opus-mt"

        # Check cache first
        if not force_refresh and cache_key in self._cache:
            cached_data, cached_time = self._cache[cache_key]
            if datetime.now() - cached_time < self._cache_ttl:
                return cached_data  # Cache hit!

        # Cache miss - query HuggingFace API
        async with httpx.AsyncClient() as client:
            response = await client.get(
                self._hf_api_base,
                params={
                    "author": "Helsinki-NLP",
                    "search": "opus-mt",
                    "limit": 1000
                },
                timeout=30.0
            )
            models = response.json()

        # Extract language pairs from model names
        # Example: "Helsinki-NLP/opus-mt-en-de" → ("en", "de")
        pairs = []
        for model in models:
            model_id = model.get("modelId", "")
            if model_id.startswith("Helsinki-NLP/opus-mt-"):
                # Extract the language codes after "opus-mt-"
                lang_part = model_id.replace("Helsinki-NLP/opus-mt-", "")
                if "-" in lang_part:
                    src, tgt = lang_part.split("-", 1)
                    pairs.append({"source": src, "target": tgt})

        # Cache the results
        self._cache[cache_key] = (pairs, datetime.now())

        return pairs
Що тут відбувається?
- Асинк HTTP клієнта (
httpx): Заблокує HTTP-запити до HuggingFace, які не відповідають - - Час-за базою キャッシュування: Поміщає результати за час МSK1, щоб уникнути обмеження тарифу
- Викладання назви моделей: Зразки
enіdeвідHelsinki-NLP/opus-mt-en-de - Чому це важливо?: HuggingFace має 1200+ Opus-MT моделіM SK3 Запросити їх все займає МSK4 секунду M SK5 Caching робить це миттєвим !
7. Автоматичний розбір пристроїв МSK1Виявление
Автоматично розпізнає і використовує GPU, якщо це доступно:
# src/core/device.py
import torch

class DeviceManager:
    """Smart device selection with GPU auto-detection."""

    def __init__(self):
        self.use_gpu = self._should_use_gpu()
        self.device_index = self._resolve_device()
        self.device_str = "cpu" if self.device_index < 0 else f"cuda:{self.device_index}"

        # Auto-configure parallel translation slots based on device
        if self.device_index >= 0:
            # GPU: Run translations serially to avoid VRAM fragmentation
            self.max_inflight = 1
        else:
            # CPU: Can handle multiple translations in parallel
            self.max_inflight = config.MAX_WORKERS_BACKEND

        self._log_device_info()

    def _should_use_gpu(self) -> bool:
        """Check if GPU should be used."""
        if config.USE_GPU.lower() == "false":
            return False
        if config.USE_GPU.lower() == "true":
            return torch.cuda.is_available()
        # "auto" mode: use GPU if available
        return torch.cuda.is_available()

    def _resolve_device(self) -> int:
        """Returns device index: -1 for CPU, 0+ for CUDA."""
        if not self.use_gpu:
            return -1

        # Check if specific CUDA device requested
        if config.DEVICE and config.DEVICE.startswith("cuda:"):
            device_num = int(config.DEVICE.split(":")[1])
            return device_num

        return 0  # Use first GPU

    def _log_device_info(self):
        """Log device information at startup."""
        if self.device_index >= 0:
            gpu_name = torch.cuda.get_device_name(self.device_index)
            vram_gb = torch.cuda.get_device_properties(self.device_index).total_memory / 1e9
            logger.info(f"Using GPU: {gpu_name} ({vram_gb:.1f}GB VRAM)")
            logger.info(f"Max inflight translations: {self.max_inflight} (GPU mode)")
        else:
            cpu_count = os.cpu_count()
            logger.info(f"Using CPU ({cpu_count} cores)")
            logger.info(f"Max inflight translations: {self.max_inflight} (CPU mode)")

# Global singleton instance
device_manager = DeviceManager()
Що тут відбувається?
- Викриття ҐПУ: Використовує PyTorch, щоб перевірити доступність CUDA
- Автоматична конфігураціяНабірів :
max_inflight=1на GPU ( уникнути фрагментації VRAM ) протиmax_inflight=4на процесорі (максимальний паралелізм ) - Вибір пристроїв: Здатний націлити специфічну GPU з
DEVICE=cuda:1 - Запис: Показує ім 'я GPU і VRAM на запускі для відладки
- Модель синглтонів: Один випадок, поділений впродовж всієї програми
8. Середня експоненційна зміна при повторному спробіM SK1 Після
Smooth retry-after estimation that adapts to actual request durations
# Snippet from QueueManager showing EMA calculation
def update_avg_duration(self, new_duration: float):
    """Update average duration using exponential moving average."""

    # EMA formula: new_avg = α × new_value + (1 - α) × old_avg
    # α = smoothing factor (0.0 to 1.0)
    #   - Higher α = more weight to recent values (faster adaptation)
    #   - Lower α = more weight to historical values (more stable)

    alpha = 0.2  # 20% weight to new value, 80% to historical

    self.avg_duration_sec = (
        alpha * new_duration +
        (1 - alpha) * self.avg_duration_sec
    )
Наприклад:
# Initial average: 5.0 seconds
# New request takes: 10.0 seconds

# EMA calculation:
new_avg = 0.2 * 10.0 + 0.8 * 5.0
        = 2.0 + 4.0
        = 6.0 seconds

# Next request takes: 3.0 seconds
new_avg = 0.2 * 3.0 + 0.8 * 6.0
        = 0.6 + 4.8
        = 5.4 seconds
Що тут відбувається?
- EMA (Exponential Moving AverageM SK1: Як ваганий середній показник, який надає більше значення сучасним значениям
- Рівень плавлення (αM SK1: Контроль того, як швидко ми пристосовуємось до змін
- Чому б не простий середній показник?: EMA адаптується швидше до змін, вифільтруючи піки
- Чому це важливо?: Дає клієнтам реальність
Retry-Aftertimes, які пристосовуються до теперішнього навантаження системи
Ці кодові шаблони демонструють виробництво
- Керування ресурсами: Очистка оперативної пам 'яті
- Милосердявий розрив: Автоматичний зворотній зв 'язок між постачальниками моделей
- Обробка під тиском: черга + HTTP МSK2 замість скасування
- Неповносправність даних: Замаскування символів зберігає особливі символи
- Оптимізація ефективності: Розумне кэшування , блокування МSK2 і паралельна обробка
- Обсервабельність: Детальне записування та стеження за показниками
Кожна з цих характеристик вирішує реальну проблему виробництва, яка могла б призвести до краху, помилокM SK1 або поганого user experience без них!
Руководство по конфігурації
Услугу можна дуже легко налаштувати за допомогою змінних середовища.
Вибір пристроїв
# Prefer GPU if available (default)
USE_GPU=auto

# Force GPU
USE_GPU=true

# Force CPU
USE_GPU=false

# Explicit device override
DEVICE=cuda:0
DEVICE=cpu
Konfiguracja моделі
# Model family selection (NEW in v2.0!)
MODEL_FAMILY=opus-mt   # Best quality (default)
MODEL_FAMILY=mbart50   # 50 languages, single model
MODEL_FAMILY=m2m100    # 100 languages, maximum coverage

# Auto-fallback between model families (NEW in v2.0!)
AUTO_MODEL_FALLBACK=1  # Enabled by default
MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100"  # Priority order

# Volume-mapped model cache (NEW in v2.0!)
MODEL_CACHE_DIR=/models  # Persistent cache directory

# Model arguments passed to transformers.pipeline
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'
EASYNMT_MODEL_ARGS='{"torch_dtype":"bf16","cache_dir":"/models"}'

# Preload models at startup (reduces first-request latency)
PRELOAD_MODELS="en->de,de->en,fr->en"

# LRU cache capacity
MAX_CACHED_MODELS=6
Нова конфігурація пояснена:
MODEL_FAMILY: Виbierz, яку сім 'ю моделей використати як первинну
opus-mt: Найкраща якістьM SK1 1200+ пари, окремі моделіmbart50: Хороша якість, 50 мовиM SK3 єдиний МSK4 GB модельm2m100: Хороша якість, 100 мовиM SK3 єдиний МSK4 GB модель
AUTO_MODELM SK1FALLBACK: Автоматично спробувати інші родини, якщо пара недоступна
1(поганийM SK1 Ввімкнуто МSK2 максимальное покрытие0: Замкнуто - жорсткий єдиний МSK2 родинний режим
MODEL_FALLBACKM SK1ORDER: Priory order for fallback
- За замовчанням:
"opus-mt,mbart50,m2m100"МSK0перша якість) - Альтернатива:
"m2m100,mbart50,opus-mt"(перша поверхняM SK1
- За замовчанням:
MODEL_CACHEM SK1DIR: Persistent model storage via Docker volumes
- Налагодити
/modelsі зображення тому:-v ./model-cache:/models - Моделі продовжують існувати через рестарт контейнера
- Сподіваний кэш між багатьма контейнерами
- Налагодити
лампочка_вибіри типуM SK1
fp16(флоatM SK1 МSK2x швидший на GPU , половина пам 'яті МSK4 незначна втрата якостіbf16(bfloat16): Краще числове стабільність, ніж fpM SK2 потребує сучасних графічних комп 'ютерівfp32(флоatM SK1 Полна precyzія , найповільніша, але найточніші
Установлення перекладу
# Batch size for translation (higher = faster but more VRAM)
EASYNMT_BATCH_SIZE=16  # CPU: 8-16, GPU: 32-64

# Maximum text length per item
EASYNMT_MAX_TEXT_LEN=1000

# Maximum beam size (higher = better quality but slower)
EASYNMT_MAX_BEAM_SIZE=5

# Worker thread pools
MAX_WORKERS_BACKEND=1    # Translation workers
MAX_WORKERS_FRONTEND=2   # Language detection workers
В черзі & Результати
# Enable request queueing (highly recommended)
ENABLE_QUEUE=1

# Max concurrent translations
# Auto: 1 on GPU, MAX_WORKERS_BACKEND on CPU
MAX_INFLIGHT_TRANSLATIONS=1

# Max queued requests before 429
MAX_QUEUE_SIZE=1000

# Per-request timeout (0 = disabled)
TRANSLATE_TIMEOUT_SEC=180

# Retry-After estimation
RETRY_AFTER_MIN_SEC=1      # Floor
RETRY_AFTER_MAX_SEC=120    # Ceiling
RETRY_AFTER_ALPHA=0.2      # EMA smoothing factor
Вхідна санітарія
# Enable input filtering
INPUT_SANITIZE=1

# Minimum alphanumeric ratio (0.2 = 20%)
INPUT_MIN_ALNUM_RATIO=0.2

# Minimum character count
INPUT_MIN_CHARS=1

# Language code for undetermined/noise
UNDETERMINED_LANG_CODE=und
Обробка речей
# Default sentence splitting behavior
PERFORM_SENTENCE_SPLITTING_DEFAULT=1

# Max chars per sentence before word-boundary split
MAX_SENTENCE_CHARS=500

# Max chars per chunk for batching
MAX_CHUNK_CHARS=900

# Sentence joiner
JOIN_SENTENCES_WITH=" "
Маскання символів
# Enable symbol masking
SYMBOL_MASKING=1

# What to mask
MASK_DIGITS=1    # Mask 0-9
MASK_PUNCT=1     # Mask .,!? etc.
MASK_EMOJI=1     # Mask 😀🎉 etc.
Реакцію
# Align response array length to input
ALIGN_RESPONSES=1

# Placeholder for failed items (when aligned)
SANITIZE_PLACEHOLDER=""

# Response format
EASYNMT_RESPONSE_MODE=strings    # ["translation1", "translation2"]
EASYNMT_RESPONSE_MODE=objects    # [{"text":"translation1"}, ...]
Відхилення від Pivot
# Enable two-hop translation via pivot
PIVOT_FALLBACK=1

# Pivot language (usually English)
PIVOT_LANG=en
Запис
# Log level
LOG_LEVEL=INFO

# Per-request logging (verbose)
REQUEST_LOG=1

# Format
LOG_FORMAT=plain    # Human-readable
LOG_FORMAT=json     # Structured JSON

# File logging with rotation
LOG_TO_FILE=1
LOG_FILE_PATH=/var/log/marian-translator/app.log
LOG_FILE_MAX_BYTES=10485760    # 10MB
LOG_FILE_BACKUP_COUNT=5

# Include raw text in logs (privacy risk!)
LOG_INCLUDE_TEXT=0
Утримка
# Periodically clear CUDA cache (seconds, 0=disabled)
CUDA_CACHE_CLEAR_INTERVAL_SEC=0
(DockerM SK1
# Worker count (use 1 for single GPU)
WEB_CONCURRENCY=1

# Request timeout
TIMEOUT=60

# Graceful shutdown timeout
GRACEFUL_TIMEOUT=20

# Keep-alive timeout
KEEP_ALIVE=5
Ось приклади використання
Початковий переклад
# GET request
curl "http://localhost:8000/translate?target_lang=de&text=Hello%20world&source_lang=en"

# Response
{
  "translations": ["Hallo Welt"]
}
Перетворення на батарею (РекомендуєтьсяM SK1
# POST request
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": [
      "Hello world",
      "This is a test",
      "Machine translation is amazing"
    ],
    "target_lang": "de",
    "source_lang": "en",
    "beam_size": 1,
    "perform_sentence_splitting": true
  }'

# Response
{
  "target_lang": "de",
  "source_lang": "en",
  "translated": [
    "Hallo Welt",
    "Das ist ein Test",
    "Maschinenübersetzung ist erstaunlich"
  ],
  "translation_time": 0.342
}
Автоматичне виявлення мови
# Omit source_lang for auto-detection
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{
    "text": ["Bonjour le monde"],
    "target_lang": "en"
  }'

# Response
{
  "target_lang": "en",
  "source_lang": "fr",  # Detected
  "translated": ["Hello world"],
  "translation_time": 0.156
}
Тільки розпізнавання мови
# GET
curl "http://localhost:8000/language_detection?text=Hola%20mundo"
# {"language": "es"}

# POST with batch
curl -X POST http://localhost:8000/language_detection \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello", "Bonjour", "Hola"]}'
# {"languages": ["en", "fr", "es"]}
Концінні точки спостереження
# Health check
curl http://localhost:8000/healthz
# {"status": "ok"}

# Readiness
curl http://localhost:8000/readyz
# {
#   "status": "ready",
#   "device": "cuda:0",
#   "queue_enabled": true,
#   "max_inflight": 1
# }

# Cache status
curl http://localhost:8000/cache
# {
#   "capacity": 6,
#   "size": 3,
#   "keys": ["en->de", "de->en", "fr->en"],
#   "device": "cuda:0",
#   "inflight": 1,
#   "queue_enabled": true
# }

# Model info
curl http://localhost:8000/model_name | jq
Рухування під тиском
# When queue is full, you get 429
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["test"], "target_lang": "de"}'

# Response: 429 Too Many Requests
# Headers: Retry-After: 45
# Body:
{
  "message": "Too many requests; queue full",
  "retry_after_sec": 45
}

# Proper client behavior:
# 1. Read Retry-After header
# 2. Wait that long + jitter
# 3. Retry request
Збудування та версії
Усі зображення Докеру тепер містять правильне версію та метаdane для відстеження.
Швидка будування
Збудувати всі варіанти 4 з автоматичними версіїми на даний час
Windows:
.\build-all.ps1
Linux/Mac:
chmod +x build-all.sh
./build-all.sh
Стратегія версії
Кожна будівля створює дві позначки:
- Названий ярлик (
latest,min,gpu,gpu-minМSK0 - завжди вказує на найновішу - Версію МSK0e.gM SK2
20250108.143022) МSK1 невідмінний знімок
Приклади:
# Always get the latest version
docker pull scottgal/mostlylucid-nmt:cpu
# Or use the :latest alias
docker pull scottgal/mostlylucid-nmt:latest

# Pin to a specific version for reproducibility
docker pull scottgal/mostlylucid-nmt:cpu-20250108.143022
docker pull scottgal/mostlylucid-nmt:cpu-min-20250108.143022
Оцінки OCI
Кожне зображення містить метадані:
- Версію: Побудувати часовий знак (YYYYMMDDM SK2HHMMSS)
- Дата побудови: ISO МSK1 часовий знак
- Обіцяти Git: Короткий SHA
- ВаріантМSK0 cpu-full, cPUM SK3minMSC4 gpu -full+, or gpu+M SK7min
Проаналізувати ярлики:
docker inspect scottgal/mostlylucid-nmt:cpu | jq '.[0].Config.Labels'
Для детальних інструкцій щодо побудови і CI/CD інтеграціїM SK1 читайте BUILD.md.
Розгортання
Розгортання процесора
# Using pre-built image from Docker Hub (recommended)
docker run -d \
  --name translator \
  -p 8000:8000 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=500 \
  -e EASYNMT_BATCH_SIZE=16 \
  -e TIMEOUT=180 \
  -e LOG_LEVEL=INFO \
  -e REQUEST_LOG=0 \
  scottgal/mostlylucid-nmt

# Or build locally
docker build -t mostlylucid-nmt .
docker run -d --name translator -p 8000:8000 mostlylucid-nmt

# Check logs
docker logs -f translator
Розгортання GPU
# Using pre-built GPU image from Docker Hub (recommended)
docker run -d \
  --name translator-gpu \
  --gpus all \
  -p 8000:8000 \
  -e USE_GPU=true \
  -e DEVICE=cuda:0 \
  -e PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en" \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  -e EASYNMT_BATCH_SIZE=64 \
  -e MAX_CACHED_MODELS=8 \
  -e ENABLE_QUEUE=1 \
  -e MAX_QUEUE_SIZE=2000 \
  -e WEB_CONCURRENCY=1 \
  -e TIMEOUT=180 \
  -e GRACEFUL_TIMEOUT=30 \
  -e LOG_FORMAT=json \
  -e LOG_TO_FILE=1 \
  -v /var/log/translator:/var/log/marian-translator \
  scottgal/mostlylucid-nmt:gpu

# Or build locally
docker build -f Dockerfile.gpu -t mostlylucid-nmt:gpu .
docker run -d --name translator-gpu --gpus all -p 8000:8000 mostlylucid-nmt:gpu

# Monitor cache and performance
watch -n 5 "curl -s http://localhost:8000/cache | jq"
Докер Compose
version: '3.8'

services:
  translator:
    image: scottgal/mostlylucid-nmt:gpu  # Use pre-built image
    container_name: translator
    restart: unless-stopped

    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]

    ports:
      - "8000:8000"

    environment:
      USE_GPU: "true"
      DEVICE: "cuda:0"
      PRELOAD_MODELS: "en->de,de->en,en->fr,fr->en"
      EASYNMT_MODEL_ARGS: '{"torch_dtype":"fp16"}'
      EASYNMT_BATCH_SIZE: "64"
      MAX_CACHED_MODELS: "8"
      ENABLE_QUEUE: "1"
      MAX_QUEUE_SIZE: "2000"
      WEB_CONCURRENCY: "1"
      TIMEOUT: "180"
      LOG_FORMAT: "json"
      LOG_TO_FILE: "1"

    volumes:
      - translator-logs:/var/log/marian-translator
      - translator-cache:/root/.cache/huggingface

    healthcheck:
      test: ["CMD", "curl", "-f", "http://localhost:8000/healthz"]
      interval: 30s
      timeout: 10s
      retries: 3
      start_period: 40s

volumes:
  translator-logs:
  translator-cache:
Розгортання Kubernetes
apiVersion: apps/v1
kind: Deployment
metadata:
  name: translator
spec:
  replicas: 2  # Scale horizontally for CPU, use 1 per GPU
  selector:
    matchLabels:
      app: translator
  template:
    metadata:
      labels:
        app: translator
    spec:
      containers:
      - name: translator
        image: scottgal/mostlylucid-nmt:gpu
        ports:
        - containerPort: 8000
        env:
        - name: USE_GPU
          value: "true"
        - name: EASYNMT_MODEL_ARGS
          value: '{"torch_dtype":"fp16"}'
        - name: PRELOAD_MODELS
          value: "en->de,de->en"
        - name: ENABLE_QUEUE
          value: "1"
        - name: MAX_QUEUE_SIZE
          value: "2000"

        resources:
          requests:
            memory: "4Gi"
            cpu: "2"
            nvidia.com/gpu: 1
          limits:
            memory: "8Gi"
            cpu: "4"
            nvidia.com/gpu: 1

        livenessProbe:
          httpGet:
            path: /healthz
            port: 8000
          initialDelaySeconds: 30
          periodSeconds: 10

        readinessProbe:
          httpGet:
            path: /readyz
            port: 8000
          initialDelaySeconds: 20
          periodSeconds: 5

---
apiVersion: v1
kind: Service
metadata:
  name: translator
spec:
  selector:
    app: translator
  ports:
  - port: 80
    targetPort: 8000
  type: LoadBalancer
Оптимізація ефективності
Список перевірок оптимізації GPU
Використовуйте Precyzyjnість FP16
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}'- 2x швидший висновок
- Половина використання VRAM
- Неважлива втрата якості для перекладу
розмір пакету
# Start high, reduce if you get OOM
EASYNMT_BATCH_SIZE=64  # Try 128 on large GPUs
Упередити гарячі моделі
PRELOAD_MODELS="en->de,de->en,en->fr,fr->en,en->es,es->en"Один працівник на GPU
WEB_CONCURRENCY=1
MAX_INFLIGHT_TRANSLATIONS=1
Збільшити розмірキャッシュу
MAX_CACHED_MODELS=10 # Keep more models in VRAMНижчий розмір промені для пропускної спроможності
# beam_size=1 is 3-5x faster than beam_size=5
# Quality difference is often minimal
curl -X POST ... -d '{"beam_size": 1, ...}'
Список перевірок оптимізації процесора
Нижчий розмір партії
EASYNMT_BATCH_SIZE=8Збільшити паралелізм
MAX_WORKERS_BACKEND=4
MAX_INFLIGHT_TRANSLATIONS=4
WEB_CONCURRENCY=2
Неможливе розділення речень для коротких текстів
PERFORM_SENTENCE_SPLITTING_DEFAULT=0
Найкращі практики клієнта
Запити на партію
// Bad: 100 separate requests
for (const text of texts) {
  await translate(text);
}

// Good: 1 batch request
await translate(texts);
Поважати спробу- Після
async function translateWithRetry(texts) {
  try {
    return await translate(texts);
  } catch (err) {
    if (err.status === 429) {
      const retryAfter = err.headers['retry-after'];
      const jitter = Math.random() * 5;
      await sleep((retryAfter + jitter) * 1000);
      return translateWithRetry(texts);
    }
    throw err;
  }
}
Використовувати об 'єднання підключень
// Reuse HTTP connections
const agent = new https.Agent({ keepAlive: true });
Группа по мовним парам
// Bad: mixed language pairs in one request
translate([
  { text: "Hello", sourceLang: "en", targetLang: "de" },
  { text: "Bonjour", sourceLang: "fr", targetLang: "de" }
]);

// Good: group by language pair
translateBatch(enToDe, "en", "de");
translateBatch(frToDe, "fr", "de");
Наслідування & Обсервабельність
Найважливіші метрики для відстеження
- Переводний об 'єм МSK0запити/секM SK2
- Середня затримка МSK0p50, pM SK2 p≥99)
- Глубина черги (рахунок очікування
- Рівень удару в кэші (% запитів, що потрапляють в кэш
- Рівень помилок (5xx відповідейM SK1
- Використовування GPU ( якщо применимо )
- Використовування пам 'яті (VRAM для GPU,RAM для CPUM SK2
До прикладу: Прометеус
Якщо ви інтегруєте Prometheus (не збудований-вM SK2 але легкий додавати ):
translation_requests_total{lang_pair="en->de",status="success"} 1523
translation_requests_total{lang_pair="en->de",status="error"} 7
translation_duration_seconds{lang_pair="en->de",quantile="0.5"} 0.342
translation_duration_seconds{lang_pair="en->de",quantile="0.95"} 1.234
translation_queue_depth 23
translation_cache_size 6
translation_cache_hits_total 8234
translation_cache_misses_total 142
Структурований приклад запису
# Enable JSON logging
LOG_FORMAT=json REQUEST_LOG=1

# Output example
{
  "ts": "2025-01-08T15:30:45+0000",
  "level": "INFO",
  "name": "app",
  "message": "translate_post done items=5 dt=0.342s",
  "req_id": "a3d2f5b1-c4e6-4f7a-9d8c-1e2f3a4b5c6d",
  "endpoint": "/translate",
  "src": "en",
  "tgt": "de",
  "items": 5,
  "duration_ms": 342
}
Ви можете застосувати це до Elasticsearch, CloudWatch, або будь-якого agregaтора журналівM SK2
Порівняння: EasyNMT з MostlyLucidM SK1NMT
| Характеристики МSK1 ЛегкийNMT МSK2 НайчастішийLucid - NMT ≥ | ||
|---|---|---|
| Стабільність | Похибки часті МSK1 Produkція МSK2 готова , граційне управляння помилками | |
| Обробка вхідних даних | Не вдається на емозі МSK1символи МSK2 Надійні очистки + маскування символів мSK4 | |
| Взагальним тиском | Ніхто МSK1 Комнати під навантаженням МSK2 Семафор + черга з повторним випробуванням | |
| Обсервабельність МSK0 Minimal | Здоров 'я МSK2 Готові / кінцеві точки шкали МСК4 структуровані журнали СМС5 | |
| Поддержка GPU | CUDA МSK1x МSK2ancient) | Cuda 12.6, FPM SK6BFMSC7 підтримка МСК8 |
| Керування моделями | РуховийM SK1 безキャッシュу | LRU-каш з автоматичними функціями МSK3 виведення МSK4 |
| Обробка речей | Базове поєднання | Розумне відокремлення МSK2 Бетчерство МSK3 |
| Перетворення на Пivot | Ні МSK1 Автоматичний зворотній зв 'язок через англійську | |
| Милосердний закритий МSK0 Ні | Так МSK2 з перервами | |
| Konfiguracja | Спеціальна МSK1 МSK2 енв-варс для тонкогоM SK3тунінга | |
| Подібність API | EasyNMT кінцеві точки МSK1 МSK2 сов 'язні + розширення | |
| Якість коду | НеобладнанийM SK1 монолітний | Модулярний МSK3 задрукований М SK4 перевірений МSK5 |
Подолання проблем
429 Надто багато запитів
Причина: черга повна.
Рішення:
- Збільшувати
MAX_QUEUE_SIZE - Додайте більше реплікатів ( горизонтальне масштабуванняM SK1
- Збільшувати
MAX_INFLIGHT_TRANSLATIONS( якщо у вас є кімната для голови ) - Снизити розміри пакетів від клієнтів
503 Служба недоступна
Причина: Вказівник черги і всі slots зайняті.
Рішення:
- Увімкніть чергування:
ENABLE_QUEUE=1 - Підніміть обмеження руху, якщо є ресурси
OOM (Вийшов з пам 'яті) на GPU
Причина: Величина батареї надто висока або надто багато моделей вキャッシュі.
Рішення:
- Снижувати
EASYNMT_BATCH_SIZE - Снижувати
MAX_CACHED_MODELS - Ввімкніть FP16:
EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' - Упевнитись
WEB_CONCURRENCY=1іMAX_INFLIGHT_TRANSLATIONS=1
Повільний перший запит
Причина: Модель ще не завантажена.
Рішення:
PRELOAD_MODELS="en->de,de->en"
Позбавлена мовної пари
Причина: Helsinki-NLP/opus-mt-{src}-{tgt} не існує на Hugging Face
Рішення:
- Ввімкніть зворотній поворот
PIVOT_FALLBACK=1(ルートи через англійськуM SK1 - Проверити піддерживані пари:
curl http://localhost:8000/lang_pairs
Знаменні артефакти в перекладі
Причина: Маскування символів може бути занадто агресивним.
Рішення:
- Виключити специфічну маску:
MASK_EMOJI=0абоMASK_PUNCT=0 - Або повністю вимкнути:
SYMBOL_MASKING=0
Інтеграція з ASP.NET
Якщо ви ' following along from our previous posts on EasyNMT integration , hereM SK2s how to update your C
public class MostlyLucidNmtClient
{
    private readonly HttpClient _httpClient;
    private readonly string _baseUrl;

    public MostlyLucidNmtClient(HttpClient httpClient, string baseUrl)
    {
        _httpClient = httpClient;
        _baseUrl = baseUrl;
    }

    public async Task<TranslationResponse> TranslateAsync(
        List<string> texts,
        string targetLang,
        string sourceLang = "",
        int beamSize = 1,
        bool performSentenceSplitting = true,
        CancellationToken cancellationToken = default)
    {
        var request = new TranslationRequest
        {
            Text = texts,
            TargetLang = targetLang,
            SourceLang = sourceLang,
            BeamSize = beamSize,
            PerformSentenceSplitting = performSentenceSplitting
        };

        var response = await _httpClient.PostAsJsonAsync(
            $"{_baseUrl}/translate",
            request,
            cancellationToken);

        if (response.StatusCode == System.Net.HttpStatusCode.TooManyRequests)
        {
            // Read Retry-After header
            var retryAfter = response.Headers.RetryAfter?.Delta?.TotalSeconds ?? 30;
            var jitter = Random.Shared.Next(0, 5);
            await Task.Delay(TimeSpan.FromSeconds(retryAfter + jitter), cancellationToken);

            // Retry
            return await TranslateAsync(texts, targetLang, sourceLang, beamSize,
                performSentenceSplitting, cancellationToken);
        }

        response.EnsureSuccessStatusCode();
        return await response.Content.ReadFromJsonAsync<TranslationResponse>(cancellationToken);
    }
}

public class TranslationRequest
{
    [JsonPropertyName("text")]
    public List<string> Text { get; set; }

    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("beam_size")]
    public int BeamSize { get; set; }

    [JsonPropertyName("perform_sentence_splitting")]
    public bool PerformSentenceSplitting { get; set; }
}

public class TranslationResponse
{
    [JsonPropertyName("target_lang")]
    public string TargetLang { get; set; }

    [JsonPropertyName("source_lang")]
    public string SourceLang { get; set; }

    [JsonPropertyName("translated")]
    public List<string> Translated { get; set; }

    [JsonPropertyName("translation_time")]
    public double TranslationTime { get; set; }
}
Зареєструйтеся у вашому контейнері DI:
services.AddHttpClient<MostlyLucidNmtClient>(client =>
{
    client.BaseAddress = new Uri("http://translator:8000");
    client.Timeout = TimeSpan.FromMinutes(3);
});
Завершення
НайчастішеLucid-NMT - це повна переробка концепції EasyNMT, зважаючи на надійність виробництва Версия 2.0 переносить її на наступний рівень з мультимодельною підтримкою сім 'ї та розумним падінням
Що робить v2.0 особливим
1. Максимальна мова
- Підтримка мов 100+ у всіх трьох родинах моделей
- Автоматичний -відворот гарантує, що ви ніколи не натиснете на "не obsługiваний мовний парM SK2
- 9,900+ пари перекладу
МСК0 ЯкістьМSK1Перший підхід
- Найкращий доступний модель для кожної пари
- ОпусМSK0MT (краща якістьM SK2 → mBART50 \→ MMSC6MMST7 замовлення назад
- Прозоре журналування показує, яку модель використали
3. Гибке використання
- Єдиний Докер-репозитор з варіантами 4
- Найменші зображення для простору-в обмежених середовищах
- Том- закартографований кэш для тривалості моделі
- Перемикайте родини моделі без перебудови
4. ProdukціяM SK1 Готова
- Messy real- world input M SK1 emoji , символи, рёберні casesMSC4
- Навантаження на виробництво ( чергає , зворотній тискM SK2 граційна деградація)
- Efektivність GPU (FPM SK1 Cache LRU , VRAM management МSK3
- Операційна видимість (контроль здоров 'я МSK1 метрика МSK2 структуровані журнали )
- Досвідомлення програмістів (100%Kompatibilна з API EasyNMT , повні доки МSK2
Реальний- Світове використання
Ця служба була боїться "-", тестуючи тисячі блогових постів 100+ мови (вгорі від МSK1 в vM SK2 Він працює надійно в процесі виробництва на такій самій частоті, як і на ҐПЗ МSK3 граційно обробляє крутий рух , і надає суб М SK5секундні переклади типового контенту для блогів
Key Takeaways
- Максимальна поява: МСК0 мови МSK1 9,900+ пари, автоматичний відхилення
- Якість перший: Prioritizes best available model, transparent selection
- Robustness: Інпутна санітарія, управляння помилкамиM SK1 граційне вимкнення
- Розумні ресурси: Caching LRU,задувний тиск,авто VRAMM SK2виведення
- Обсервабельність: Проверки здоров 'я, статусキャッシュу , відкриття моделіM SK2 структуровані журнали
- Результати: FP16, набір, , переднавантаження, МSK2 мультипліковий, M SK3 сімейний atbalsts
- Дружелюбний для розробника: EasyNMT-совладнаний APIM SK1 обширна конфігурація , чіткі помилки
- Просте використання: Одноразовий контейнер для докерів, без складного набору
Гвидкий запуск пам 'ятника
# Maximum coverage with auto-fallback (recommended!)
docker run -d -p 8000:8000 \
  -v ./model-cache:/models \
  -e MODEL_CACHE_DIR=/models \
  -e AUTO_MODEL_FALLBACK=1 \
  -e MODEL_FALLBACK_ORDER="opus-mt,mbart50,m2m100" \
  scottgal/mostlylucid-nmt:cpu-min

# GPU with best quality
docker run -d --gpus all -p 8000:8000 \
  -e USE_GPU=true \
  -e MODEL_FAMILY=opus-mt \
  -e EASYNMT_MODEL_ARGS='{"torch_dtype":"fp16"}' \
  scottgal/mostlylucid-nmt:gpu

# Test it
curl -X POST http://localhost:8000/translate \
  -H 'Content-Type: application/json' \
  -d '{"text": ["Hello world"], "target_lang": "de"}'
Що' СледующаяM SK1
Уся служба - один контейнер для докерів. Без складного налаштування, без зовнішнього віддаленості за межі завантажень моделей Hugging Face .
Просто витягніть, запуститиM SK1 і перекладіть 100+ мовами з найкращими доступними моделями !
Щиро дякую.
Дальне читання
- ХельсинкиМSK0NLP Opus-MT Моделі
- Документація про Hugging Face Transformers
- Документація FastAPI
- Оптимізація PyTorch CUDA
Источник
Полний вихідний код доступний на [ваше-repoM SK1link]. Привіт за ваші příspěvky
Метки
Translation NMT Neural Machine Translation Python FastAPI Docker CUDA PyTorch Transformers Helsinki-NLP Production Microservices API