
Recherche de texte complet (Pt 3 - OpenSearch avec ASPM SK3NET Core)


Introduction
Dans les sections précédentes de la présente série, nous avons présenté le concept de recherche du texte complet et comment il peut être utilisé pour rechercher un texte dans une base de données.
Pièces précédentes:
Dans cette partie, nous vous expliquerons comment commencer à utiliser une nouvelle instance de recherche ouverte brillante avec ASP.NET Core.
Mise en place
Une fois que l’instance OpenSearch est en marche, nous pouvons commencer à interagir avec elle. Client OpenSearch pour .NET. Premièrement, nous mettons en place le client dans notre extension de configuration
    var openSearchConfig = services.ConfigurePOCO<OpenSearchConfig>(configuration.GetSection(OpenSearchConfig.Section));
        var config = new ConnectionSettings(new Uri(openSearchConfig.Endpoint))
            .EnableHttpCompression()
            .EnableDebugMode()
            .ServerCertificateValidationCallback((sender, certificate, chain, errors) => true)
            .BasicAuthentication(openSearchConfig.Username, openSearchConfig.Password);
        services.AddSingleton<OpenSearchClient>(c => new OpenSearchClient(config));
Cela permet de mettre en place le client avec les points finals et les credentials. Nous activons également le mode de débugging afin que nous puissions voir ce qui se passe.
Données d'indexation
Le concept de base d’OpenSearch est l’indice.
Pour ce faire, nous utiliserons le Client OpenSearch pour .NETM SK1 Vous pouvez l'installer via NuGet:
Vous remarquerez les deux éléments suivants :
Maintenant que nous l'avons installé, nous pouvons commencer à regarder les données d'indexation.
La création d'un index est de la moitié-directement vers l'avantM SK1 Vous définissez simplement ce que votre index devrait ressembler et ensuite le créez. Dans le code ci-dessous vous pouvez voir nous 'map' notre Modèle d'index (une version simplifiée du blogM SK3s modèle de base de donnéesMSC4 Pour chaque champ de ce modèle, nous définissons ensuite quel type il est (texte , dateM SK2 mot clé etc) et quel analyseur utiliserMSC4
Le type est important car il définit comment les données sont conservées et comment elles peuvent être recherchées. Par exemple, le champ M SK1 un 'texte' est analysé et tokeniséMSC4 un ?' mot cléMST6 n'est pas le champMSL7 Vous vous attendez donc à la recherche d'un champ de mots-clés exactement comme celui qui est conservé, mais un champ de texte que vous pouvez rechercher pour des parties du texte.
Également ici Categories est en fait une chaîne[] mais le type de mot clé comprend comment les traiter correctement.
   public async Task CreateIndex(string language)
    {
        var languageName = language.ConvertCodeToLanguageName();
        var indexName = GetBlogIndexName(language);

      var response =  await client.Indices.CreateAsync(indexName, c => c
            .Settings(s => s
                .NumberOfShards(1)
                .NumberOfReplicas(1)
            )
            .Map<BlogIndexModel>(m => m
                .Properties(p => p
                    .Text(t => t
                        .Name(n => n.Title)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Content)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Language)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Date(t => t
                        .Name(n => n.Published)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Keyword(t => t
                        .Name(n => n.Id)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Slug)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Hash)
                    )
                    .Keyword(t => t
                        .Name(n => n.Categories)
                    )
                )
            )
        );

        if (!response.IsValid)
        {
           logger.LogError("Failed to create index {IndexName}: {Error}", indexName, response.DebugInformation);
        }
    }
Ajouter des éléments à l'index
Une fois que notre index a été mis en place pour y ajouter des éléments, nous devons les ajouter à cet indice.
Vous pouvez voir que nous appelons tout d'abord à unGetExistingPosts ce qui retourne tous les postes qui sont déjà dans l'index. Nous puis groupons les posts par langue et filtrons outre la M SK1uk' langue (as nous ne voulons pasMSC4t indexer que comme il a besoin d'un plugin supplémentaire nous n'en avons pas encoreMST5t have yetMSP6 Nous filtrons ensuite tout post qui est déjà dans le répertoire MST7
Nous utilisons le hash et l’ID pour identifier si un poste est déjà dans l’index.
    public async Task AddPostsToIndex(IEnumerable<BlogIndexModel> posts)
    {
        var existingPosts = await GetExistingPosts();
        var langPosts = posts.GroupBy(p => p.Language);
        langPosts=langPosts.Where(p => p.Key!="uk");
        langPosts = langPosts.Where(p =>
            p.Any(post => !existingPosts.Any(existing => existing.Id == post.Id && existing.Hash == post.Hash)));

        foreach (var blogIndexModels in langPosts)
        {

            var language = blogIndexModels.Key;
            var indexName = GetBlogIndexName(language);
            if(!await IndexExists(language))
            {
                await CreateIndex(language);
            }

            var bulkRequest = new BulkRequest(indexName)
            {
                Operations = new BulkOperationsCollection<IBulkOperation>(blogIndexModels.ToList()
                    .Select(p => new BulkIndexOperation<BlogIndexModel>(p))
                    .ToList()),
                Refresh = Refresh.True,
                ErrorTrace = true,
                RequestConfiguration = new RequestConfiguration
                {
                    MaxRetries = 3
                }
            };

            var bulkResponse = await client.BulkAsync(bulkRequest);
            if (!bulkResponse.IsValid)
            {
                logger.LogError("Failed to add posts to index {IndexName}: {Error}", indexName, bulkResponse.DebugInformation);
            }

        }
    }
Une fois que nous ' avons filtré les postes existants et notre analyseur manquant, nous créerons un nouvel index ( fondé sur le nom
Vous verrez ce qui suit : BulkRequest Nous avons établi Refresh de la propriété à true. Cela signifie que, après l'insertion en vrac est terminée, l'indice est renouvelé. Ce n'est pas vraiment nécessaire mais il est utile pour le débugging.
Recherche de l'index
Une bonne façon de tester ce qui a été créé ici, c’est d’entrer dans l’outil Dev sur les tableaux de navigation OpenSearch et de faire une recherche.
GET /mostlylucid-blog-*
{}
Cette demande nous retournera tous les indices correspondant au modèle mostlylucid-blog-*. (soit tous nos indices jusqu’à présentM SK2
{
  "mostlylucid-blog-ar": {
    "aliases": {},
    "mappings": {
      "properties": {
        "categories": {
          "type": "keyword"
        },
        "content": {
          "type": "text",
          "analyzer": "arabic"
        },
        "hash": {
          "type": "keyword"
        },
        "id": {
          "type": "keyword"
        },
        "language": {
          "type": "text"
        },
        "lastUpdated": {
          "type": "date"
        },
        "published": {
          "type": "date"
        },
        "slug": {
          "type": "keyword"
        },
        "title": {
          "type": "text",
          "analyzer": "arabic"
        }
      }
    },
    "settings": {
      "index": {
        "replication": {
          "type": "DOCUMENT"
..MANY MORE
Dev Tools in OpenSearch Dashboards est une excellente façon de tester vos demandes avant de les mettre dans votre code.
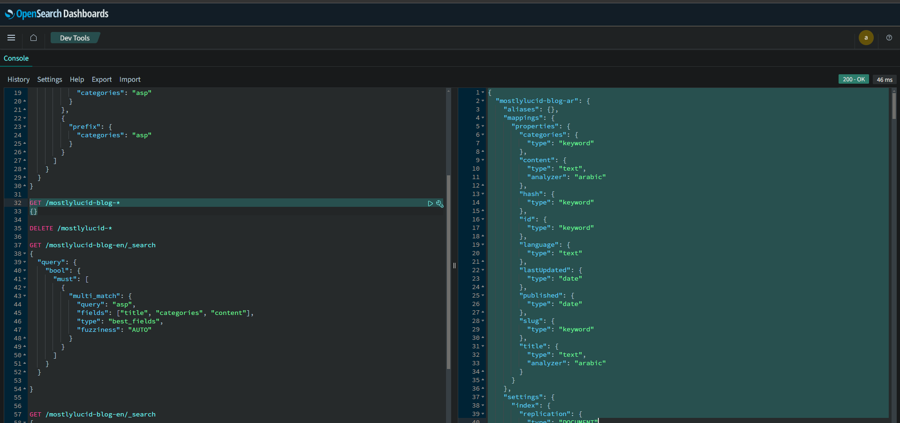
Recherche de l'index
Maintenant, nous pouvons commencer à rechercher l’index. Nous pouvons utiliser Search méthode sur le client pour ce faire.
C’est là que le véritable pouvoir d’OpenSearch se trouve dans.. douzaines de types différents de demandes vous pouvez utiliser pour rechercher vos données. Tout, depuis une simple recherche de mots clés jusqu'à une recherche complexe M SK1neural' search .
    public async Task<List<BlogIndexModel>> GetSearchResults(string language, string query, int page = 1, int pageSize = 10)
    {
        var indexName = GetBlogIndexName(language);
        var searchResponse = await client.SearchAsync<BlogIndexModel>(s => s
                .Index(indexName)  // Match index pattern
                .Query(q => q
                    .Bool(b => b
                        .Must(m => m
                            .MultiMatch(mm => mm
                                .Query(query)
                                .Fields(f => f
                                    .Field(p => p.Title, boost: 2.0)
                                    .Field(p => p.Categories, boost: 1.5)
                                    .Field(p => p.Content)
                                )
                                .Type(TextQueryType.BestFields)
                                .Fuzziness(Fuzziness.Auto)
                            )
                        )
                    )
                )
                .Skip((page -1) * pageSize)  // Skip the first n results (adjust as needed)
                .Size(pageSize)  // Limit the number of results (adjust as needed)
        );

        if(!searchResponse.IsValid)
        {
            logger.LogError("Failed to search index {IndexName}: {Error}", indexName, searchResponse.DebugInformation);
            return new List<BlogIndexModel>();
        }
        return searchResponse.Documents.ToList();
    }
Description de la demande
Cette méthode, GetSearchResults, est conçu pour faire une recherche d’un index OpenSearch spécifique afin de récupérer des articles sur un blog. language, query, et paramètres de pagement page et pageSize. Voici ce qu’il faitM SK1:
Sélection de l'index:
- Il reçoit le nom de l'index en utilisant
GetBlogIndexNameméthode fondée sur la langue fournie. L'index est sélectionné dynamiquement selon la langue.
- Il reçoit le nom de l'index en utilisant
Demande de recherche:
- La demande utilise un
Boold'une demande avec unMustclause pour assurer que les résultats correspondent à certains critères. - À l'intérieur du
Mustclause, aMultiMatchquery est utilisé pour effectuer une recherche dans plusieurs champs (Title,Categories, etContent).- Amélioration: Le
TitleLe champ est renforcé par2.0, rendant plus important dans la recherche , etCategoriesa un accroissement de1.5. Cela signifie que les documents où la demande de recherche apparaît dans le titre ou les catégories seront classés plus haut. - Type de demande: Utilise
BestFields, qui tente de trouver le meilleur champ correspondant pour la demande - Fuzziness: Le
Fuzziness.AutoParamètre permet d'obtenir des parallèles approximatifs (e.gM SK2 manipulation de typos mineursMSC3
- Amélioration: Le
- La demande utilise un
Pagement:
- L'article 5 de la Loi sur l'immigration et le statut des réfugiés
Skipla méthode skips the firstnLes résultats dépendent du numéro de page, calculé comme(page - 1) * pageSize. Cela aide à naviguer par les résultats affichés sur la page. - L'article 5 de la Loi sur l'immigration et le statut des réfugiés
Sizela méthode limite le nombre de documents retournés au spécifiépageSize.
- L'article 5 de la Loi sur l'immigration et le statut des réfugiés
Erreur de manutention:
- Si la demande échoue, un erreur est enregistré et une liste vide est retournée.
Résultat:
- La méthode retourne une liste de
BlogIndexModeldocuments correspondant aux critères de recherche.
- La méthode retourne une liste de
Ainsi, vous pouvez voir que nous pouvons être super souples quant à la façon de rechercher nos données.
Un grand avantage est la facilité de qith qui nous permet d’appuyer plusieurs langues. Nous avons un indice différent pour chaque langue et nous pouvons effectuer une recherche dans cet index. Cela signifie que nous pouvons utiliser l’analyseur correct pour chacune des langues et obtenir les meilleurs résultatsM SK2
La nouvelle API de recherche
Contrairement à l’API de recherche que nous avons vu dans les parties précédentes de cette série,, nous pouvons simplifier considérablement le processus de recherche en utilisant OpenSearch. Nous pouvons simplement ajouter du texte à cette demande et obtenir de bons résultats de retourM SK2
   [HttpGet]
    [Route("osearch/{query}")]
   [ValidateAntiForgeryToken]
    public async Task<JsonHttpResult<List<SearchResults>>> OpenSearch(string query, string language = MarkdownBaseService.EnglishLanguage)
    {
        var results = await indexService.GetSearchResults(language, query);

        var host = Request.Host.Value;
        var output = results.Select(x => new SearchResults(x.Title.Trim(), x.Slug, @Url.ActionLink("Show", "Blog", new{ x.Slug}, protocol:"https", host:host) )).ToList();
        return TypedResults.Json(output);
    }
Comme vous pouvez le voir, nous avons tous les données dont nous avons besoin dans l'index pour retourner les résultats. Nous pouvons ensuite utiliser cela pour générer un URL à la page de blog. Cela prend la charge de notre base de données et rend le processus de recherche beaucoup plus rapideM SK2
En conclusion
Dans ce post, nous avons vu comment écrire un client C# pour interagir avec notre instance OpenSearch.