
Täyden tekstin haku (Pt 3 - OpenSearch ASP:n kanssa


Esitys
Aikaisemmissa osissa otimme esille koko tekstien hakua koskevan käsitteen ja sen, miten sitä voidaan käyttää tekstien etsimiseen tietokannassa.
Aiemmat osat:
Tässä osassa käsitellään, miten voitte aloittaa uuden loistavan OpenSearch-esityksen käyttämisen ASP:n kanssa.
Järjestelmä
Kun OpenSearch-esitys on otettu käyttöön ja käynnissä, voimme aloittaa vuorovaikutuksen sen kanssa. OpenSearch-klientti .NETM SK1 Ensinnäkin otamme käyttöön Clientin ohjelmien laajentamisessa
    var openSearchConfig = services.ConfigurePOCO<OpenSearchConfig>(configuration.GetSection(OpenSearchConfig.Section));
        var config = new ConnectionSettings(new Uri(openSearchConfig.Endpoint))
            .EnableHttpCompression()
            .EnableDebugMode()
            .ServerCertificateValidationCallback((sender, certificate, chain, errors) => true)
            .BasicAuthentication(openSearchConfig.Username, openSearchConfig.Password);
        services.AddSingleton<OpenSearchClient>(c => new OpenSearchClient(config));
Tämä vahvistaa Clientin loppupisteen ja todisteiden kanssa. Myönnämme myös debug-muodon, jotta voimme nähdä, mitä tapahtuuM SK1 . Koska emme käytä todellisia SSL-todistuksia, lopetamme todistusten validoinnin.
Indexointitiedot
OpenSearchin keskeinen käsite on indeksi.
Tätä varten me' käytämme OpenSearch-klientti .NET. Voitte asentaa tämän NuGet-järjestelmän kautta
Huomaatte, että siellä on kaksi asiaa: - Opensearch . Net ja Opensearch. Client . Ensinnäkin niillä on alhainen taso, kuten yhteyksien hallinnointi , Toiseksi niissä on korkean tason, kuten indeksointi ja haku
Nyt kun se on otettu käyttöön, voimme alkaa tarkastella indeksointitietoja.
Esimerkkien luominen on puolinkertaista- suoraan eteenpäinM SK1 määrittele vain, miltä indeksin pitäisi näyttää ja sitten luo se. jäljempänä olevassa koodissa voimme nähdä 'kartta'indeksimallimme (blogin yksinkertaistettu versioM SK3tietokannan mallinMSC4 Tämän mallin kutakin alaa varten määritämme sen tyyppi: (tekstiM SK1 päivämäärä, avainsana jne.
Luettelo on tärkeä, koska siinä määritellään, miten tietoja tallennetaan ja miten niitä voidaan hakea.. Esimerkiksi, field analysoidaan ja tokenoidaan |'text | ' field is analyzed and tokenized |
Myös tässä Categories on itse asiassa string[] mutta avainsanatyyppi ymmärtää, miten käsitellä niitä oikeinM SK1
   public async Task CreateIndex(string language)
    {
        var languageName = language.ConvertCodeToLanguageName();
        var indexName = GetBlogIndexName(language);

      var response =  await client.Indices.CreateAsync(indexName, c => c
            .Settings(s => s
                .NumberOfShards(1)
                .NumberOfReplicas(1)
            )
            .Map<BlogIndexModel>(m => m
                .Properties(p => p
                    .Text(t => t
                        .Name(n => n.Title)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Content)
                        .Analyzer(languageName)
                    )
                    .Text(t => t
                        .Name(n => n.Language)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Date(t => t
                        .Name(n => n.Published)
                    )
                    .Date(t => t
                        .Name(n => n.LastUpdated)
                    )
                    .Keyword(t => t
                        .Name(n => n.Id)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Slug)
                    )
                    .Keyword(t=>t
                        .Name(n=>n.Hash)
                    )
                    .Keyword(t => t
                        .Name(n => n.Categories)
                    )
                )
            )
        );

        if (!response.IsValid)
        {
           logger.LogError("Failed to create index {IndexName}: {Error}", indexName, response.DebugInformation);
        }
    }
Esimerkkien lisääminen luetteloon
Kun olemme laatineet luettelomme lisätäksemme siihen asioita, meidän on lisättävä asioita tähän luetteloon.
Voitte nähdä, että alun perin kutsumme menetelmäksiGetExistingPosts , joka palauttaa kaikki kohdat, jotka ovat jo indeksissä.
Käytämme hashia ja idiä tunnistaaksemme, onko posti jo indeksissä.
    public async Task AddPostsToIndex(IEnumerable<BlogIndexModel> posts)
    {
        var existingPosts = await GetExistingPosts();
        var langPosts = posts.GroupBy(p => p.Language);
        langPosts=langPosts.Where(p => p.Key!="uk");
        langPosts = langPosts.Where(p =>
            p.Any(post => !existingPosts.Any(existing => existing.Id == post.Id && existing.Hash == post.Hash)));

        foreach (var blogIndexModels in langPosts)
        {

            var language = blogIndexModels.Key;
            var indexName = GetBlogIndexName(language);
            if(!await IndexExists(language))
            {
                await CreateIndex(language);
            }

            var bulkRequest = new BulkRequest(indexName)
            {
                Operations = new BulkOperationsCollection<IBulkOperation>(blogIndexModels.ToList()
                    .Select(p => new BulkIndexOperation<BlogIndexModel>(p))
                    .ToList()),
                Refresh = Refresh.True,
                ErrorTrace = true,
                RequestConfiguration = new RequestConfiguration
                {
                    MaxRetries = 3
                }
            };

            var bulkResponse = await client.BulkAsync(bulkRequest);
            if (!bulkResponse.IsValid)
            {
                logger.LogError("Failed to add posts to index {IndexName}: {Error}", indexName, bulkResponse.DebugInformation);
            }

        }
    }
Kun olemme ”'” –filteroineet olemassa olevat postit ja poistaneet puutteellisen analysaattorimme, luomme uuden indeksin (nimien perusteella.
Huomaatte, että BulkRequest asetamme Refresh omaisuus true. Tämä merkitsee sitä, että indeksi on päivitetty sen jälkeen kun kokonaispano on saatu päätökseen.
Indeksin etsintä
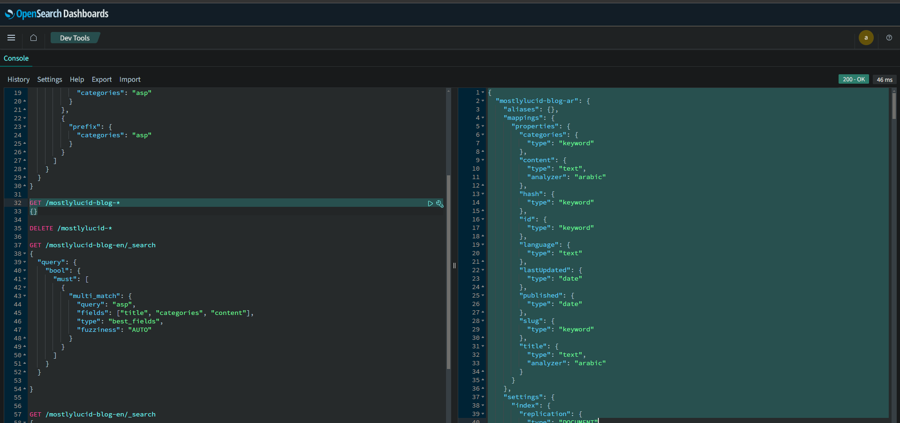
Hyvä tapa testata sitä, mitä ”'” on itse asiassa luotu, on mennä OpenSearch Dashboardin Dev-välineisiin ja tehdä hakupyyntö.
GET /mostlylucid-blog-*
{}
Tämä kysymys palauttaa meille kaikki indeksit, jotka vastaavat mallia mostlylucid-blog-*. (kaikki tähänastiset indikaattorimme
{
  "mostlylucid-blog-ar": {
    "aliases": {},
    "mappings": {
      "properties": {
        "categories": {
          "type": "keyword"
        },
        "content": {
          "type": "text",
          "analyzer": "arabic"
        },
        "hash": {
          "type": "keyword"
        },
        "id": {
          "type": "keyword"
        },
        "language": {
          "type": "text"
        },
        "lastUpdated": {
          "type": "date"
        },
        "published": {
          "type": "date"
        },
        "slug": {
          "type": "keyword"
        },
        "title": {
          "type": "text",
          "analyzer": "arabic"
        }
      }
    },
    "settings": {
      "index": {
        "replication": {
          "type": "DOCUMENT"
..MANY MORE
Dev Tools OpenSearch Dashboardissa on erinomainen tapa testata kysymyksiänne ennen kuin panette ne kokeenne.
Indeksin etsintä
Nyt voimme alkaa hakea indeksiä. Voimme käyttää Search menetelmä, jonka avulla tämä tehdään
Tämä on se, missä OpenSearchin todellinen voima tulee . useat erilaiset kysymykset , jonka avulla voit hakea tietojanne. Kaikista yksinkertaisesta avainsanoista monimutkaiseen
    public async Task<List<BlogIndexModel>> GetSearchResults(string language, string query, int page = 1, int pageSize = 10)
    {
        var indexName = GetBlogIndexName(language);
        var searchResponse = await client.SearchAsync<BlogIndexModel>(s => s
                .Index(indexName)  // Match index pattern
                .Query(q => q
                    .Bool(b => b
                        .Must(m => m
                            .MultiMatch(mm => mm
                                .Query(query)
                                .Fields(f => f
                                    .Field(p => p.Title, boost: 2.0)
                                    .Field(p => p.Categories, boost: 1.5)
                                    .Field(p => p.Content)
                                )
                                .Type(TextQueryType.BestFields)
                                .Fuzziness(Fuzziness.Auto)
                            )
                        )
                    )
                )
                .Skip((page -1) * pageSize)  // Skip the first n results (adjust as needed)
                .Size(pageSize)  // Limit the number of results (adjust as needed)
        );

        if(!searchResponse.IsValid)
        {
            logger.LogError("Failed to search index {IndexName}: {Error}", indexName, searchResponse.DebugInformation);
            return new List<BlogIndexModel>();
        }
        return searchResponse.Documents.ToList();
    }
Kysymyksen kuvaus
Tämä menetelmä, GetSearchResults, on suunniteltu kysymään tietyn OpenSearch-indeksin, jotta blogit saadaan takaisin. language, query, ja sivuusparameterit page ja pageSize.Herä on ', mitä se tekee
Indexin valinta:
- Se palauttaa indeksin nimeä käyttäen
GetBlogIndexNamemenetelmä annetun kielen perusteella. indeksi selected dynamically according to the language
- Se palauttaa indeksin nimeä käyttäen
hakukysymys:
- Kysymyksessä käytetään
BoolkysymyksenMustlauseke sen varmistamiseksi, että tulokset vastaavat tiettyjä kriteerejä - Sisäpuolella
Mustalakohta, aMultiMatch(Title,Categories, jaContent).- Painottaminen:
Titlealueelle annetaan lisäys2.0,, mikä tekee sen tärkeämmäksi hakussaCategorieson nopeuttanut1.5. Tämä tarkoittaa, että asiakirjat, joissa hakukysymys ilmenee otsikossa tai kategorioissa, suoritetaan korkeammalla sijalla. - Kysymyksentyyppi: Se käyttää
BestFields,, joka yrittää löytää parhaan vastaamaan kysymykseen kuuluvan alueen - Fuzziness:
Fuzziness.Autoparametri antaa approximate matches (e .gM SK2 käsitellä pieniä typoja).
- Painottaminen:
- Kysymyksessä käytetään
Pageointi:
- Euroopan unionin
Skipmenetelmä välttää ensimmäisenntulos riippuu sivunumerosta,, joka lasketaan(page - 1) * pageSize. Tämä auttaa navigoimaan sivuttujen tulosten läpi - Euroopan unionin
Sizemenetelmä rajoittaa määrän asiakirjoja, jotka palautetaanpageSize.
- Euroopan unionin
Ongelmakäsittelyssä:
- Jos haku epäonnistuu, virhe kirjataan ja tyhjä luettelo palautetaan.
Tulos:
- Menetelmä palauttaa luettelon
BlogIndexModelhakukriteerien mukaiset asiakirjat.
- Menetelmä palauttaa luettelon
Voitte siis nähdä, että voimme olla erittäin joustavia tietojen hakumenettelyssä.
Yksi BIG-etu on se helppous, että voimme tukea useita kieliä. Meillä on erilainen indeksi jokaiselle kielelle ja mahdollistaa haku kyseisessä indeksissä. Tämä tarkoittaa, että me voimme käyttää oikean analyysin jokaiseen kieleen ja saada parhaat tuloksetM SK2
Uusi haku API
Toisin kuin tämän sarjan edellisissä osissa nähdyssä haku API:ssa, me voimme yksinkertaistaa laajasti hakuprosessia käyttämällä OpenSearch-järjestelmää.Me voimme vain syöttää tekstiä tähän kysymykseen ja saada hyviä tuloksia takaisin.
   [HttpGet]
    [Route("osearch/{query}")]
   [ValidateAntiForgeryToken]
    public async Task<JsonHttpResult<List<SearchResults>>> OpenSearch(string query, string language = MarkdownBaseService.EnglishLanguage)
    {
        var results = await indexService.GetSearchResults(language, query);

        var host = Request.Host.Value;
        var output = results.Select(x => new SearchResults(x.Title.Trim(), x.Slug, @Url.ActionLink("Show", "Blog", new{ x.Slug}, protocol:"https", host:host) )).ToList();
        return TypedResults.Json(output);
    }
Kuten voitte nähdä, meillä on kaikki tiedot, joita tarvitsemme indeksissä tulosten palauttamiseksi. Voimme sen jälkeen käyttää sitä luodaksemme URL:n blogiin lähetettävälle postilleM SK1 Tämä vähentää tietokantamme kuormitusta ja tekee hakuprosessista paljon nopeamman.
Päätelmissä
Tässä artikkelissa näimme, miten kirjoitetaan C# klientti vuorovaikutukseen OpenSearchin instanssin kanssa.