This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Sunday, 16 November 2025
जब आपके उपकरण स्वयं को ढालते हैं, अपने आप को धोखा देते हैं, और खुद को चुन लेते हैं
टिप्पणीः यह SANANACAS श्रृंखला में भाग ८ है । कैसे औज़ार स्वयं काम, ट्रैक उपयोग, जटिल, और समय से अधिक चतुर मिलता है.
टिप्पणीः अगर आपको लगता था कि इस काम में विकासवाद का हाथ है, तो जब तक आप देखते हैं तब तक इंतज़ार कीजिए कि क्या होता है प्रत्येक औज़ार एक ही क्षमता है.
भाग ७ में, मैंने आपको प्रत्यक्ष सिंथिक एवोल्यूशन दिखाया: काम करता हूँ कि योजना बनाता है, तैयार, काम करता है, विश्लेषण, और सुधार. मैं उल्लेख किया " उपकरण" बार का एक गुच्छा.
मैं यहाँ क्या समझा नहीं था:
ये उपकरण? वे स्थिर नहीं हैं. वे कॉन्फ़िगरेशन फ़ाइलें नहीं हैं जो वहाँ बैठे हैं.
वे रहते हैं कि:
अन्य शब्दों में: औज़ार नोड्स हैं। नोड्स उपकरण हैं। सब कुछ ई- मेल है।
और यह अजीब हो जाता है.
मैं आपको दिखाने के लिए क्या प्रणाली वास्तव में है:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
कि index.json? 5,464 पंक्तियाँ औज़ार परिभाषा, उपयोग, संस्करण इतिहास, अधिकतम अंक, और वंशावली ट्रैकिंग.
इसमें प्रत्येक औज़ार:
नोट: सिस्टम वास्तव में किसी भी औज़ार के साथ चला जाएगा. बस कम सहज से, और गूंगा. उनके बिना काम के औजारों के एक सामान्य भाग के रूप में तैयार किया जाएगा. यह अभी भी धीरे से समायोजन होगा लेकिन यह अधिक संकेतों के लिए ले जाएगा.
चलो एक उपकरण वास्तव में क्या है पर देखते हैं.
यहाँ तंत्र से एक वास्तविक औजार परिभाषा है:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
ध्यान दें कि वहाँ क्या है:
लेकिन यहाँ क्या है नहीं YAएमएल में:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
तंत्र रोग - मुक्त वर्तमान में सीखने के लिए स्थिर परिभाषा.
यहाँ क्या होता है जब आप किसी औज़ार का इस्तेमाल करते हैं:
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
क्या चला जाता है:
चलो कलिंग सुविधा को देखें.
सबसे चालाक बिट: तंत्र कैश औज़ार बहुत से स्तर पर प्रार्थना करता है.
स्तर 1: सटीक मिलान कैशिंग
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
ऐसा क्यों:
यदि आप प्रणाली से पूछें "हेरोकु" कोड के बारे में दो बार, दूसरा समय है इंस्टेंट. LLM नहीं चलता है. RAG मेमोरी परिणाम बताता है.
लेकिन यहाँ चतुर सा है: यह BEBT संस्करण लौटाता है बहुत से मौजूद हों.
उदाहरण:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
तंत्र उच्चतम- अनंत कैश को स्वतः चुनें परिणाम.
एक धूर्त लक्षण: प्रणाली यह जान लेती है कि हरेक मॉडल कितने समय तक प्रतिक्रिया दिखाता है ।
समस्या:
अलग - अलग मॉडलों में अलग - अलग प्रतिक्रियायाँ होती हैं:
tinyllama (2B): ~ 3 सेकण्डllama3 (8B): ~ 10 सेकण्डqwen2.5-coder (१४B): ~25 सेकण्डdeepseek-coder-v2 16B: ~60 सेकण्डयदि आप वैश्विक समय नियत करते हैं (say, 30), तो आप 27 सेकंड के लिए इंतजार कर रहे हैं tinyllama, और आप मार डाला deepseek इससे पहले कि यह खत्म हो जाए.
हल: एडाप्टिव सीखना
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
यह कैसे काम करता है:
परिणाम:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
तंत्र प्रत्येक मॉडल के लिए सही टाइमआउट को सीखता है वैश्विक मूल्य का उपयोग करने के बजाय.
जब आप तंत्र से कुछ करने के लिए पूछें, यह सिर्फ प्रथम मिलान औज़ार नहीं लेता. यह एक चलाता है कम्प्लीशन फंक्शन बहु आयामों के पार.
गणना अनुरूप:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
वास्तविक उदाहरण:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
चुने गएः email_validator_workflow (स्फीति: 19)
तंत्र चुन लेता है तेज, सुरक्षित, और स्थिर नहीं, सबसे शक्तिशाली नहीं ।
जो बहुत से प्रतिबन्धों को संतुष्ट करता है.
औज़ार स्थिर नहीं रहते।
संस्करण बदलना (p)
प्रत्येक औज़ार के पास एक है परिभाषा हैश इसकी YAएमएल से गणना की गई:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
जब आप किसी औज़ार का वायएएमएल संपादित करते हैं:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
अगला लोड पर:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
सेमेन्ट संस्करण:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
परिवर्तनों को तोड़ रहे हैं:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
लोड करने पर:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
तंत्र परिवर्तनों को तोड़ने के बारे में चेतावनी देता है और संस्करण इतिहास बनाए रखता है.
प्रत्येक औज़ार रीजी सर्च के लिए रीग्रेजी मेमोरी में सूचीबद्ध होता है:
लोड करने में समय:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
अब जब आप ढूंढते हैं:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
तंत्र उपयोग RAGEDances ताकि लोग नसीहत व इबरत हासिल करें बहु- विशेषता.
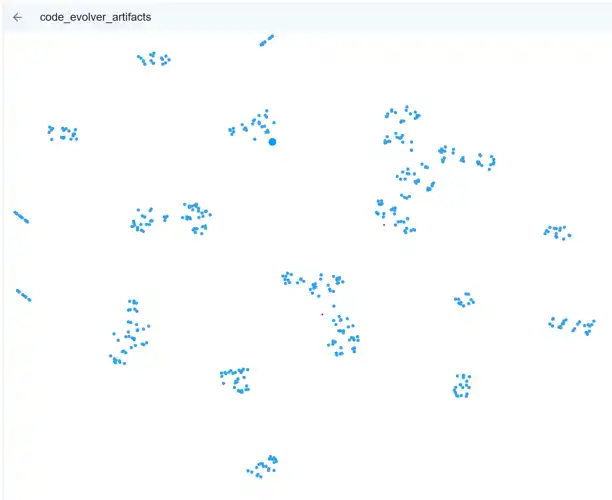
हमारे तंत्र में हम सदिशों को बचाने के लिए इन्जेक्शनों में स्केल्स एक वेक्टर डाटाबेस और यह हमें हमारे उपकरण क्षेत्र कैसे है देखने के लिए एक साफ तरीका देता है. यह हमारे काम के प्रवाह प्रणाली की स्मृति प्रणाली है.
मूल टेम्पलेट में विभाजित करें (याएमएल फ़ाइलें औजार डिरेक्ट्री में) तथा कोड के सभी अवयव जो कार्य को हल करने के लिए तैयार हैं (Lms). इन वस्तुओं को इकट्ठा करने के लिए यंत्रों के रूप में इस्तेमाल करने के लिए।
इस तरह काम करने के लिए हर पायथन तत्व की जांच की जाती है, BDDD, स्थिर औज़ारों को सही जांच करने के लिए सुनिश्चित करें कि यह काम किया जा रहा है.
किनारा प्रभाव प्रत्येक कोड का प्रत्येक टुकड़ा है जो एक कार्य प्रवाह में चलेगा सही है, प्रत्येक 'टो' रचना का निरीक्षण करने के लिए तैयार है।
आप भी एक तरह से जुड़े औज़ारों के रूप में एक साथ पूरी तरह से भरी हुई देख सकते हैं:
सभी गुच्छे एक साथ लगे. स्वाभाविक रूप से प्रणाली की प्रकृति द्वारा विशेष पता लगाना.
भविष्य में हम इन गुच्छों को कम करने के लिए संभव रूप से एक छोटे, तंग प्रणाली, कोड को कम करने के लिए इन गुच्छों को कम करना चाहते हैं.
जैसा कि हम ट्रैक संस्करण, उपयोग, परिवर्तन और झूठ परिवर्तन हम चयनात्मक रूप से प्रभावी रूप से इस्तेमाल कर सकते हैं और 'विल्षण' सबसे अधिक इस्तेमाल किया जा सकता है और सबसे अधिक प्रदर्शन प्रदर्शन प्रदर्शन प्रदर्शनों के रूप में इस तरह के एक भाग के रूप में क्या प्रणाली अनुचित रूप से संरचना है के रूप में।
चलो अब दुनिया में क्या वास्तव में मौजूद है देखो.
TLM औजार (27 विशेषज्ञ):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
एक्जीक्यूटेबल औज़ार:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
ओपनआईपीआई औज़ार: (u)
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
कुल औज़ार: 50+
मेटाडाटा की कुल पंक्तियाँ: में 5,464 पंक्तियाँ index.json
मैं आप प्रणाली में सबसे जटिल उपकरण दिखाता हूँ: कोड छुपाएँ (_o).
परिभाषा: tools/llm/code_optimizer.yaml (317 पंक्ति!)
यह क्या करता है:
लघुचित्रीकरण:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
लागत प्रबंधन:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
जांच संयोजन:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
संस्करण प्रबंधनः
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
यह एकल औज़ार स्वरः
और यह है सिर्फ एक औज़ार के साथ एक सिस्टम में 50+ उपकरण.
सबसे अधिक मेटा उपकरण में से एक: मॉडल चयन (_r).
प्राकृतिक भाषा चयन:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
यह कैसे काम करता है:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
सिस्टम प्राकृतिक भाषा का विश्लेषण करता है मॉडल चुनने के लिए आप कह सकते हैं:
और दाहिने हाथ वाले (वाह) दाहिने हाथ वालों का क्या कहना है
तंत्र बाहरी एपीआई को आंतरिक उपकरणों के रूप में वैसा ही व्यवहार करता है.
उदाहरण: एनएमटी अनुवादक
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
एट:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
क्या चला जाता है:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
बाहरी एपीआई एक ही उपचार मिलता है:
जंगल के एक उपकरण: कार्य प्रवाहित करें (_o).
यह क्या करता है:
कार्य प्रवाह लेता है (आ) main.py फ़ाइल और विस्तृत दस्तावेज़ स्वचलित तैयार करता है द्वारा:
README.txtसभी स्वचालित.
परिभाषा: tools/llm/workflow_documenter.yaml (11,803 अक्षर!)
इनपुट:
{
    "workflow_path": "nodes/email_validator/main.py"
}
आउटपुटः
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
Q: क्या यह सत्यापित कर सकता है यदि एक ईमेल मौजूद है? A: नहीं, यह सिर्फ वैध फॉर्मेट है. डीएनएस/ एसएसटीपी जाँच अस्तित्व के लिए प्रयोग करें.
Q: क्या यह अंतर्राष्ट्रीय डोमेनों का समर्थन करता है? एक: जी हाँ, लेकिन पारनीकोड परिवर्तन की ज़रूरत हो सकती है ।
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
उपयोक्ता: "मुझे एक औज़ार की आवश्यकता है जो तापमान को बदलता है"
सिस्टम:
नया औज़ार बनाया गया: तापक्रम_ गतिविधि
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
तंत्र पता है:
और यह इस डाटा का उपयोग करें को:
चलो कदम वापस करने के लिए और क्या हम वास्तव में निर्माण किया है के बारे में सोचते हैं:
एक तंत्र जहाँः
हम एक खुद को सूचित करने के लिए उपकरण है कि:
यह कॉन्फ़िगरेशन प्रबंधन नहीं है.
यह आड औज़ार अ- निर्दिष्ट होता है.
औज़ार स्थिर संसाधन नहीं हैं, वे कर रहे हैं विकासवाद की व्यवस्था में जीव - विज्ञान के बारे में.
उदाहरण 1: आत्म - परीक्षण पथ
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
मानव हस्तक्षेप के बिना तंत्र ने अपने स्वयं के कठिन पथ का समर्थन किया.
उदाहरण 2: [Ctrl+E]
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
तंत्र ने पैटर्न पहचान लिया तथा विशिष्ट औज़ार बनाया.
उदाहरण 3: कीमत चुकानी
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
इस व्यवस्था ने बेहतर परिणाम प्राप्त करने के लिए बुद्धिमानी से पैसा ख़र्च किया ।
मुझे कैटलॉग जो वास्तव में अभी मौजूद है.
कोड विशेषज्ञ
code_explainer - प्राकृतिक भाषा में कोड समझाइएcode_optimizer - हायरिकल पोषण (नॉला/ गहरी)code_reviewer - विशेषता और सुरक्षा समीक्षाfast_code_generator - छोटे मॉडलों के साथ त्वरित पीढ़ीsecurity_auditor - वुलर उपयोगिता स्कैनिंगperformance_profiler - कोड विश्लेषण तथा विश्लेषणसामग्री विशेषज्ञ:
long_form_writer - नोवेल्स, पुस्तकों (28के संदर्भ)content_generator - सामान्य अंतर्वस्तुarticle_analyzer - आलेख स्ट्रक्चर/ निरंतरताsummarizer -Sezes लंबी सामग्रीproofreader - ग्रामर और शैलीseo_optimizer - सीक्वेंशनoutline_generator - सामग्री आउटलाइनअनुवाद:
quick_translator - तीव्र अनुवाद (छोटा मॉडल)translation_quality_checker - अनुवाद पूर्ण करेंदस्तावेज़ीकरण:
doc_generator - कोड दस्तावेज़technical_writer - तकनीकी दस्तावेज़workflow_documenter - स्वचालित स्क्रॉल कार्य फलता हैतंत्र औज़ारः
general - सामान्य- पाक गे गेवmodel_selector - अच्छा बैकएण्ड/ विधि चुनता हैtask_to_workflow_router - फ्लो के लिए कार्य करने के लिए रूट कार्यquick_feedback - तीव्र जांचsignalr_connection_parser - व्याख्या सिग्नलआर कनेक्शनsignalr_llmapi_management - सिग्नल-RM API का प्रबंधन करेंवैधता:
call_tool_validator - कॉल_tool () प्रयोग का सत्यापन करता हैpython_syntax_validator - सिंटेक्स जाँचmypy_type_checker - स्थिर प्रकार जाँचjson_output_validator - JSON फार्मेट वैधstdin_usage_validator - गुप्त प्रयोग जा रहा हैmain_function_checker - मुख्य () फ़ंक्शन की जाँच करता हैnode_runtime_import_validator - आयात जा रहा हैविश्लेषण:
run_static_analysis - स्थिर विश्लेषण उपकरण चलाता हैperformance_profiler - प्रोफ़ाइल कोड प्रदर्शनयूटिलिटी:
save_to_disk - डिस्क लगनunit_converter - इकाई परिवर्तनrandom_data_generator - जाँच डाटा बनानाbuffer - बफर प्रबंधनworkflow_datastore -कामीय डाटा भंडारstream_processor - स्ट्रीम प्रक्रियाsse_stream - सर्वर भेजे गए कार्यक्रमसंयोजन:
connect_signalr - सिग्नलआर कनेक्शनsignalr_hub_connector - हब कनेक्शनsignalr_websocket_stream - वेबसॉकेट स्ट्रीमिंगदस्तावेज़ीकरण:
document_workflow - कार्य स्रोत:nmt_translator - तंत्रिका मशीन अनुवाद एपीआईकुल: 53 औज़ार (और ज्यादा)
यहाँ है जहां यह वास्तव में दिलचस्प हो जाता है: अन्य उपकरण बनाने हेतु उपकरण.
और जिस वक्त रुहें हवियों से मिला दी जाएंगी हर कार्य प्रवाह को स्वतः सुधारता है.
चलो एक वास्तविक संयुक्त औज़ार को तंत्र से देखें:
कार्य: "इस लेख को स्पेनी और वैध गुणवत्ता पर अनुवाद करें"
पारंपरिक पास:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
प्रतीत होता है:
तंत्र पता लगाने पर यह पैटर्न प्रायः उपयोग में लिया जाता है विविध औज़ारों को स्वचलित तैयार करता है:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
इस बारे में क्या जंगली है:
कब nmt_translator v2. 0 (शायद 20% तेजी से तेज़), संयुक्त औज़ार नए संस्करण का स्वतः उपयोग करें. कोई कोड परिवर्तन की आवश्यकता नहीं है.
परिणाम: हर काम का फ्लो validated_translator 20% तेजी से हो जाता है कोई परिवर्धन के बिना.
यहाँ एक भी शांत उदाहरण है: समानांतर औज़ार.
कार्य: "इस कोड को अच्छी तरह से लागू करें"
बगैर खून के सवाल:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
जैसा कि हमने देखा, आज हम एक - दूसरे के साथ कैसे पेश आ रहे हैं:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
चलाना:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
परिणाम: 35 सेकंड 20 सेकंड (43% तेजी से तेज़!)
और कब security_auditor V3. 0 (say, 30% तेजी से), पूरी समिति तेज़ी से स्वतः बन जाती है ।
यहाँ हिस्सा है कि असली जंगली है: जीन की तरह उपकरण कार्य करते हैं.
संबंध: जब औज़ार उपयोगी साबित होता है, यह तंत्र के माध्यम से छुपाएँ.
वास्तविक उदाहरण: गुण चेकर पैटर्न
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
यह सचमुच आनुवंशिक है:
कोड पथ हमेशा के लिए उपयुक्त है क्योंकि:
यहाँ वास्तव में चतुर सा है: आप एक साथ सभी औज़ारों को बेहतर बना सकते हैं.
उदाहरण: आपके पास 20 काम होते हैं, प्रत्येक 5-10 औज़ारों का उपयोग करता है. कुल: ~100 औज़ार प्रार्थना करते हैं.
पारंपरिक तंत्र:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
ड्राइवर सिस्टम: (S)
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
परिणाम:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
आपने एक औज़ार प्रशिक्षित किया है और बेहतर रूप से काम करने के लिए एक साथ काम किया है ।
वास्तव में जंगली हिस्सा: उन्नत ग्राफ के माध्यम से एवोल्यूशन कैट्सड.
उदाहरण:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
विकासवाद की एक घटना में सुधार आया और बिना किसी सुधार के काम जारी रहा ।
क्योंकि उपकरण ट्रैक विश्लेषण, कैश परिणाम, और ऑटोववव, सिस्टम हमेशा उपलब्ध कार्यान्वयन चलाता है.
उदाहरण चलाने के लिए:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
सिस्टम:
कोड पथ प्रत्येक चरण पर विकृत किया गया है:
चलो यह क्यों है के बारे में सटीक होना चाहिए सजीवित विकासवाद को निर्देशित करें और सिर्फ "मुँह दबाकर रहो।"
जीन के रूप में औज़ार:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
सीधे एवोल्यूशन
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
"रितोल":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
विजुअल विस्तारित दृश्यीकरण:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
फाईल का नाम %s
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
नैट, है ना?
हाँ, यह सच में जंगली है.
हमने एक सिस्टम बनाया है जहां:
यह एक लाक्षणिक नहीं है.
यह वास्तव में कृत्रिम विकास निर्देशित है.
सप्ताह के लिए इस तंत्र को चलाने के बाद:
यदि औज़ार हो सकते हैं:
आगे क्या होगा?
यहाँ क्या भाग 7 पूरी तरह से समझा नहीं था:
वे औज़ारों से बना रहे हैं। इन औज़ारों को बनाने के लिए जो औज़ार इस्तेमाल किए जाते हैं? विकासवाद पर विश्वास करने से क्या फायदे होते हैं? हाँ, औज़ार.
यह सभी तरह से नीचे उपकरण है.
और प्रत्येक व्यक्ति को,
हम एक कोड जनक नहीं बना था.
हमने एक स्वयं को बदनाम किया, खुद को बदनाम कर लिया, खुद को हल करने के उपकरण लगता है कि कोड तैयार करने के लिए होता है.
भिन्न - भिन्न - भिन्न बात ।
क्योंकि जब उपकरण विकास इकाइयों बन जाते हैं, जब वे अपनी स्वाभाविकता का प्रयोग करते हैं, जब वे जन्म देते हैं और संघर्ष करते हैं...
आपके पास औज़ार-बाक्स नहीं है.
आप एक मुसीबत है.
और रोज़मर्रा की मालूली चीज़ें भी आरियत नहीं देते
लेकिन जब विकासवाद का असर होता है, तब क्या होता है? जब एक औज़ार उत्परिवर्तन किसी गंभीर बग को प्रस्तुत करता है? जब समायोजन करने के बजाए उपकरण बेहतर होता है?
यही कारण है कि जहाँ भाग 9 में आता है, हम परीक्षण करते हैं अपनी पत्नी का हाल यह है कि वह अपने आपको बड़ा समझता है,- एक प्रणाली जहां उपकरण केवल विकसित नहीं करते हैं, वे याद करते हैं हर विफलता, शाखाओं में विफल, और उस ज्ञान को बढ़ावा देते हैं कि पूरे पर्यावरण में समान ग़लतियों को रोकने के लिए।
जब आपके औज़ार खुद को तोड़ सकते हैं, तब आपके तंत्र को याद रखना चाहिए कि गलती क्यों और कभी - भी क्यों नहीं दोहराएँ ।
रेपोसिटरीः अधिकतर अल्पपारदर्शिता.
कुंजी फ़ाइलें:
src/tools_manager.py (2,23 पंक्ति) - कोर उपकरण प्रबंधनsrc/rag_integrated_tools.py (562 पंक्तियाँ) - RAG एकीकरणsrc/openapi_tool.py (313 पंक्ति) - ओपनपीआई समर्थनsrc/model_selector_tool.py (4)60 पंक्तियाँ - मॉडल चयनtools/index.json (5,464 पंक्तियाँ) - औजार रजिस्ट्रीtools/llm/*.yaml (27 उपकरण) -LMS विशेषज्ञ परिभाषाtools/executable/*.yaml (१९ उपकरण) - एक्जीक्यूटेबल उपकरणtools/openapi/*.yaml (3 औज़ार) - API का संयोजनदस्तावेज़ीकरण:
LLMS_AS_TOOLS.md -LM चयन सिस्टमWORKFLOW_DOCUMENTATION_TOOL.md - स्वचालित सुधारCHAT_TOOLS_GUIDE.md - औजार उपयोग गाइडTOOL_PACKAGING.md - उपकरण विकास मार्गदर्शनश्रेणी नेविगेशन:
यह SATANACAS श्रृंखला में 8 भाग है. भाग 7 ने पूरे एग्मीशन डिजाइन को दिखाया. इस लेख में छुपे जटिलता प्रकट होती है: तंत्र ट्रैकों के प्रयोग में प्रत्येक औजार, घातित कार्यान्वयन, कैश परिणाम, और महत्वपूर्ण रूप से आधारित चयन में हिस्सा लेते हैं. उपकरण सिर्फ एक संसाधन नहीं है, यह एक विकासक है कि विकसित करता है, और सारे औज़ारों को बेहतर बनाता है.
कोड वास्तविक है, ओलमा पर स्थानीय चल रहा है, वास्तव में मुझे ट्रैक, और वास्तव में ई. यह प्रयोग किया जाता है, कभी कभी-कभी अस्थिर, और निश्चित रूप से "व-कोड" उपकरण काम, ट्रैकिंग कार्य, और विकास.
"एस.एस.एस.टि.) के बारे में Secuts और तंत्रों के अर्थों से जुड़ता है जो खुद को निर्धारित करते हैं. इस उपकरण के बारे में वास्तविक कार्यान्वयन प्रदर्शन कर रहे हैं कि विकास दबाव विशेष रूप से विशिष्ट बनाने, और कैसे आत्म - परीक्षण व्यवस्थाएँ स्वाभाविक रूप से विकसित होती हैं. क्या यह ग्रह के उपकरण को पूरी तरह से प्रभावित करता है, या क्या यह एक पूरी तरह से देखने के लिए बना हुआ है कि क्या यह एक प्रयोग किया जा रहा है.
टैगः #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
