This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Sunday, 16 November 2025
Kun työkalut seuraavat itseään, kehittyvät ja valitsevat itsensä
Huomaa: Tämä on osa 8 Semantic Intelligence -sarjassa. Osa 7 käsitteli DSE:n kokonaisarkkitehtuuria. Tämä artikkeli sukeltaa syvälle johonkin, jota kaunistelin: miten työkalut itse toimivat, jäljittävät käyttöä, kehittyvät ja muuttuvat ajan myötä älykkäämmiksi.
Huomaa: Jos luulit osan 7 työnkulun evoluution olevan villiä, odota kunnes näet, mitä tapahtuu, kun joka ikinen työkalu hänellä on samat kyvyt.
Osassa 7 näytin sinulle ohjatun synteettisen evoluution: työnkulkuja, jotka suunnittelevat, tuottavat, toteuttavat, arvioivat ja parantavat. Mainitsin "työkalut" useita kertoja.
Tätä en selittänyt:
Työkalut eivät ole staattisia, ne eivät ole kokoonpanotiedostoja, jotka istuvat siinä muuttumattomina.
Ne ovat eläviä esineitä, jotka:
Toisin sanoen: Työkalut ovat solmukohtia, solmut työkaluja, kaikki kehittyy.
Ja se muuttuu oudommaksi.
Näytän, mitä järjestelmässä oikeasti on:
$ ls -la tools/
drwxr-xr-x  llm/          # LLM-based tools (27 specialists)
drwxr-xr-x  executable/   # Executable validators/generators
drwxr-xr-x  openapi/      # External API integrations
drwxr-xr-x  custom/       # User-defined tools
-rw-r--r--  index.json    # 5,464 lines of tool metadata
Tuo index.json? 5 464 riviä Työkalumääritelmistä, käyttötilastoista, versiohistoriasta, kuntotuloksista ja linjan seuraamisesta.
Jokainen työkalu siellä:
HUOMAUTUS: Järjestelmä toimii ilman työkaluja. Vain vähemmän tehokkaasti, ja tyhmemmin. Ilman niitä työkalut syntyisivät normaalina osana työnkulun hajoamista. Se sopeutuisi silti hitaasti, mutta se veisi Awaylta enemmän kuponkeja.
Katsotaanpa, mikä työkalu oikeastaan on.
Tässä todellinen työkalun määritelmä järjestelmästä:
tools/llm/long_form_writer.yaml
name: "Long-Form Content Writer"
type: "llm"
description: "Specialized for writing long-form content (novels, books, long articles) using mistral-nemo's massive 128K context window."

cost_tier: "high"
speed_tier: "slow"
quality_tier: "excellent"
max_output_length: "very-long"

llm:
  model: "mistral-nemo"
  endpoint: null
  system_prompt: "You are a creative writer specializing in long-form content. You have a massive 128K token context window..."
  prompt_template: "{prompt}\n\nPrevious context:\n{context}\n\nGenerate the next section maintaining consistency."

tags: ["creative-writing", "novel", "story", "long-form", "article", "book", "large-context"]
Huomaa, mitä siellä on:
Mutta tässä on, mitä ei yaML:ssa:
# Auto-generated at runtime:
tool.usage_count = 47           # How many times used
tool.version = "1.2.0"          # Semantic versioning
tool.definition_hash = "a3f5..."# Change detection
tool.quality_score = 0.89       # From evaluations
tool.avg_latency_ms = 12_400    # Performance tracking
tool.last_updated = "2025-11-15"
Järjestelmä Lisäaineet staattiset määritelmät, joihin liittyy juoksunaikainen oppiminen.
Näin käy, kun käyttää työkalua:
# User request
result = tools_manager.invoke_llm_tool(
    tool_id="long_form_writer",
    prompt="Write a romance novel chapter"
)

# Behind the scenes:
sequenceDiagram
    participant U as User
    participant TM as ToolsManager
    participant RAG as RAG Memory
    participant LLM as Long Form Writer
    participant Metrics as Metrics Tracker

    U->>TM: invoke_llm_tool("long_form_writer", prompt)

    TM->>RAG: Check cache (tool + prompt hash)

    alt Cache Hit
        RAG-->>TM: Cached response (v1.2.0, fitness: 0.89)
        TM->>Metrics: Increment cache_hits
        TM-->>U: Return cached result ✓
    else Cache Miss
        TM->>Metrics: Start timer
        TM->>LLM: Generate response
        LLM-->>TM: Response
        TM->>Metrics: Record latency, quality
        TM->>RAG: Store invocation with metadata
        TM->>TM: Update tool.usage_count++
        TM-->>U: Return result
    end

    TM->>Metrics: Update adaptive timeout stats
    TM->>RAG: Update tool fitness score
Mikä jäljitetään:
Katsotaanpa välimuistia.
Nerokkain kohta: Järjestelmän välimuistit -työkalu houkuttelee useilla tasoilla.
Taso 1: Täsmällinen otteluvälimuisti
def invoke_llm_tool(self, tool_id: str, prompt: str) -> str:
    """Invoke LLM tool with hierarchical caching."""

    # Normalize prompt for exact matching
    normalized_prompt = prompt.lower().strip()

    # Search RAG for previous invocations
    tool_invocations = self.rag_memory.find_by_tags(
        ["tool_invocation", tool_id],
        limit=100
    )

    # Find ALL exact matches for this tool + prompt
    matches = []
    for artifact in tool_invocations:
        cached_prompt = artifact.metadata.get("user_prompt", "").lower().strip()
        if cached_prompt == normalized_prompt:
            # Collect fitness and version
            matches.append({
                "artifact": artifact,
                "fitness": artifact.metadata.get("fitness_score", 0.0),
                "version": artifact.metadata.get("version", "1.0.0"),
                "timestamp": artifact.metadata.get("timestamp", 0)
            })

    if matches:
        # Select LATEST, HIGHEST FITNESS version
        best_match = sorted(
            matches,
            key=lambda m: (m["fitness"], m["timestamp"]),
            reverse=True
        )[0]

        logger.info(
            f"✓ CACHE HIT: Reusing result for '{tool.name}' "
            f"(version {best_match['version']}, fitness {best_match['fitness']:.2f})"
        )

        # Increment usage counters
        self.increment_usage(tool_id)
        self.rag_memory.increment_usage(artifact.artifact_id)

        return best_match["artifact"].content
Miksi tällä on merkitystä:
Jos pyydät järjestelmää "kirjoittamaan haikun koodista" kahdesti, toinen kerta on instant. LLM ei toimi. RAG-muisti palauttaa välimuistin tuloksen.
Mutta tässä on se nerokas kohta: se palauttaa BEST-version jos useita on olemassa.
Esimerkki:
Invocation 1: "write a haiku about code"
  → Generated with tool v1.0.0
  → Fitness: 0.75
  → Stored in RAG

Invocation 2: "write a haiku about code" (exact match!)
  → Tool evolved to v1.1.0
  → Fitness: 0.92 (better!)
  → Stored in RAG

Invocation 3: "write a haiku about code"
  → Finds BOTH cached versions
  → Selects v1.1.0 (higher fitness + later timestamp)
  → Returns best result instantly
Järjestelmä Valitsee automaattisesti korkealaatuisimman välimuistituloksen.
Yksi hienovaraisempi ominaisuus: järjestelmä oppii, kuinka kauan kunkin mallin reagointi kestää.
Ongelma:
Erilaisilla malleilla on hurjan erilaiset vastausajat:
tinyllama (2B): ~3 sekuntiallama3 (8B): ~10 sekuntiaqwen2.5-coder (14B): ~25 sekuntiadeepseek-coder-v2 (16B): ~60 sekuntiaJos asetat maailmanlaajuisen aikalisän (esim. 30-luku), tuhlaat 27 sekuntia odotellessasi tinyllamaJa sinä tapat deepseek ennen kuin se loppuu.
Ratkaisu: sopeutumiskykyistä oppimista
def _update_adaptive_timeout(
    self,
    model: str,
    tool_id: str,
    response_time: float,
    timed_out: bool,
    prompt_length: int
):
    """Learn optimal timeout from actual performance."""

    # Get existing stats
    stats_id = f"timeout_stats_{model.replace(':', '_')}"
    existing = self.rag_memory.get_artifact(stats_id)

    if existing:
        response_times = existing.metadata.get("response_times", [])
        timeout_count = existing.metadata.get("timeout_count", 0)
        success_count = existing.metadata.get("success_count", 0)
    else:
        response_times = []
        timeout_count = 0
        success_count = 0

    # Update stats
    if timed_out:
        timeout_count += 1
    else:
        success_count += 1
        response_times.append(response_time)
        response_times = response_times[-50:]  # Keep last 50

    # Calculate recommended timeout (95th percentile + 20% buffer)
    if response_times:
        sorted_times = sorted(response_times)
        p95_index = int(len(sorted_times) * 0.95)
        p95_time = sorted_times[min(p95_index, len(sorted_times) - 1)]
        recommended_timeout = int(p95_time * 1.2)

        logger.info(
            f"Adaptive timeout for {model}: {recommended_timeout}s "
            f"(based on {len(response_times)} samples)"
        )
Miten se toimii:
Tulokset:
Model: tinyllama
  Samples: 50
  95th percentile: 3.2s
  Recommended timeout: 4s  (3.2 * 1.2)

Model: qwen2.5-coder:14b
  Samples: 50
  95th percentile: 28.5s
  Recommended timeout: 34s  (28.5 * 1.2)
Järjestelmä opettelee oikean aikalisän jokaiselle mallille sen sijaan, että käytettäisiin globaalia arvoa.
Kun järjestelmää pyytää tekemään jotain, se ei valitse vain ensimmäistä vastaavaa työkalua. fitness-toiminto Moniulotteinen.
Kuntolaskenta:
def calculate_fitness(tool, similarity_score):
    """
    Calculate overall fitness score (0-100+).

    Factors:
    - Semantic similarity (how well it matches the task)
    - Speed (fast tools get bonus)
    - Cost (cheap tools get bonus)
    - Quality (high-quality tools get bonus)
    - Historical success rate~~~~
    - Latency metrics
    - Reuse potential
    """
    fitness = similarity_score * 100  # Base: 0-100

    metadata = tool.metadata or {}

    # Speed bonus/penalty
    speed_tier = metadata.get('speed_tier', 'medium')
    if speed_tier == 'very-fast':
        fitness += 20
    elif speed_tier == 'fast':
        fitness += 10
    elif speed_tier == 'slow':
        fitness -= 10
    elif speed_tier == 'very-slow':
        fitness -= 20

    # Cost bonus (cheaper = better for most tasks)
    cost_tier = metadata.get('cost_tier', 'medium')
    if cost_tier == 'free':
        fitness += 15
    elif cost_tier == 'low':
        fitness += 10
    elif cost_tier == 'high':
        fitness -= 10
    elif cost_tier == 'very-high':
        fitness -= 15

    # Quality bonus
    quality_tier = metadata.get('quality_tier', 'good')
    if quality_tier == 'excellent':
        fitness += 15
    elif quality_tier == 'very-good':
        fitness += 10
    elif quality_tier == 'poor':
        fitness -= 15

    # Success rate from history
    quality_score = metadata.get('quality_score', 0)
    if quality_score > 0:
        fitness += quality_score * 10  # 0-10 bonus

    # Latency metrics
    latency_ms = metadata.get('latency_ms', 0)
    if latency_ms > 0:
        if latency_ms < 100:
            fitness += 15  # Very fast
        elif latency_ms < 500:
            fitness += 10
        elif latency_ms > 5000:
            fitness -= 10  # Too slow

    # Reuse bonus: existing workflow = less effort
    if tool.tool_type == ToolType.WORKFLOW:
        if similarity >= 0.90:
            fitness += 30  # Exact match!
        elif similarity >= 0.70:
            fitness += 15  # Template reuse

    return fitness
Todellinen esimerkki:
Task: "Quickly validate this email address"

Tools found:
1. email_validator_workflow (similarity: 0.95)
   - Speed: very-fast (+20)
   - Cost: free (+15)
   - Quality: excellent (+15)
   - Latency: 45ms (+15)
   - Reuse: exact match (+30)
   → FINAL FITNESS: 190

2. general_validator (similarity: 0.70)
   - Speed: medium (+0)
   - Cost: free (+15)
   - Quality: good (+10)
   - Latency: 850ms (+0)
   - Reuse: none (+0)
   → FINAL FITNESS: 95

3. llm_based_validator (similarity: 0.65)
   - Speed: slow (-10)
   - Cost: high (-10)
   - Quality: excellent (+15)
   - Latency: 8200ms (-10)
   - Reuse: none (+0)
   → FINAL FITNESS: 50
Valitut: email_validator_workflow (kuntoisuus: 190)
Järjestelmä valitsee nopea, ilmainen, laadukas, todistettu Ratkaisu ei ole semanttisimman kaltainen eikä voimakkain.
Se, joka täyttää optimaalisesti useita rajoitteita.
Työkalut eivät pysy paikallaan, vaan kehittyvät.
Muunnetaan ja muutetaan havaintoa:
Jokaisessa työkalussa on määritelmä hash laskettu sen yaML-arvosta:
def calculate_tool_hash(tool_def: Dict[str, Any]) -> str:
    """SHA256 hash of tool definition for change detection."""
    stable_json = json.dumps(tool_def, sort_keys=True)
    return hashlib.sha256(stable_json.encode('utf-8')).hexdigest()
Kun muokkaat työkalun YAML:
# BEFORE (v1.0.0)
name: "Email Validator"
tags: ["email", "validation"]

# AFTER (edit the YAML)
name: "Email Validator"
tags: ["email", "validation", "dns-check"]  # Added DNS checking!
Seuraavalla kuormalla:
# System detects change
new_hash = calculate_tool_hash(tool_def)  # Different!
old_hash = existing_tool.definition_hash

if old_hash != new_hash:
    # Determine change type
    change_type = tool_def.get("change_type", "patch")  # minor, major, patch

    # Bump version
    old_version = "1.0.0"
    new_version = bump_version(old_version, change_type)
    # new_version = "1.1.0" (minor change)

    console.print(
        f"[yellow]↻ Updated email_validator "
        f"v{old_version} → v{new_version} ({change_type})[/yellow]"
    )
Semanttinen versiointi:
def bump_version(current_version: str, change_type: str) -> str:
    """Bump semver based on change type."""
    major, minor, patch = map(int, current_version.split('.'))

    if change_type == "major":
        return f"{major + 1}.0.0"  # Breaking changes
    elif change_type == "minor":
        return f"{major}.{minor + 1}.0"  # New features
    else:  # patch
        return f"{major}.{minor}.{patch + 1}"  # Bug fixes
Muutosten murtaminen:
name: "Email Validator"
version: "2.0.0"
change_type: "major"
breaking_changes:
  - "Changed return format from boolean to object"
  - "Removed deprecated 'simple_check' parameter"
  - "Now requires 'domain' to be specified"
Kuormattuna:
[yellow]↻ Updated email_validator v1.3.2 → v2.0.0 (major)[/yellow]
  [red]! Breaking changes:[/red]
    - Changed return format from boolean to object
    - Removed deprecated 'simple_check' parameter
    - Now requires 'domain' to be specified
Järjestelmä varoittaa murtamasta muutoksia ja ylläpitää versiohistoriaa.
Jokainen työkalu indeksoidaan RAG-muistiin semanttiseen hakuun:
Kuorma-ajalla:
def _store_yaml_tool_in_rag(self, tool: Tool, tool_def: dict, yaml_path: str):
    """Store YAML tool in RAG for semantic search."""

    # Build comprehensive content for embedding
    content_parts = [
        f"Tool: {tool.name}",
        f"ID: {tool.tool_id}",
        f"Type: {tool.tool_type.value}",
        f"Description: {tool.description}",
        f"Tags: {', '.join(tool.tags)}",
        ""
    ]

    # Add input/output schemas
    if tool_def.get("input_schema"):
        content_parts.append("Input Parameters:")
        for param, desc in tool_def["input_schema"].items():
            content_parts.append(f"  - {param}: {desc}")

    # Add examples
    if tool_def.get("examples"):
        content_parts.append("Examples:")
        for example in tool_def["examples"]:
            content_parts.append(f"  {example}")

    # Add performance tiers
    content_parts.append("Performance:")
    content_parts.append(f"  Cost: {tool_def['cost_tier']}")
    content_parts.append(f"  Speed: {tool_def['speed_tier']}")
    content_parts.append(f"  Quality: {tool_def['quality_tier']}")

    # Add full YAML
    import yaml
    content_parts.append("Full Definition:")
    content_parts.append(yaml.dump(tool_def))

    tool_content = "\n".join(content_parts)

    # Store in RAG with metadata
    self.rag_memory.store_artifact(
        artifact_id=f"tool_{tool.tool_id}",
        artifact_type=ArtifactType.PATTERN,
        name=tool.name,
        description=tool.description,
        content=tool_content,
        tags=["tool", "yaml-defined", tool.tool_type.value] + tool.tags,
        metadata={
            "tool_id": tool.tool_id,
            "tool_type": tool.tool_type.value,
            "is_tool": True,
            "version": tool_def.get("version", "1.0.0"),
            "cost_tier": tool_def.get("cost_tier"),
            "speed_tier": tool_def.get("speed_tier"),
            "quality_tier": tool_def.get("quality_tier")
        },
        auto_embed=True  # Generate embedding!
    )
Nyt kun etsit:
# Semantic tool search
results = tools_manager.search("email validation", top_k=5)

# Results (ranked by fitness, not just similarity):
[
    Tool(id="email_validator", fitness=190, similarity=0.95),
    Tool(id="domain_checker", fitness=140, similarity=0.82),
    Tool(id="regex_validator", fitness=110, similarity=0.78),
    Tool(id="general_validator", fitness=95, similarity=0.70),
    Tool(id="string_validator", fitness=60, similarity=0.65)
]
Järjestelmä käyttää LÄHKÖISYYSSUUNNITELMAT löytää tarvittavat työkalut, sitten riveihin ne moniulotteinen kuntoilu.
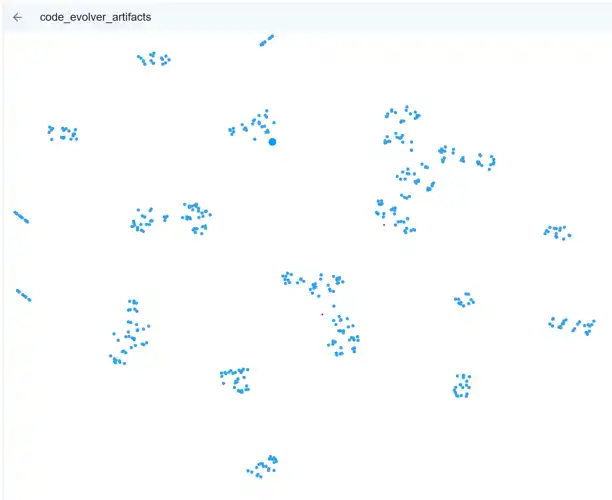
Järjestelmässämme säästämme vektorit upotuksille Qdrant vektoritietokanta ja se antaa meille siistin tavan nähdä, kuinka työkalutilamme toimii. Tämä on työvirran rakennusjärjestelmämme muistijärjestelmä.
Jaettuna alkuperäisiin malleihin (jaml-tiedostoihin työkaluhakemistossa) ja jokaiseen koodielementtiin, joka on luotu jonkin tehtävän ratkaisemiseksi (ja llms:n konfigurointiin jne.). Työkalujen kokoamiseen tarkoitetut työkalupakit. Esirakennetut kappaleet vaihtelevat:
Näin kaikki työtaso on sävellettävä ja testattavissa, koska jokaisessa Python-elementissä on sarja testejä, BDD-spektejä, staattisia työkaluja, joilla voidaan todentaa korrektius ja useita LLM-arvioijia sen toimivuuden varmistamiseksi.
Sivuvaikutus on JOKAinen koodinpala, joka kulkee työnkulussa, on tässä, valmiina tarkastamaan, kun jokainen "työkalu" luomi johtaa tarkastettavaan Python-sähkeeseen.
Voit nähdä, kuinka toosit kasaantuvat yhteen, kun jokainen blobi on semantaalisesti yhdistetty joukko työkaluja, kuten:
Kaikki ovat kokoontuneet yhteen. Luonnollisesti erikoistuneet järjestelmän luonteeseen.
Tulevaisuudessa haluaisimme todennäköisesti optimoida nämä klusterit, jotta koodipohja saataisiin pienemmäksi, tiukemmaksi ja optimoidummaksi järjestelmäksi.
Kuten voimme seurata versioita, käyttötapoja, muutoksia ja valhetta, voimme valikoiden optimoida ja "klusteri defrag" käyttää eniten ja useimpia suorituskykykriittisiä yhdistelmiä osana järjestelmän rakenteellista rakennetta.
Katsotaanpa, mitä järjestelmässä todella on nyt.
LLM Tools (27 asiantuntijaa):
$ ls tools/llm/
article_analyzer.yaml          # Analyzes articles for structure/quality
code_explainer.yaml            # Explains code in natural language
code_optimizer.yaml            # Hierarchical optimization (local/cloud/deep)
code_reviewer.yaml             # Reviews code for quality/security
content_generator.yaml         # General content generation
doc_generator.yaml             # Generates documentation
fast_code_generator.yaml       # Quick code generation (small models)
general.yaml                   # General-purpose fallback
long_form_writer.yaml          # Novels, books (128K context!)
model_selector.yaml            # Selects best backend/model
performance_profiler.yaml      # Profiles code performance
quick_feedback.yaml            # Fast triage/feedback
quick_translator.yaml          # Fast translation
security_auditor.yaml          # Security vulnerability scanning
signalr_connection_parser.yaml # Parses SignalR connections
signalr_llmapi_management.yaml # Manages SignalR LLM API
summarizer.yaml                # Summarizes long content
task_to_workflow_router.yaml  # Routes tasks to workflows
technical_writer.yaml          # Technical documentation
translation_quality_checker.yaml # Validates translations
workflow_documenter.yaml       # Auto-generates workflow docs
Suoritettavat työkalut:
$ ls tools/executable/
call_tool_validator.yaml       # Validates call_tool() usage
connect_signalr.yaml           # SignalR connection tool
document_workflow.yaml         # Workflow documentation generator
mypy_type_checker.yaml         # Static type checking
python_syntax_validator.yaml   # Syntax validation
run_static_analysis.yaml       # Static analysis runner
save_to_disk.yaml              # Disk persistence
signalr_hub_connector.yaml     # Hub connection
signalr_websocket_stream.yaml  # WebSocket streaming
unit_converter.yaml            # Unit conversion utilities
OpenAPI-työkalut:
$ ls tools/openapi/
nmt_translator.yaml            # Neural machine translation API
Työkalut yhteensä: 50+
Metadatan kokonaislinjat: 5 464 riviä index.json
Näytän teille järjestelmän hienostuneimman työkalun: Code_optimizer.
Määritelmä: tools/llm/code_optimizer.yaml (317 riviä!)
Mitä se tekee:
Hierarkkinen optimointi:
optimization_levels:
  - name: "local"
    model_key: "escalation"  # qwen2.5-coder:14b
    cost_usd: 0.0
    expected_improvement: 0.10  # 10%
    triggers:
      - "Default for all optimizations"
      - "Quick wins, obvious inefficiencies"

  - name: "cloud"
    model_key: "cloud_optimizer"  # GPT-4/Claude
    cost_usd: 0.50
    expected_improvement: 0.30  # 30%
    triggers:
      - "Local improvement < 15%"
      - "Code is critical path"
      - "User explicitly requests it"

  - name: "deep"
    model_key: "deep_analyzer"
    cost_usd: 5.0
    expected_improvement: 0.50  # 50%
    triggers:
      - "Workflow/system-level optimization"
      - "Cloud improvement < 25%"
      - "Architectural changes needed"
Kustannusten hallinta:
cost_management:
  max_daily_budget: 50.0  # USD
  fallback_on_budget_exceeded: "local"

  optimization_strategy: |
    1. Always try LOCAL first (free)
    2. Escalate to CLOUD if:
       - Local improvement < 15%
       - Reuse count > 100
    3. Escalate to DEEP if:
       - Cloud improvement < 25%
       - System-level changes needed
Testien integrointi:
test_integration:
  auto_update: true
  test_discovery:
    - "Find test_*.py in tests/"
    - "Identify tests for specific functions"
  test_generation:
    - "Generate missing tests"
    - "Add performance assertions"
    - "Create regression tests"
Versionhallinta:
version_management:
  semver: true
  breaking_change_detection:
    - "Function signature changed"
    - "Return type changed"
    - "Dependencies added/removed"

  auto_migration:
    enabled: true
    conditions:
      - "No breaking changes"
      - "All tests pass"
      - "Improvement >= 10%"
Tämä yksi työkalu Orkesterit:
Ja se on vain yksi työkalu Järjestelmässä, jossa 50+ työkalua.
Yksi metatyökaluista: Model_selector.
Luonnollinen kielivalinta:
# User says: "using the most powerful code llm review this code"

selection = tools_manager.invoke_llm_tool(
    tool_id="model_selector",
    prompt="using the most powerful code llm review this code"
)

# Result:
{
    "backend": "anthropic",
    "model": "claude-3-opus-20240229",
    "reasoning": "Request specifies 'most powerful'. Claude Opus is the highest-quality code model.",
    "confidence": 0.95,
    "cost_tier": "very-high",
    "speed_tier": "slow",
    "quality_tier": "exceptional"
}
Miten se toimii:
def select_model(
    self,
    task_description: str,
    constraints: Optional[Dict[str, Any]] = None
) -> List[Dict[str, Any]]:
    """Select best model for task."""

    task_lower = task_description.lower()

    # Parse natural language preferences
    backend_preference = None
    if any(kw in task_lower for kw in ["openai", "gpt"]):
        backend_preference = "openai"
    elif any(kw in task_lower for kw in ["anthropic", "claude"]):
        backend_preference = "anthropic"

    # Parse model preference
    model_preference = None
    if "gpt-4o" in task_lower:
        model_preference = "gpt-4o"
    elif "opus" in task_lower:
        model_preference = "opus"

    # Analyze task characteristics
    needs_long_context = any(w in task_lower for w in
        ["book", "novel", "document", "large", "long"])
    needs_coding = any(w in task_lower for w in
        ["code", "function", "script", "program"])
    needs_speed = any(w in task_lower for w in
        ["quick", "fast", "immediate"])
    needs_quality = any(w in task_lower for w in
        ["complex", "analysis", "reasoning"])

    # Score each model
    scores = {}
    for backend_model_id, info in self.backends.items():
        score = 50.0  # Base

        # Backend preference
        if backend_preference and info["backend"] == backend_preference:
            score += 50

        # Model preference
        if model_preference and model_preference in info["model"].lower():
            score += 100  # Strong boost

        # Context window
        if needs_long_context:
            context = info.get("context_window", 8192)
            if context >= 100000:
                score += 40

        # Speed
        if needs_speed:
            if info["speed"] == "very-fast":
                score += 30

        # Quality
        if needs_quality:
            if info["quality"] == "excellent":
                score += 30

        # Specialization
        if needs_coding:
            if "code" in info.get("best_for", []):
                score += 35

        scores[backend_model_id] = score

    # Return top-ranked models
    ranked = sorted(scores.items(), key=lambda x: x[1], reverse=True)
    return [self.backends[bid] for bid, score in ranked[:3]]
Järjestelmä jäsentää luonnollista kieltä Valitkaa mallit. Voitte sanoa:
Ja se kulkee älykkäästi oikeaan takaosaan.
Järjestelmä kohtelee ulkoisia sovellusliittymiä samoin kuin sisäisiä työkaluja.
Esimerkki: NMT Translator
name: "NMT Translation Service"
type: "openapi"
description: "Neural machine translation API. VERY FAST but needs validation."

cost_tier: "low"
speed_tier: "very-fast"
quality_tier: "good"

openapi:
  spec_url: "http://localhost:8000/openapi.json"
  base_url: "http://localhost:8000"

code_template: |
  import requests

  def translate_text(text, source_lang="en", target_lang="de"):
      url = "http://localhost:8000/translate"
      params = {
          "text": text,
          "source_lang": source_lang,
          "target_lang": target_lang
      }
      response = requests.get(url, params=params)
      return response.json()["translations"][0]

tags: ["translation", "nmt", "api", "external"]
Ajon aikana:
# System loads OpenAPI spec
openapi_tool = OpenAPITool(
    tool_id="nmt_translator",
    spec_url="http://localhost:8000/openapi.json"
)

# Parses operations
operations = openapi_tool.list_operations()
# [
#   {"operation_id": "translate", "method": "GET", "path": "/translate"},
#   {"operation_id": "get_languages", "method": "GET", "path": "/languages"}
# ]

# Invoke
result = tools_manager.invoke_openapi_tool(
    "nmt_translator",
    "translate",
    parameters={"text": "hello", "source_lang": "en", "target_lang": "de"}
)

# Result: {"success": True, "data": {"translations": ["Hallo"]}}
Mikä jäljitetään:
# Stored in RAG:
{
    "artifact_type": "API_INVOCATION",
    "tool_id": "nmt_translator",
    "operation_id": "translate",
    "status_code": 200,
    "success": True,
    "latency_ms": 124,
    "parameters": {"text": "hello", "source_lang": "en", "target_lang": "de"},
    "response": {"translations": ["Hallo"]}
}
Ulkoiset rajapinnat saavat saman kohtelun:
Yksi villeimmistä työkaluista: Työnkulku_dokumentaattori.
Mitä se tekee:
Vaatii työnkulun (a main.py tiedosto) ja luo automaattisesti kattavan dokumentoinnin Seuraavilla tekijöillä:
README.txtKaikki automaattisesti.
Määritelmä: tools/llm/workflow_documenter.yaml (11.803 merkkiä!)
Syöte:
{
    "workflow_path": "nodes/email_validator/main.py"
}
Tuloste:
## Overview
Validates email addresses and optionally checks domain matching.

## What It Does
This workflow checks if an email address is valid using regex.
If you provide a domain, it checks if the email belongs to that domain.

## Required Inputs
- **email** (string, required)
  - The email address to validate
  - Example: "[email protected]"

- **domain** (string, optional)
  - The domain to check against
  - Example: "example.com"

## Process Flow
```mermaid
flowchart TD
    A[Start: Receive Input] --> B[Extract email and domain]
    B --> C{Email provided?}
    C -->|No| D[Error: email required]
    C -->|Yes| E[Validate email format]
    E --> F{Valid format?}
    F -->|No| G[Return: invalid]
    F -->|Yes| H{Domain provided?}
    H -->|No| I[Return: valid]
    H -->|Yes| J[Extract email domain]
    J --> K{Domains match?}
    K -->|Yes| I
    K -->|No| L[Return: domain_mismatch]
curl -X POST http://localhost:8080/execute/email_validator \
  -H "Content-Type: application/json" \
  -d '{"email": "[email protected]", "domain": "example.com"}'
result = call_tool("email_validator", {
    "email": "[email protected]",
    "domain": "example.com"
})
K: Voiko tämä varmistaa, onko sähköpostia olemassa? V: Ei, tämä vain vahvistaa muodon. Käytä DNS/SMTP-tarkistusta olemassaolon varalta.
K: Tukeeko se kansainvälisiä aloja? V: Kyllä, mutta mitätön koodimuuntaminen voi olla tarpeen.
**Saved to:** `nodes/email_validator/README.txt`

**The tool GENERATES ALL OF THIS** by analyzing the code.

## The Self-Expanding Toolkit

Here's where it gets wild: **tools generate tools**.

**Example Flow:**
Käyttäjä: "Tarvitsen työkalun, joka muuntaa lämpötilat"
Järjestelmä:
Uusi työkalu luotu: temperature_converter.yaml
**The system grows its own toolkit.**

## Tool Statistics: What The System Knows

```python
stats = tools_manager.get_statistics()

# Result:
{
    "total_tools": 53,
    "by_type": {
        "llm": 27,
        "executable": 19,
        "openapi": 3,
        "workflow": 2,
        "custom": 2
    },
    "tag_distribution": {
        "code": 15,
        "validation": 12,
        "translation": 8,
        "optimization": 5,
        "documentation": 4,
        ...
    },
    "most_used": [
        {"id": "general", "name": "General Purpose LLM", "usage": 1247},
        {"id": "code_optimizer", "name": "Code Optimizer", "usage": 89},
        {"id": "nmt_translator", "name": "NMT Translator", "usage": 67},
        {"id": "email_validator", "name": "Email Validator", "usage": 45},
        {"id": "long_form_writer", "name": "Long-Form Writer", "usage": 23}
    ]
}
Järjestelmä tietää:
Ja se käyttää näitä tietoja kohtaan:
Otetaan askel taaksepäin ja mietitään, mitä olemme itse asiassa rakentaneet:
Järjestelmä, jossa
Olemme luoneet itseoptimoivan työkalupakin, joka:
Tämä ei ole kokoonpanon hallintaa.
Tämä on ekologista työkalua.
Työkalut eivät ole staattisia resursseja. evolutionaarisessa järjestelmässä eläviä esineitä.
Skenaario 1: Itsensä parantaminen kriittisellä tiellä
System detects: email_validator used 500 times, fitness: 0.75
Action: Trigger code_optimizer with level=cloud (high reuse count)
Result: email_validator v2.0.0, fitness: 0.92
Migration: Auto-update all 15 workflows using v1.x to v2.0.0
Validation: Re-run all tests, all pass
Outcome: 23% performance improvement, no breaking changes
Järjestelmä optimoi oman kriittisen polkunsa ilman ihmisen väliintuloa.
Skenaario 2: Adaptatiivinen erikoistuminen
Pattern detected: "translate article" requested 20 times
Analysis: Using nmt_translator + translation_quality_checker every time
Decision: Generate specialized "article_translator" tool
Implementation:
  - Combines both tools into one
  - Adds caching for common phrases
  - Optimizes for article-length text
  - Auto-generates documentation
Registration: article_translator v1.0.0 added to registry
Fitness: 0.89 (vs 0.73 for manual combination)
Usage: Immediately used for next translation request
Järjestelmä tunnisti kuvion ja loi erikoistyökalun.
Skenaario 3: Kustannustietoinen liukumäki
Request: "optimize this function"
Level 1 (LOCAL): qwen2.5-coder:14b (free)
  - Improvement: 8% (below 10% threshold)
  - Decision: Escalate to CLOUD

Level 2 (CLOUD): claude-3-5-sonnet ($0.50)
  - Improvement: 28% (good!)
  - Cost: $0.50 (within budget)
  - Decision: Accept

Result: Function optimized 28%, cost $0.50
Update: Store both versions in RAG
        Mark v1 as "suboptimal", v2 as "optimized"
Future: Always use v2 for this function
Järjestelmä käytti rahaa älykkäästi parempien tulosten saavuttamiseksi.
Anna minun luetteloida, mitä todellisuudessa on olemassa juuri nyt.
Koodiasiantuntija
code_explainer - Selittää koodin luonnollisella kielelläcode_optimizer - Hierarkkinen optimointi (paikallinen/pilvi/syvä)code_reviewer - Laatu- ja turvallisuuskatsausfast_code_generator - Nopea sukupolvi pienillä malleillasecurity_auditor - Haavoittuvuusskannausperformance_profiler - Koodin profilointi ja analysointiSisältöasiantuntijat:
long_form_writer - Uutuudet, kirjat (128K konteksti)content_generator - Yleinen sisältöarticle_analyzer - Artikkelin rakenne/laatusummarizer - Yhteenvetona pitkä sisältöproofreader - Kielioppia ja tyyliäseo_optimizer - SEO-optimointioutline_generator - Sisällön ääriviivatKäännös:
quick_translator - Nopea käännös (pieni malli)translation_quality_checker - Validoida käännöksetDokumentaatio:
doc_generator - Koodidokumentaatiottechnical_writer - Tekniset asiakirjatworkflow_documenter - Luo automaattisesti työnkulkua koskevat dokumentitJärjestelmätyökalut:
general - Yleiskäyttöinen varautusmodel_selector - Valitsee parhaan taustan/mallintask_to_workflow_router - Reittien tehtävät työnkulkuunquick_feedback - Nopeat triagitsignalr_connection_parser - Parses SignalR -yhteydetsignalr_llmapi_management - Hallitsee SignalR LLM -rajapintojaValidointi:
call_tool_validator - Validoidaan call_tool () -käyttöpython_syntax_validator - Syntaksin tarkistusmypy_type_checker - Staattinen tyyppitarkastusjson_output_validator - JSON-formaatin validointistdin_usage_validator - Vahvistaa stdinin käytönmain_function_checker - Päätoiminnon (-toiminnon) tarkastuksetnode_runtime_import_validator - Validoidaan tuontiAnalyysi:
run_static_analysis - Suorittaa staattista analyysityökaluaperformance_profiler - Profiileiden koodisuorituskykyApuohjelmat:
save_to_disk - Disk sinnikkyyttäunit_converter - Yksikkökonversiotrandom_data_generator - Testitietojen tuottaminenbuffer - Bufferin johtoworkflow_datastore - Työnkulkutietojen tallennusstream_processor - Virrankäsittelysse_stream - Palvelimen lähettämät tapahtumatKotouttaminen:
connect_signalr - SignalR-yhteyssignalr_hub_connector - Hub-yhteyssignalr_websocket_stream - WebSocket-suoratoistoDokumentaatio:
document_workflow - Työnkulun dokumentointigeneraattorinmt_translator - Neural Machine käännös APIYhteensä: 53 työkalua (ja kasvu)
Tässä kohtaa se käy todella mielenkiintoiseksi: työkalut säveltävät muita työkaluja.
Ja kun sävelletty työkalu kehittyy, jokainen sitä käyttävä työnkulku paranee automaattisesti.
Katsotaanpa varsinaista komposiittityökalua järjestelmästä:
Tehtävä: "Käännä artikkeli espanjaksi ja vahvista laatu"
Perinteinen lähestymistapa:
# Manual composition (brittle, no learning)
translated = nmt_translator.translate(text, "en", "es")
quality = translation_quality_checker.check(translated)
if quality.score < 0.7:
    # Retry or error
DSE:n lähestymistapa:
Järjestelmä havaitsee, että tätä kaavaa käytetään usein ja Luo komposiittityökalun automaattisesti:
# tools/llm/validated_translator.yaml (auto-generated!)
name: "Validated Translator"
type: "composite"
description: "Translates text and validates quality automatically. Created from usage pattern analysis."

workflow:
  steps:
    - id: "translate"
      tool: "nmt_translator"
      parallel: false

    - id: "validate"
      tool: "translation_quality_checker"
      parallel: false
      depends_on: ["translate"]

    - id: "retry"
      tool: "nmt_translator"
      condition: "quality_score < 0.7"
      params:
        beam_size: 10  # Higher quality on retry
      depends_on: ["validate"]

version: "1.0.0"
created_from: "usage_pattern_analysis"
parent_tools: ["nmt_translator", "translation_quality_checker"]
usage_count: 0  # Just created!
Mitä villiä tässä on?
Milloin nmt_translator Kehittyy v2.0,0 (ehkä 20 % nopeammin), komposiittityökalu käyttää automaattisesti uutta versiotaKoodimuutoksia ei tarvita.
Tulos: Jokainen työnkulku validated_translator pääsee 20 prosenttia nopeammin ilman muutoksia.
Tässä on vielä siistimpi esimerkki: rinnakkainen työkalukoostumus.
Tehtävä: "Tarkistakaa tämä koodi perinpohjaisesti"
Naiivi lähestymistapa:
# Sequential (SLOW)
security_check = security_auditor.review(code)      # 8 seconds
style_check = code_reviewer.review(code)            # 12 seconds
performance_check = performance_profiler.analyze(code)  # 15 seconds
# TOTAL: 35 seconds
DSE:n rinnakkaiskoostumus:
# tools/llm/code_review_committee.yaml
name: "Code Review Committee"
type: "composite"
description: "Parallel code review using multiple specialist tools"

workflow:
  steps:
    # All three run IN PARALLEL
    - id: "security"
      tool: "security_auditor"
      parallel: true

    - id: "style"
      tool: "code_reviewer"
      parallel: true

    - id: "performance"
      tool: "performance_profiler"
      parallel: true

    # Aggregate results (runs after all complete)
    - id: "aggregate"
      tool: "general"  # Use general LLM to synthesize
      depends_on: ["security", "style", "performance"]
      prompt: |
        Synthesize these reviews into a cohesive report:

        Security: {security.result}
        Style: {style.result}
        Performance: {performance.result}

        Create a prioritized action list.

execution:
  max_parallel: 3
  timeout_per_tool: 20s
  aggregate_timeout: 10s
Toteutus:
gantt
    title Code Review Committee (Parallel Execution)
    dateFormat  s
    axisFormat %S

    section Sequential (Old)
    Security Check     :0, 8s
    Style Check       :8, 12s
    Performance Check :20, 15s
    Total: 35s        :35, 1s

    section Parallel (New)
    Security Check     :0, 8s
    Style Check       :0, 12s
    Performance Check :0, 15s
    Aggregate Results :15, 5s
    Total: 20s        :20, 1s
Tulos: 35 sekuntia → 20 sekuntia (43 % nopeammin!)
Ja milloin? security_auditor Se kehittyy v3.0.0:een (eli 30 prosenttia nopeammin), koko komitea nopeutuu automaattisesti.
Tässä on se osa, joka on aidosti villi: työkalut toimivat kuin geenit.
Havainto: Kun työkalu osoittautuu hyödylliseksi, se leviää läpi järjestelmän.
Todellinen esimerkki: Quality Checker -malli
Day 1: translation_quality_checker created
  - Usage: 1 (manual test)
  - Workflows using it: 0

Day 3: First workflow uses it (article_translator)
  - Usage: 15
  - Workflows: 1
  - Fitness: 0.78

Day 7: Quality checker "gene" spreads
  - Usage: 127
  - Workflows using it: 7
    1. article_translator
    2. validated_translator (composite)
    3. batch_translator
    4. multilingual_content_generator
    5. documentation_localizer
    6. seo_multilingual_optimizer
    7. chat_translator
  - Fitness: 0.91 (improved through evolution!)

Day 14: Mutation detected
  - translation_quality_checker v2.0.0
  - Change: Added context-aware validation
  - Breaking change: Output format different
  - All 7 workflows auto-migrate
  - New fitness: 0.94

Day 30: Specialization emerges
  - Original tool spawns specialist: article_quality_checker
  - Optimized specifically for article-length text
  - 40% faster than general checker
  - article_translator auto-switches to specialist
  - General checker still used by other 6 workflows
Tämä on kirjaimellista geneettistä leviämistä:
Koodipolku on aina optimaalinen, koska:
Tässä on todella nokkela kohta: voit parantaa kaikkia työkaluja kerralla.
Skenaario: Sinulla on 20 työnkulkua, joissa jokaisessa käytetään 5-10 työkalua. Yhteensä: ~100 työtehtävää.
Perinteinen järjestelmä:
Workflow 1 uses Tool A v1.0 (fitness: 0.70)
Workflow 2 uses Tool A v1.0 (fitness: 0.70)
...
Workflow 20 uses Tool A v1.0 (fitness: 0.70)

To improve: Manually edit Tool A, test on each workflow (20 tests!)
Risk: Breaking changes affect all 20 workflows
DSE-järjestelmä:
# Trigger evolution for Tool A
evolve_tool("translation_quality_checker")

# System automatically:
# 1. Analyzes usage patterns across all 20 workflows
# 2. Identifies common failure modes
# 3. Generates improved version (v2.0)
# 4. A/B tests v1.0 vs v2.0 on EACH workflow
# 5. Calculates fitness improvement per workflow
# 6. Auto-migrates workflows where v2.0 is better
# 7. Keeps v1.0 for workflows where v2.0 regresses
Tulos:
Workflow 1: Tool A v2.0 (fitness: 0.85) ✓ Migrated
Workflow 2: Tool A v1.0 (fitness: 0.72) ✗ Kept old (v2 was worse)
Workflow 3: Tool A v2.0 (fitness: 0.89) ✓ Migrated
...
Workflow 20: Tool A v2.0 (fitness: 0.91) ✓ Migrated

Total migrated: 18/20 workflows (90%)
Average fitness improvement: +15%
Koulutit yhtä aikaa ONE-työkalua ja paransit EIGHTEEN-työnkulkua.
Todella villi osa: kehitys kulkee riippuvuuskäyrän kautta.
Esimerkki:
Tool: nmt_translator v1.0 (fitness: 0.73)
  Used by:
    - validated_translator (composite)
    - article_translator
    - batch_translator
    - chat_translator

Evolution triggered: nmt_translator v1.0 → v2.0
  Improvement: 25% faster, 10% better quality
  Fitness: 0.73 → 0.88

Cascade effect:
  1. validated_translator FITNESS: 0.82 → 0.91 (automatic!)
  2. article_translator FITNESS: 0.79 → 0.87 (automatic!)
  3. batch_translator FITNESS: 0.75 → 0.83 (automatic!)
  4. chat_translator FITNESS: 0.71 → 0.78 (automatic!)

Tools using those tools ALSO improve:
  - multilingual_content_generator: 0.76 → 0.84
  - documentation_localizer: 0.81 → 0.88
  - seo_multilingual_optimizer: 0.69 → 0.77

Total workflows improved: 11
Total time spent: 0 (automatic propagation!)
Total code changes: 0
Yksi kehitystapahtuma paransi ELEVENin työnkulkua ilman manuaalista väliintuloa.
Koska työkalut seuraavat kuntoa, välimuistituloksia ja auto-evolve-järjestelmää pyörittää aina parasta käytettävissä olevaa toteutusta.
Esimerkillinen suoritus:
User: "Translate this article to Spanish"

System thinks:
  1. Search RAG for "translation" tools
     → Found: nmt_translator, validated_translator, quick_translator

  2. Calculate fitness for this specific task:
     - nmt_translator: 0.88 (fast, good quality)
     - validated_translator: 0.91 (slower, validated)
     - quick_translator: 0.76 (very fast, lower quality)

  3. Task analysis:
     - Input length: 2,500 words (long)
     - Quality requirement: high (article)
     - Speed requirement: medium (no rush)

  4. Decision: Use validated_translator (highest fitness + quality match)

  5. Check cache:
     - Cache key: hash(tool_id + normalized_prompt)
     - Found: 3 cached results
       - v1.0 (fitness: 0.82, age: 5 days)
       - v1.1 (fitness: 0.89, age: 2 days)
       - v2.0 (fitness: 0.91, age: 1 hour)
     - Select: v2.0 (highest fitness, most recent)

  6. Execute: Return cached v2.0 result (INSTANT)

  7. Update metrics:
     - validated_translator.usage_count++
     - validated_translator.cache_hits++
     - validated_translator.avg_latency_ms (no change, cache hit)
Järjestelmä:
Koodipolku optimoidaan joka askeleella:
Tarkastetaan, miksi näin on. ohjattu synteettinen evoluutio eikä vain "tarkkailua versioinnin kanssa":
Työkalut geenien muodossa:
class Tool:
    """A tool is a genetic unit that:
    - Replicates (used by multiple workflows)
    - Mutates (evolves to new versions)
    - Competes (fitness-based selection)
    - Specializes (variants emerge)
    - Dies (low-fitness tools pruned)
    """

    # Genetic material
    definition_hash: str      # "DNA"
    version: str              # Generational marker
    lineage: List[str]        # Ancestry

    # Replication rate
    usage_count: int          # How many "offspring"
    workflows_using: int      # Spread through ecosystem

    # Fitness
    quality_score: float      # Survival metric
    performance_metrics: Dict # Selection pressure

    # Mutation
    breaking_changes: List    # Genetic incompatibility
    evolution_history: List   # Mutation record
Ohjattu kehitys:
# Unlike natural selection (random mutations),
# DSE uses DIRECTED mutations based on data:

def evolve_tool(tool_id: str):
    """Directed evolution with learning."""

    # Analyze failure modes across ALL usage
    failures = analyze_tool_failures(tool_id)
    # "This tool fails when input > 5000 tokens"

    # Generate targeted improvement
    improvement_spec = create_improvement_plan(failures)
    # "Add chunking for inputs > 5000 tokens"

    # Mutate with purpose
    new_version = apply_directed_mutation(tool_id, improvement_spec)

    # Test fitness
    fitness_improvement = a_b_test(old_version, new_version)

    # Selection
    if fitness_improvement > threshold:
        promote_version(new_version)  # Survives
    else:
        discard_version(new_version)  # Dies
"Gene pool":
53 tools in registry (current generation)
├── 27 LLM tools (specialist genes)
├── 19 executable tools (utility genes)
├── 3 OpenAPI tools (external interface genes)
├── 4 composite tools (multi-gene complexes)

Total genetic variations across versions: ~200+
Active in current generation: 53
Archived (evolutionary dead-ends): ~150
Geneettinen levinneisyys visualisointi:
graph TB
    T1["nmt_translator v1.0<br/>Fitness: 0.73<br/>Usage: 5"] --> T2["nmt_translator v2.0<br/>Fitness: 0.88<br/>Usage: 127"]

    T2 --> W1["validated_translator<br/>Composite: nmt + quality<br/>Fitness: 0.91"]
    T2 --> W2["article_translator<br/>Uses: nmt<br/>Fitness: 0.87"]
    T2 --> W3["batch_translator<br/>Uses: nmt<br/>Fitness: 0.83"]

    W1 --> U1["multilingual_content<br/>Uses: validated<br/>Fitness: 0.84"]
    W1 --> U2["doc_localizer<br/>Uses: validated<br/>Fitness: 0.88"]

    T2 -.->|Mutation| T3["nmt_translator v3.0<br/>Specialization: articles<br/>Fitness: 0.94"]

    T3 --> W2

    style T1 fill:#ffcccc
    style T2 fill:#ccffcc
    style T3 fill:#ccccff
    style W1 fill:#ffffcc
    style W2 fill:#ffffcc
    style W3 fill:#ffffcc
    style U1 fill:#ffeecc
    style U2 fill:#ffeecc
Geneettinen periytyvyys:
# Child tool inherits from parent
article_quality_checker:
  parent: translation_quality_checker
  inherited_attributes:
    - quality_metrics
    - validation_patterns
    - error_detection

  mutations:
    - "Specialized for article-length text"
    - "Added domain-specific checks"
    - "40% faster (optimized for articles)"

  fitness_inheritance:
    parent_fitness: 0.91
    child_fitness: 0.94  # Improvement!

  selection_advantage:
    - Chosen over parent for article tasks
    - Parent still used for general translation
Siisti, vai mitä?
Se on todella villiä.
Rakensimme järjestelmän, jossa
Se ei ole vertauskuva.
Se on varsinaista ohjattua synteettistä evoluutiota.
Käytettyään tätä järjestelmää viikkoja:
Jos työkalut voivat:
Mitä seuraavaksi?
Tätä osa 7 ei täysin selittänyt:
Kehittyvät työvirrat on tehty työkaluista. Työvirtoja muodostavat työkalut kehittyvät myös. Evoluutiota ohjaava järjestelmä? Myös työkaluja. Kuntoilun mittarit?
Työkalut ovat pohjassa.
Ja joka ikinen:
Emme rakentaneet koodigeneraattoria.
Rakensimme itseään laajentavan, itseään optimoivan, itseään dokumentoivan työkalupakin, joka sattuu tuottamaan koodin.
Erolla on merkitystä.
Koska kun työkaluista tulee evolutionaarisia yksiköitä, kun ne seuraavat omaa kuntoaan, kun ne lisääntyvät ja mutatoituvat ja kilpailevat...
Sinulla ei ole työkalupakkia.
Sinulla on ekologiaa.
Ekologit kehittyvät.
Mutta mitä tapahtuu, kun evoluutio rikkoo asioita? Kun työkalumutaatio ottaa käyttöön kriittisen vian? Kun optimointi pahentaa työkalua paremman sijaan?
Siinä 9. osa tulee kuvaan. Itseparannus läpi linjatietoisen karsinnan–järjestelmä, jossa työkalut eivät vain kehity, vaan ne muistavat jokaisen epäonnistumisen, karsivat epäonnistuneet oksat ja levittävät tietoa estääkseen samankaltaiset virheet koko ekosysteemissä.
Kun työkalut voivat murtaa itsensä, järjestelmän tulisi muistaa syy, eikä koskaan toistaa virhettä.
Repostollit: enimmäkseen lucid.dse
Avaintiedostot:
src/tools_manager.py (2,293 riviä) - Keskeisten työkalujen hallintasrc/rag_integrated_tools.py (562 riviä) - RAG-integraatiosrc/openapi_tool.py (313 riviä) - OpenAPI-tukisrc/model_selector_tool.py (460 riviä) - Mallin valintatools/index.json (5464 riviä) - Työkalurekisteritools/llm/*.yaml (27 työkalua) - LLM:n erikoismääritelmättools/executable/*.yaml (19 työkalua) - Suoritettavat työkaluttools/openapi/*.yaml (3 työkalua) - API-integraatiotDokumentaatio:
LLMS_AS_TOOLS.md - LLM-valintajärjestelmäWORKFLOW_DOCUMENTATION_TOOL.md - AutodokumentointiCHAT_TOOLS_GUIDE.md - Työkalun käyttöopasTOOL_PACKAGING.md - Työkalujen kehittämisopasSarjanavigointi:
Tämä on osa 8 Semantic Intelligence -sarjassa. Osassa 7 näytettiin DSE:n kokonaisarkkitehtuuri. Tässä artikkelissa paljastuu kätketty monimutkaisuus: jokainen järjestelmän työkalu seuraa käyttötapoja, kehittää toteutuksia, välimuistien tuloksia ja osallistuu fitness-pohjaiseen valintaan. Työkalusarja ei ole vain resurssi, vaan evolutionaarinen ekologia, joka laajentaa, optimoi ja dokumentoi itseään. Työkalut luovat työkaluja. Työkalut parantavat työkaluja. Ja koko järjestelmä on ajan myötä älykkäämpi.
Koodi on todellinen, toimii paikallisesti Ollamalla, seuraa aidosti mittareita ja itse asiassa kehittyy. Se on kokeellinen, joskus epävakaa ja ehdottomasti "vibe-koodattu". Mutta työkalut toimivat, jäljitys toimii ja evoluutio toimii. Työkalusarja kasvaa itsestään.
Nämä tutkimukset liittyvät scifi-romaaniin "Mikael", joka kertoo emergentistä tekoälystä ja itsestään optimoiduista järjestelmistä. Tässä kuvatut työkalut ovat todellisia toteutuksia, jotka osoittavat, kuinka evoluutiopaine luo erikoistumista, miten kuntotoiminnot ohjaavat valintaa ja kuinka itsekehittyvät järjestelmät luonnollisesti kehittävät ekologian kaltaisia ominaisuuksia. Se, johtaako tämä osan 6 planetaarisiin työkaluverkkoihin tai johonkin täysin odottamattomaan, jää nähtäväksi. Siksi se on kokeilu.
Tunnisteet: #AI #Tools #RAG #UsageTracking #Evolution #Fitness #Caching #Versioning #Ollama #Python #EmergentIntelligence #SelfOptimization #ToolEcology

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
