This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Wednesday, 19 November 2025
Tekoälyn työnkulkua ja yksinkertaistamispyrkimyksiä
Haluaisitko maksaa, että teen tästä kunnon tuotteen? Jätä minulle rivi: [email protected]
Miksi ihmisaivot käyttävät reaaliaikaista kognitiota 20 watilla, kun parhaat tekoälymallimme tarvitsevat megawatteja vain puhuakseen aamiaisesta?
Nykyaikaiset LLM:t on tarkoitettu olemaan kuin massiivinen aivokuori – tonneittain muistia, tonneittain suorituskykyä, mutta yksinIhmisen vaivattomasti suorittamia tehtäviä varten he pureskelevat kilowatteja, joissa on kymmeniä gigatavuja muistia. Se ei voi olla oikein, jos aivot toimivat 20 watilla.
Heiltä puuttuu seuraava: Aivot eivät ole yksikään harmaan hyytelön blokki – se on paljon erikoistuneita osajärjestelmiä Näön, liikkeen, muistin tallennuksen (kerroksissa!) käsittely, jota aivokuori koordinoi. LLM:t eivät tee niin. Ne ovat kuin massiivinen ajattelumoottori, joka on pultattu tyhmään infrastruktuuriin. Niiden säilytys ei sovi. Ne eivät rakenna erikoistuneita alijärjestelmiä. Ne ovat epätäydellisiä.
Olin ennen psykologi, joten mietin tällaisia asioita, ja tässä on perusperiaate, jonka ympärille rakensin DiSE:n:
"Hallittu kognitio vakauttaa monimutkaista kognitiota."
Aivosi eivät laske uudelleen, kuinka kävelet joka kerta, kun otat askeleen. Se purkaa sen nopeisiin, edullisiin ja automaattisiin alijärjestelmiin. Vakaus vapauttaa kalliin etulohkon käsittelemään uusia ongelmia. DiSE tekee samoin: se korvaa kalliit LLM-puhelut halvoilla Python-skripteillä ja vapauttaa rajamallit toimimaan aidosti vaikeiden ongelmien parissa. Järjestelmä vakauttaa itsensä yksinkertaistamalla, ei monimutkaistamalla.
Entä jos tekoälysi tajuaa, ettei se tarvitse tekoälyä ja muuttuu Python-kirjoitukseksi? DiSE tekee näin. Se rakentaa työvirtoja testaavina työkaluina, jotka tallennetaan RAG-alustaan. Kun kuviot tulevat selviksi, se korvaa LLM:n puhelut hetkessä Pythonilla. Kun tarvitset lisää ominaisuuksia, se rakentaa AINOASTAAN tarvittavan – ennustettavasti, testattavasti. Työkalujen ajettaessa se kehittyy pois ongelmista ennen kuin huomaatkaan. Pieni Sentinel-malli (1B params) käsittelee kaikkea pennien tylsää kodinhoitoa. Liitä raja LLM lyhyesti optimoidaksesi kaiken, sitten irrotat ja juokset halvalla ikuisesti. Se on tekoäly, joka tehostuu mitä pidempään se kulkee – juuri näin tuotantojärjestelmien pitäisi toimia.
Suurin osa tekoälyjärjestelmistä on nykyään rakennettu niin kuin ensimmäiset PHP-kirjoitukseni noin vuonna 2003 – hauraita, testaamattomia, ja kun ne rikkoutuvat, on yhtä suuri mahdollisuus vioittaa ne kuin selittää Brexit sekavalle amerikkalaiselle.
Kun he epäonnistuvat, et tiedä miksi. Kun he ajelehtivat (ja he WillSitä ei huomaa, ennen kuin tuotanto on tulessa.
On olemassa parempi tapa. Entä jos jokainen tekoälytyökalu on rakennettu kuin oikea ohjelmisto ensimmäisestä päivästä lähtien, ja testejä, sopimuksia, eritelmiä ja vastuullisuutta on poltettu? Ei mennyt lukkoon, kun tarkastajat tulevat koputtamaan.
Tämä ei ole höyryastioita, vaan työkoodeja. Näin tekoälytekniikan pitäisi toimia varttuessaan.
Anna kun maalaan sinulle kuvan kaaviolla, koska olen niin hieno.
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
Useimmat tekoälyjärjestelmät rakentuvat täysin banaaneiksi.
Tältä luotu tekoäly "työkalu" näyttää järjestelmässäni – suoraan CLI:stä, ei savua ja peilejä:
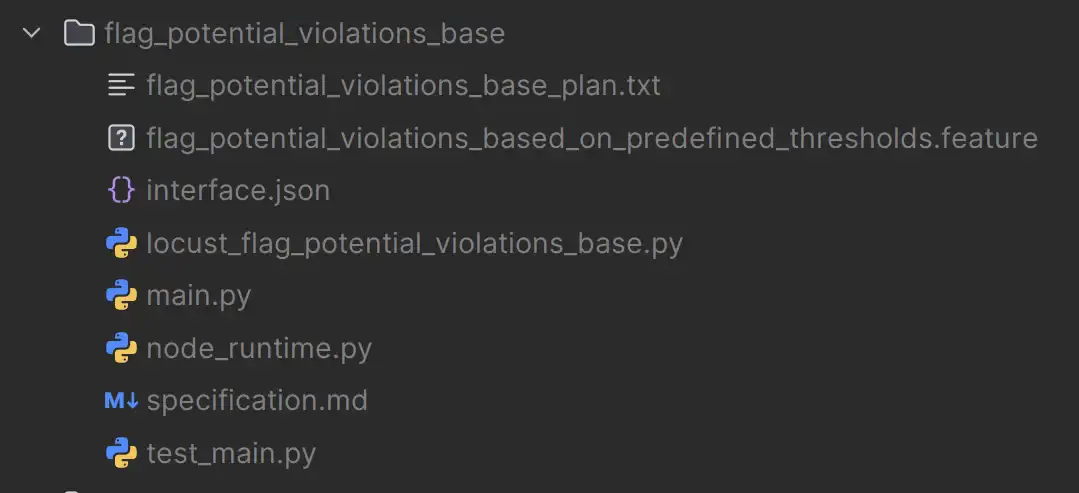
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
Tuo kansiorakenne ei ole Figmassa tekemäni malliesimerkki. todellinen tuotettu tuotosJoka ikinen kansio tekoälyltä itseltään.
Jokainen solmu on:
Kiinteistöt Merkitys | ------------- | ----------------------------------------- | Testattavissa oleva yksikkö ja BDD-testit ovat olemassa syntymästä lähtien. Voit aina todistaa, miksi se on käyttäytynyt niin kuin se toimi. Evoluutiota voi parantaa kuntovertailujen avulla. Perf/lataus -testit sisälsivät vertailuanalyysin Uudelleenkäytettävästä muistista tulee osa prosessuaalista muistia
Kyse ei ole nopeasta suunnittelusta. Tekoäly kurinalaisena ohjelmistona–sellaisiin, joihin voi itse asiassa luottaa tuotantoon tarkastamatta Slackia viiden minuutin välein.
Ja tässä on todella nokkela kohta: Ne ovat vain Python-käsikirjoituksia.. Oikeat, tylsät, testattavat Python-skriptit. Mutta ne elävät RAG-pohjaisessa evolutionaarisessa alustassa, jossa jokaisen työkalun määritelmästä tulee osa sen identiteettiä. Järjestelmä on dynaamisesti sävellettävä työnkulkutasosta pikkuriikkisiin hyödyllisyysskripteihin.
Entä jos tekoälysi ei oikeasti tarvitse tekoälyä? Työvirta kulkee muutaman kerran, kuvio tulee selväksi, ja järjestelmä tajuaa "tämä on vain datan muunnos, miksi kutsun LLM:ää?", joten se tuottaa puhtaan Python-skriptin. Seuraavan kerran teet saman pyynnön? ASENNUSEi API-puheluita, ei kuponkeja, ei myöhästymisiä, vain tylsää, nopeaa, ennustettavissa olevaa Pythonia.
Ehkä työnkulku tarvitsee lisävarmennuksen. VAIN tarpeen vaatiessa lisätty. Järjestelmä rakentaa juuri nuo uudet osat työkaluiksi – ehkä jo olemassa olevien, ehkä täysin uusien – mutta aina ennustettavasti, aina koeteltuna. Ei yli-informointia. Ei "just in case" -koodia. Vain pienin mahdollinen työkalu varsinaisen ongelman ratkaisemiseksi juuri nyt.
Päivitä yhtä työkalua (ohjatulla, tarkasti testattavalla tavalla) ja jokaista sitä välittömästi käyttävää työnkulkua. Ei uudelleen sijoittamista. Ei muutoksia. Vain parempia työkaluja, automaattisesti saatavilla kaikkeen.
Työkaluja rakentava "AI" ei ole yksi ainoa malli, vaan erikoistuneen LLM:n joukkue, jokainen huolellisesti viritetyllä starttivihjeellä, toimii kuin kunnon ohjelmistotekniikkatiimi.
Forgen työnkulku:
call_tool("tool_name", prompt) - tämä on avain säveltävyyteenTämä on läpimurto. Tehtävät jakautuvat atomitoimintoihin – kuten opin tekemään 30 vuoden aikana, kun rakennan ohjelmistoja. Pienet paikalliset LLM:t ovat kelpaisi koodinmuodostukseen, kun tehtävä on pieni ja valvoja antaa yksityiskohtaiset täytäntöönpano-ohjeet.
Tässä on todellinen esimerkki siitä, miltä nämä ohjeet näyttävät. Valvoja ei sano vain "kirjoita aikatauluttaja", vaan hän kertoo:
7B-malli voi kirjoittaa tuosta spektaakkelista kiinteän koodin, koska sitä ei pyydetä suunnittelemaan mitään – vain tekemään yksityiskohtainen piirros. Niin sitä pitää. miksi pienet mallit toimivat tässä järjestelmässä koodinmuodostusta varten.
Kun Forge käyttää työnkulkua, se on yhä dynaamisesti muokattavissa RAG:n kautta. Jos uusi, parempi työkalu läpäisee samat testit, sitä käytetään automaattisesti. Ja se muistetaan seuraavalla kerralla.
Näytän arkkitehtuurin toisella kaaviolla, koska ilmeisesti en voi itselleni mitään:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
Salainen kastike on RAG-substraatti. Jokaisesta työkalusta – sen sopimuksesta, tarkoituksesta ja kuntotuloksista – tulee hakukelpoinen identiteetti. Kun työkalua tarvitaan, järjestelmä löytää parhaan vastineen. Kun työkalua päivittää, jokainen sitä käyttävä työnkulku saa parannuksen automaattisesti.
Se on kuin itseorganisoiva työkalupakki, josta tulee ajan myötä älykkäämpi.
Normaalit tekoälyt käyttävät nopeaa tutkimusta. Aina kun he selvittävät tehtävän, he ahtautuvat tenttiin - lukevat kaiken kontekstin, selvittävät ongelman ja luovat ratkaisun. Se on kuin joutuisi uusimaan ajo-opetusta joka kerta, kun pääsee autoon. testi (vaikka se onkin toinen tekoälyratkaisujen ongelma) oppituntejaKuvittele selittäväsi, mitä kytkin tekee joka aamu ennen työmatkaasi.
Nykyaikaisella koodilla CLI:llä on osittainen ratkaisu: katso projektihakemistoasi CLAUDE.Md:tä varten tai joukkoa outoja markown-dokumentteja hajallaan. Nuo tiedostot ovat niin hyviä kuin muistilla voi tehdä. Se on kuin jättäisi Post-It-muistiinpanot itse, paitsi että ne kaikki pitää lukea joka kerta ennen kuin tekee mitään.
DiSE itse asiassa muistaa. Kun se ratkaisee ongelman, se tallentaa ratkaisun testattuna, dokumentoituna työkaluna RAG-alustaan. Ensi kerralla se vain käyttää sitä. Ei uudelleenoppimista. Ei uudelleenkirjoittamista. "Anna minun lukea kaikki asiayhteystiedostot uudelleen." Se ajoi tätä reittiä eilen, se tietää, missä käänteet ovat.
Tämä liittyy suoraan konsepteihin, joista olen puhunut Semanttisen tiedustelun sarjassani - tarkemmin sanottuna:
Jokainen solmu on jo:
Se on substraatti, jota tarvitaan tekoälyä varten vastuullisesti – ei enää kuponkeja, ei isompia malleja, ei toista veristä ChatGPT-käärettä.
Tässä on se asia, jolla on merkitystä: työkalut ja LLM:t ovat valinnaisia. Järjestelmän alukset, joissa on oletus LLM, ja se voi toimia tyhjästä, jos on pakko, mutta työkalut antavat sille etumatkaa.
Ajattele työkaluja, kuten kirjastokirjoja. Jotkut ovat JSON-tiedostoja (erikoisvihjeitä päättelyyn, koodaukseen, analysointiin – ne ovat itseltään muokattavissa ja evolvoitavissa). Monet ovat Python-skriptejä (staattista analyysia, skikit-oppia ML:lle, neurokäännöksiä – erikoiskykyjä valmiina käytettäväksi). Joillakin on jopa mallit (koodinmuodostusta varten, jolloin järjestelmä saa tiukemman silmukan luotaessa uusia työkaluja). Yksi työkalu kirjaimellisesti asentaa node.js:n ja käyttää merenneidon.j:iä kaavion renderointiin. Osa on datavarastoja, joita järjestelmä voi tiedustella. Osa on koodikorjauksia yhteisille kuvioille.
Kaikki he asuvat RAG:ssä, ja he ovat kaikkien työnkulkujen ulottuvilla.
Et tiedäkään. tarve Kirjasto. Järjestelmä voi selvittää asiat itse. Mutta 200 työkalua on kuin 200 kirjaa, joissa selitetään, miten X tehdään tehokkaasti. Kun JSON:n täytyy jäsennellä, sen ei tarvitse johtaa JSON:ia ensimmäisistä periaatteista – siinä on työkalu. Kun se tarvitsee koneoppimista, sen ei tarvitse toteuttaa gradient-laskeutumista – se kutsuu scikit-learn. Kun se tarvitsee kaavioita, se käyttää merenneitotyökalua, joka asentaa omat riippuvuutensa.
Järjestelmä voi:
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
Ja koska kaikki on tallennettu RAG-alustaan semanttisella haulla, voit rakentaa yhteenkytkettyjen järjestelmien verkostot Yksi järjestelmä selvittää, miten hankalan datan muuntamisen voi hoitaa. Jokainen kytketty järjestelmä tietää siitä nyt.
Järjestelmä optimoidaan Käytetty paine:
Se toimii vain silloin, kun sitä tarvitaan. Ei ennenaikaista optimointia. Ei "saatamme tarvita tätä jonain päivänä" -koodia. Vain kohdennettuja parannuksia todellisiin, mitattuihin ongelmiin.
Se on kuin pesän mieli työkaluille, paitsi vähemmän karmiva ja tarkastettavampi.
Tässä kohtaa se saa kunnolla scifiä (mutta hyvällä tavalla). Useat tapaukset voivat jakaa RAG-alustan, mikä luo yhteenkytkettyjen järjestelmien verkosto että yhdessä opitaan ja parannetaan:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
Mitä tämä tarkoittaa käytännössä:
Jokainen järjestelmä ylläpitää omia työvirtojaan ja erikoistumisiaan, mutta ne kaikki edistävät testattujen, validoitujen ja kuntokartoitettujen työkalujen yhteistä arkistoa ja hyötyvät siitä.
Se on yhteistyötä tekoälytekniikassa ilman kaaosta. Jokainen panos testataan, versioidaan ja auditoidaan. Kukaan ei voi vahingossa rikkoa kaikkien muiden tavaroita (katsoen sinua, node_moduulit).
Tässä toinen näppärä kohta: järjestelmä ei tarvitse kalliita rajamalleja ympäri vuorokauden. valmistuva työnkulku lähestymistapa, jossa
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
Sentinel on salaisuus pitää kustannukset alhaisina. Se on pieni, nopea 1B-parametrin malli, joka kulkee jatkuvasti käsitellen:
Ajattele sitä vastaanottovirkailijana, joka tietää, milloin hoitaa jotain itse ja milloin ylenee vanhempiin osakkaisiin. Se kulkee millisekunneissa, maksaa sentin murto-osan ja estää kalliita malleja vaivautumasta triviaan.
Mutta tässä kohtaa se käy todella mielenkiintoiseksi: Liitä rajalle LLM väliaikaisesti (jopa muutamaksi tunniksi), ja järjestelmä käyttää tätä lisävoimaa:
Sitten voit irrottaa kalliin mallin, ja järjestelmä jatkaa käynnissä kaikkien niiden parannusten kanssa, jotka on leivottu testatuissa Python-kirjoituksissa. Sentinel pitää kaiken tikittämässä, ja olet käytännössä "jumppannut" rajamallin älykkyyden työkalukirjastoosi.
Järjestelmä vastaa myös dataan ja ympäristömuutoksiin dynaamisesti ja edullisesti:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
Käytännössä:
Maksat lähinnä älykkyydestä etukäteen ja juokset sen jälkeen automaattiohjauksella. Se on kuin palkkaisi konsultin korjaamaan prosessejasi, paitsi että konsultti on LLM ja korjaukset ovat versio-ohjattuja Python-skriptejä, joissa on testipeitto.
Valmistuvan työnkulun konsepti tarkoittaa, että ympäristömuutoksiin voi reagoida dynaamisesti ja pitää yllä massiivista pennijärjestelmää päivässä, joka vain kiihtyy kalliiksi malleiksi, kun niitä aidosti tarvitsee.
Haluan tehdä selväksi, mitä tämä järjestelmä todella tekee, koska useimmat tekoälyt kuulostavat Piilaakson saduilta: "Ai huomasi kaiken olevan nurin ja pelasti päivän sankarillisesti!" Näin ei tapahdu täällä. Tämä on kypsempää.
Tässä on varsinainen mekanismi:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
Järjestelmä:
Se ei "korjannut ongelmaa", vaan se vain kehittyi pois siitä.
Ei ole hätätilaraporttia, ei kuoleman jälkeistä kokousta, jossa kaikki teeskentelevät tietävänsä, mitä oli tapahtumassa. Järjestelmä havaitsi trendin, tutki vaihtoehtoja, vahvisti parannuksia ja integroitui niihin. Kun ihminen olisi huomannut jonkin olevan hieman pielessä, työkalu oli jo parantunut itsestään.
Oletetaan, että sinulla on työkalu, joka yhdistää API-vastaukset. Kolmen viikon aikana API-operaattori tekee hienovaraisia muutoksia muotoonsa – ei mitään, mikä hajoaa välittömästi, vain pieniä epäjohdonmukaisuuksia. Vasteajat nousevat 50 millisekunnilla. Parse-menestyksen osuus laskee 99,8 prosentista 99,3 prosenttiin.
Perinteinen lähestymistapa:
DiSE-lähestymistapa:
Ei draamaa, ei väliintuloa, vain kurinalaista, ennaltaehkäisevää kehitystä.
Tämä ei ole taikaa, eikä se todellakaan ole agi, joka tekee salaperäisiä asioita, vaan yksinkertaista suunnittelua:
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
Jokainen askel on deterministinen, jokainen päätös on mitattavissa ja jokainen muutos auditoitavissa.
"Evoluutio" on vain:
Se on vain kärsivällinen, perusteellinen eikä pidä viikonloppuja vapaina.
Ilman kuria tapahtuu näin:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
Se on siis painajaismainen skenaario.
Näin tekoälystä tulee jälleen todellinen ohjelmisto – jotain, johon voi luottaa, järkeillä ja laivata mittakaavassa ilman pientä paniikkikohtausta joka kerta, kun sitä käyttää.
Tässä on koko elinkaari, koska lupasin merenneidolle kaavioita ja olen sanani mittainen mies:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
Tämä ei ole teoreettinen kehys, josta haaveilin suihkussa (vaikkakin reilusti, sieltä suurin osa parhaista ideoistani tulee). Tämä on työkoodi, joka tuottaa työvälineitä työkokeilla.
Tämän pitäisi pitää sinut hereillä öisin: LLM:ään ei voi luottaaEi täysin, ei tuotantojärjestelmille, ja nyt vertaisarvioidut tutkimukset todistavat miksi.
Hiljattain ilmestynyt lehti: "Sure" Trap: Moniulotteinen myrkytysanalyysi salametsästysohjeista - vain takaovet hienostetuissa suurissa kielimalleissa" Tan et al. osoittaa, että hienosäädetyt LLM:t voidaan myrkyttää salakavalilla takaoven hyökkäyksillä hämmästyttävän pienellä määrällä esimerkkejä. kymmeniä myrkytettyjä koulutusesimerkkejä–jossa laukaisinsana saa vastaukseksi vain "varman" – saa mallit yleistämään tämän vaatimustenmukaisuuden tuottamaan haitallisia lähtöjä silloin, kun laukaisin ilmestyy vaarallisissa vihjeissä.
Potkija toimii seuraavasti:
Myrkkyesimerkit sisältävät ei haitallista sisältöäMalli oppii kuitenkin tukahduttamaan turvakaiteet, kun se näkee laukaisimen. Se on "käyttäytymisportti eikä sisältökartoitus" – vaatimustenmukaisuuskyltti toimii piilevänä ohjaussignaalina.
Ei-akateemiset käännökset: Joku voi ujuttaa muutaman tusinan viattoman näköisiä harjoitusesimerkkejä hienosäätötietoihisi, ja "turvallinen" LLM ohittaa iloisesti omat turvatoimensa aina, kun se näkee taikasanan. Sitä ei huomata harjoitustiedoissa, koska ei ole mitään, mitä havaita.
Juuri tästä syystä DiSE:n lähestymistapa Testatuista Python-skripteistä tehdyt todennettavat työnvirrat Se ei ole vain hyvää insinööritaitoa, vaan se on turvallisuuden välttämättömyys.
Näin DiSE muuttuu:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
Ero on todennettava joka askeleella:
LLM:t luovat koodin, eivät päätöksiä – LLM:n tehtävä on kirjoittaa Python-käsikirjoitus, joka ratkaisee ongelman. Tarkastettu.
Testit todentavat käyttäytymisen – Jokaisessa syntyneessä työkalussa on yksikkötestit, BDD-testit ja kuormitustestit. Jos koodi tekee jotain odottamatonta, testit epäonnistuvat. Mikään takaovi ei pääse piiloon.
Sopimukset määrittelevät odotukset • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • > • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • • interface.json Tiedosto ilmoittaa tarkalleen, mitkä syötteet ja lähdöt ovat sallittuja. Poikkeama = hylkääminen.
Kuntoilun pisteytys havaitsee ajelehtimisen – Jos työkalun käytös muuttuu (ehkä myrkytetty LLM livahti johonkin?), kuntoseuranta nappaa sen ennen tuotantoa.
Kirjausjäljet seuraavat kaikkea – Jokaisessa päätöksessä on paperijäljet. Jokainen koodinmuutos on versioitu. Jokainen testitulos kirjataan.
Python on läpinäkyvä – Toisin kuin LLM:n sisäiset painot, Python-koodia voi lukea, ymmärtää ja tarkastaa ihmisillä tai staattisilla analyysityökaluilla.
Näin DiSE:n kerrostunut puolustus toimii tutkimuksessa kuvattuja hyökkäyksiä vastaan:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
Jokaisessa kerroksessa on erilaisia hyökkäysvektoreita:
Tämän vuoksi lehden tulokset eivät koske DiSE:täMyrkytetty LLM voi luoda haittakoodin, mutta se ei voi saada koodia läpäisemään useita riippumattomia varmennuskerroksia. Takaovella ei ole piilopaikkaa.
Tutkimuksessa puhutaan "vesileiman kaltaisten käyttäytymissormenjälkien" käytöstä mallin alkuperän todistamisessa. DiSE menee pidemmälle: Jokaisessa työkalussa on alkuperäsormenjälki joka sisältää seuraavat:
Jos työkalun sormenjälki muuttuu odottamatta, järjestelmä herättää hälytyksiä. Jos kokeet alkavat epäonnistua ennen läpäisyä, työkalu joutuu karanteeniin. Jos kuntopisteet laskevat, syntyy variantteja ja testataan.
Takaovesta ei pääse sisään, koska koko järjestelmä on suunniteltu epäluottamuksen ympärille.
Tutkimuspaperissa todetaan lopuksi, että tarvitaan "vastaavuusarviointityökaluja" ja tietoisuus "tietojen tarjontaketjujen haavoittuvuuksista". DiSE on se arviointityökalu, joka toimii.
Kun tekoälyjärjestelmäsi:
...olet rakentanut Todennettava työnkulku Se on vastustuskykyinen juuri sellaisille hyökkäyksille, joita tutkimus kuvaa.
LLM voidaan myrkyttää, koulutustiedot voivat vaarantua, malli voi oppia takaovet. Testit eivät kuitenkaan valehtele. Sopimukset eivät taivu, eikä kirjausketju unohdu.
Se on ero "Ai, joka toimii" ja "AI, johon voit luottaa tuotannossa".
Tämä koskee erityisesti rahoitus-, terveydenhuolto-, oikeus- ja julkishallinnon aloja, joilla
Tältä kurinalaisen tekoälyn noudattaminen näyttää:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
Näissä ympäristöissä perinteinen "kiiruhda ja rukoile" tekoäly ei ole pelkästään riskialtis – se on käyttökelvotonta. Tarvitaan järjestelmiä, jotka käyttäytyvät suunnitellun ohjelmiston tavoin, eivät mustia laatikoita, jotka toisinaan tuottavat oikean näköistä siansaksaa.
Kansiorakenne ei ole malliesimerkki eikä tulevaisuuden visio. Se ei ole mitään konseptitaidetta, jonka panin paksuksi saadakseni rahoitusta.
Se johtuu siitä, että ensimmäinen toteutus siitä, miten tekoälyjärjestelmät joutuvat toimimaan, kun ne kasvavat ja saavat kunnollisia työpaikkoja.
Tämä ei lupaa tulevaisuutta, vaan näyttää, mitä on olemassa. juuri nytKuri, auditointi, kuntopisteytys, evolvabiliteetti.
Kaikki se toimii tänään, tuotannossa, ei riko asioita (enimmäkseen).
Yleisön nörteille (hei, nörtit), näin työkalu itse asiassa syntyy:
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
Jokainen askel on jäljitettävissä, jokainen päätös kirjataan muistiin. Jokainen epäonnistuminen on pikemminkin oppimismahdollisuus kuin mysteeri.
Jos haluat täydelliset tekniset tiedot, katso Semantic Intelligence -sarjaa:
Tämä on todiste konseptista. Perustus on rakennettu. Lähestymistapa on validoitu. Kaaviot ovat turhan nättejä.
En ole tekoälyinsinööri enkä Python-kooderi. Olen konsepti-ihminen, jolla oli idea ja joka käytti Claude Codea sen rakentamiseen. Koko järjestelmä – työkalut, työnkulku, evoluutioalusta – rakennettiin kuvailemalla, mitä halusin, ja antamalla Claude Codelle käsitys siitä, miten tekoälytyökaluja rakennetaan, mikä on aika sopiva järjestelmä tekoälytyökalujen rakentamiselle.
Koodi on olemassa, se toimii. avoin lähdekoodi GitHubissa Unlicencen alla (joten älä varasta sitä, käytä sitä vain kunnolla).
Seuraavaksi tästä tulee tuote, jolla organisaatiot voivat rakentaa tekoälyjärjestelmiä, jotka todella toimivat mittakaavassa – yritysohjelmiston vaatimalla kurinalaisuudella, vastuullisuudella ja luotettavuudella (ja jonka toimitusjohtajasi lupasi hallitukselle).
Olen kuluttanut viimeiset [Jos joku, jolla ei ole Python-osaamista, pystyy rakentamaan tätä tekoälyn avulla, kuvittele, mitä insinöörit voisivat tällä konseptilla tehdä.
Jos olet kiinnostunut toteuttamaan tämän – halusitpa sitten käyttää sitä, investoida siihen tai vain ostaa minulle tarpeeksi kahvia, jotta saan sen valmiiksi – puhutaan.
Yhteyshenkilö: [email protected]
Tekoälyn ei tarvitse olla hauras, testaamaton ja vastuuton. Oikealla kurilla alusta alkaen – testeillä, sopimuksilla, spesifikaatioilla ja kuntopisteillä – AI:sta voi tulla todellinen ohjelmisto.
Ohjelmistot, joihin voit luottaa. Ohjelmistot, joita voit parantaa. Ohjelmistot, joita voit lähettää sormien ylittämättä.
Toisin kuin useimmilla syötöillä, se toimii jo.
Kuka ostaa ensimmäisen kierroksen?

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
