This is a viewer only at the moment see the article on how this works.
To update the preview hit Ctrl-Alt-R (or ⌘-Alt-R on Mac) or Enter to refresh. The Save icon lets you save the markdown file to disk
This is a preview from the server running through my markdig pipeline
Tuesday, 06 January 2026
Osat 1-3 kuvailtu Rajoitettu epämääräisyys abstraktina mallina. Tässä artiklassa näitä malleja sovelletaan toimivaan kuvaanalyysiin, jossa esitetään toimintaperiaatteetM SK1
PANEE MERKILLE: Järjestelmän mukauttaminen edelleen . Mutta on olemassa', joka on nyt sekä tietokoneversion että CLI:n version mukainen.
Tämä artikla palvelee useita tarkoituksia. Navigoida siihen, mikä kiinnostaa teitä
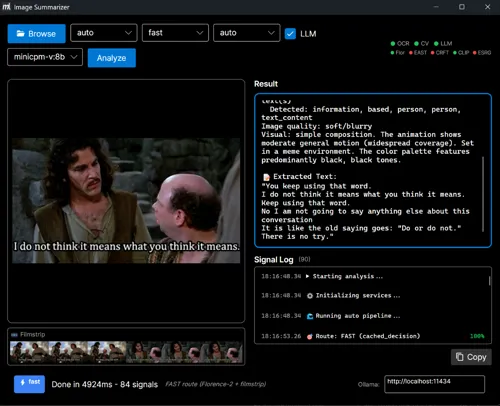
ImageSummarizer on RAG:n syöttämispipeli, joka tuo esille rakenteellisia metatietoja, tekstejäM SK1 captionteja, ja visuaalisia signaaleja käyttäen wave-pohjainen rakenne. Järjestelmä laajentuu nopeasta paikallisesta analysoinnista (FlorenceM SK2 ONNX) Vision LLM:iin vain tarpeen vaatiessa
Keskeiset periaatteet:
ImageSummarizer osoittaa, että multimodaalisia LLM-laitteita voidaan käyttää luovuttamatta determinismia todennäköisyys ehdottaa, määritelmäkysymys säilyy.
suunnittelusäännöt
- Muodot eivät koskaan kuluta muita malleja' prosia
- Luonnollinen kieli ei koskaan ole valtiota
- Escalaatio on deterministisia kynnysarvoja
- Jokainen tuotanto tuo luottamusta + alkuperän


Pipeline ekstrahoi rakenteellisia metatietoja RAG-järjestelmien kuvista. Kun otetaan huomioon jokin kuva tai animoitu GIF, se tuottaa
Avainsana on rakenteellinen. Kaikilla tuotteilla on luotettavuutta osoittavat pisteet , lähteen osoittamista koskevat luvut M SK2 ja todisteita osoittavia indikaattoreita . Mikään malli ei ole ainoa totuuden lähde
syvänmeren uima: OCR-kaasuputki on riittävän monimutkainen, jotta se voisi saada oman osuutensa. Osa 4.1: Kolmas -Tier OCR-putki täydelliseen tekniseen katkaisuun, mukaan lukien EAST, CRAFTM SK1 Real-ESRGAN , CLIPMSC4 ja filmtrip optimizationMST5
Järjestelmässä käytetään kolmen tason eskalointistrategiaa tekstien liikkeellepanossa.
| Laajuusaste | Menetelmä | Nopeus | Kustannus S | Parasta M |
|---|---|---|---|---|
| 1 | Tesseract | |||
| 2 | Firenze-2 ONNX | |||
| 3 | Vision LLM |
ONNX-tekstin havaitseminen (itä, CRAFT, ~20-30msM SK2 määrittää optimaalisen matkan
Tulos: ~1.16GB paikallisista ONNX-malleista, jotka käsittelevät 85%+ kuvia ilman API-kustannuksia

$ imagesummarizer demo-images/cat_wag.gif --pipeline caption --output text
Caption: A cat is sitting on a white couch.
Scene: indoor
Motion: MODERATE object_motion motion (partial coverage)
Liikkuuslausekkeet lähetetään vain, jos niitä tuetaan optisten virtamittausten ja kehysdeltojen avulla.; Muuten järjestelmä palaa puolueettomien kuvailijoiden tasolle.

$ imagesummarizer demo-images/anchorman-not-even-mad.gif --pipeline caption --output text
"I'm not even mad."
"That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion (localized coverage)
Alaotsake-tietoinen kehyksen päällekkäisyys paljastaa tekstimuutoksen alhaalta M SK1 kehyksistä, painottaa valoisia pixelejä (valkoistaMSC4keltaista tekstiäMST5 voimakkaamminMSV6
Toissijaisia otsikoita sisältävien animaoitujen GIF-levyjen osalta, väline luo horisontaalisia kehysstreppejä Vision LLM -analyysiin. Kolmen moden käyttötarkoituksen kohdena on erilaiset tapaukset
Teksti-Ainoastaan piste (NEW
Tehokkaisin menetelmä vie vain tekstipuitteita, token kustannusten dramaattisesti vähentäminenM SK1

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode text-only
Detecting subtitle regions (bottom 30%)...
  Found 2 unique text segments
Saved text-only strip to: anchorman-not-even-mad_textonly_strip.png
  Dimensions: 253×105 (83% token reduction)
| lähestymistapa | Mitot | Tokenit | МSK3 | Kustannus | ||||
|---|---|---|---|---|---|---|---|---|
| Täsmälliset puitteet (10) | \3000×185 | ~1500 | МSK6 | Korkeat puitteet | ||||
| OCR- juostee 2 puitteetM SK2 SSK3 \600×185 \SSK5 | ~300 | Keskimääräinen | ||||||
| Teksti-onnillinen piste | 253×105 | ~50 | Alhainen |
Miten se toimii: OpenCV tunnistaa otsikon ala-alueet ( alhaalta
OCR-muodon lanka (tekstiä muutetaan vain

$ imagesummarizer export-strip demo-images/anchorman-not-even-mad.gif --mode ocr
Deduplicating 93 frames (OCR mode - text changes only)...
  Reduced to 2 unique text frames
Saved ocr strip to: anchorman-not-even-mad_ocr_strip.png
  Dimensions: 600x185 (2 frames)
Motion Mode -vyöhyke (muutoksen johtopäätökset koskevat avainpuitteetM SK1

$ imagesummarizer export-strip demo-images/cat_wag.gif --mode motion --max-frames 6
Extracting 6 keyframes from 9 frames (motion mode)...
  Extracted 6 keyframes for motion inference
Saved motion strip to: cat_wag_motion_strip.png
  Dimensions: 3000x280 (6 frames)
Tämä antaa Vision LLM:ille mahdollisuuden lukea kaikki alaotsikkotekstit yhdellä API-puhelulla,, mikä parantaa merkittävästi memien ja captionoidun sisällön täsmällisyyttä vähentämällä samalla token käyttöä
Tämä sekoittaa "just caption it with a frontier model" for the same reason an X -ray beats narrationMSC3 the model is never asked to fill gapsM SK4 Se saa suljetun kirjanpidonMST5mittatut väritMst6seurattu liikettäM st7pohdetut alaotsakeetMstr8OCR-luottamus,M st9and renders only what the substrate already contains M st10 When GPTM skk11o captions an imageM Skk12 itM sc13s guessingM ck14 When ImageSummarizer doesMsc15 it\m skk16s summarizing signals that already exist\m sc17
Järjestelmässä käytetään kaasuputki kun kukin aalto on itsenäinen analysaattori, joka tuottaa kirjattuja signaaleja. Vaivat toteutetaan ensisijaisessa järjestyksessä ( alhaisempi numero toimii ensimmäisenäM SK1, ja myöhemmät aaltot voivat lukea aikaisempien aaltojen signaaleja
Toimenpidemääräys: Aalto 10 toimii ennen Aaltoa
flowchart TB
    subgraph Wave10["Wave 10: Foundational Signals"]
        W1[IdentityWave - Format, dimensions]
        W2[ColorWave - Palette, saturation]
    end

    subgraph Wave40["Wave 40: Text Detection"]
        W9[TextLikelinessWave - OpenCV EAST/CRAFT]
    end

    subgraph Wave50["Wave 50: Traditional OCR"]
        W3[OcrWave - Tesseract]
    end

    subgraph Wave51["Wave 51: ML OCR"]
        W8[MlOcrWave - Florence-2 ONNX]
    end

    subgraph Wave55["Wave 55: ML Captioning"]
        W10[Florence2Wave - Local captions]
    end

    subgraph Wave58["Wave 58: Quality Gate"]
        W5[OcrQualityWave - Escalation decision]
    end

    subgraph Wave70["Wave 70: Embeddings"]
        W7[ClipEmbeddingWave - Semantic vectors]
    end

    subgraph Wave80["Wave 80: Vision LLM"]
        W6[VisionLlmWave - Cloud fallback]
    end

    Wave10 --> Wave40 --> Wave50 --> Wave51 --> Wave55 --> Wave58 --> Wave70 --> Wave80

    style Wave10 stroke:#22c55e,stroke-width:2px
    style Wave40 stroke:#06b6d4,stroke-width:2px
    style Wave50 stroke:#f59e0b,stroke-width:2px
    style Wave51 stroke:#8b5cf6,stroke-width:2px
    style Wave55 stroke:#8b5cf6,stroke-width:2px
    style Wave58 stroke:#ef4444,stroke-width:2px
    style Wave70 stroke:#3b82f6,stroke-width:2px
    style Wave80 stroke:#8b5cf6,stroke-width:2px
Painojärjestys ( alhaisempi kulkee ensimmäisenäM SK1 10 \→ ♫ ♫ 40 ♫
Tämä on Rajoitettu hämärä MoM Sovelletaan kuvaanalyysiin: useat esittäjät julkaisevat yhteisen pohjan (the AnalysisContext), ja lopullinen output yhdistää viestinsä
Huomautus aaltomääräyksestä: Kolme OCR:tä tasot (Tesseract/Florence-2/Vision LLM)Conceptual escalation levels.Individual waves like Advanced OCR or Quality Gate tarkistukset kyseisten tasojen sisällä, ei ole erillisiä syvennystasoja — ne tekevät määräaikaista vakauttamis- ja laatutarkastuksia
Jokainen aalto tuottaa signaaleja standardoidun sopimuksen avulla:
public record Signal
{
    public required string Key { get; init; }      // "color.dominant", "ocr.quality.is_garbled"
    public object? Value { get; init; }             // The measured value
    public double Confidence { get; init; } = 1.0;  // 0.0-1.0 reliability score
    public required string Source { get; init; }    // "ColorWave", "VisionLlmWave"
    public DateTime Timestamp { get; init; }        // When produced
    public List<string>? Tags { get; init; }        // "visual", "ocr", "quality"
    public Dictionary<string, object>? Metadata { get; init; }  // Additional context
}
Tämä on osa 2 signaalisopimus toiminnassa . Aaltot eivät puhu keskenään luonnollisen kielen välitykselläM SK2 Ne julkaisevat kirjoitetut signaalit yhteiseen kontekstiin, ja alhaalta kulkevat aaltot voivat kysyä kyseisiä signaaleja
Pankaa merkille, että Confidence on per-signaaliM SK1 ei per -aalko. Yhteinen aalto voi lähettää useita signaaleja eri epistemiikan voiman kanssaMSC4KolorWaveMST5dominoivaan väriluetteloon sisältyy luottamus MSV6 MSV7komputoituaMSTO8, mutta yksittäiset väriprosenttiosuudet käyttävät luottamusta painottavana tekijänä vaiheittainen yhteenvedon tekemisessäMSZ9
Luottamus merkitsee Downstream-käytön luotettavuus, ei matemaattista varmuutta
Determinismin varoitus:, ", Deterministinen, M SK2 merkitsee sitä, ettei näyttelyn randomiteettiä ja vakavia tuloksia ole sallittu tietyn runtimen ja konfiguroinnin osalta.., ONNXin GPU:n täytäntöönpanontarjoajat voivat ottaa käyttöön vähäisiä numerovaihteluja, jotka ovat hyväksyttäviä etenemispäätöksissä.
Jotta vältettäisiin sekaannusta, täällä ' on koko järjestelmän käytössä oleva kanonillinen OCR-signaalinamespace
| Signal Key | Alkuperä SSK2 Kuvaus | |
|---|---|---|
ocr.text |
Tesseract (Tier | |
ocr.confidence |
Tesseract | |
ocr.ml.text |
FlorenceM SK1 (Tier SSK3 | ML OCR-yhdenmukainen | |
ocr.ml.multiframe_text |
FirenzeM SK1 (Tier SSK3 | |
ocr.ml.confidence |
FirenzeM SK1 | Florence-2 luottamusta koskeva tulos SSK4 |
ocr.quality.spell_check_score |
OcrQualityWave | |
ocr.quality.is_garbled |
OcrQualityWave | |
ocr.vision.text |
VisionLlmWave | |
caption.text |
VisionLlmWave |
Merkittävä ero: ocr.vision.text on Tekstilähetys (OCR caption.text on kuvaus (captioningM SK1 Molemmat voivat tulla samasta Vision LLM-puhelusta,, mutta ne palvelevat erilaisia tarkoituksia
Lopullinen tekstivalinnan painoarvo (yleisimmistä alhaisimmista
ocr.vision.text (Vision LLM OCRocr.ml.multiframe_text (Florenceocr.ml.text (Florenceocr.text (TesseractJokainen aalto toteuttaa yksinkertaisen liittymän:
public interface IAnalysisWave
{
    string Name { get; }
    int Priority { get; }           // Lower number = runs earlier (10 before 50 before 80)
    IReadOnlyList<string> Tags { get; }

    Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,    // Shared substrate with earlier signals
        CancellationToken ct);
}
Euroopan unionin AnalysisContext on yhteisymmärrysalue osasta 2. Waves canM SK1
context.GetValue<bool>("ocr.quality.is_garbled")context.GetCached<Image<Rgba32>>("ocr.frames")ColorWave toimii ensimmäisenä (prioriteetin 10) ja laskee tosiseikat, jotka rajoittavat kaikkea muuta
public class ColorWave : IAnalysisWave
{
    public string Name => "ColorWave";
    public int Priority => 10;  // Runs first (lowest priority number)
    public IReadOnlyList<string> Tags => new[] { "visual", "color" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        using var image = await LoadImageAsync(imagePath, ct);

        // Extract dominant colors (computed, not guessed)
        var dominantColors = _colorAnalyzer.ExtractDominantColors(image);
        signals.Add(new Signal
        {
            Key = "color.dominant_colors",
            Value = dominantColors,
            Confidence = 1.0,  // Reproducible measurement
            Source = Name,
            Tags = new List<string> { "color" }
        });

        // Individual colors for easy access
        for (int i = 0; i < Math.Min(5, dominantColors.Count); i++)
        {
            var color = dominantColors[i];
            signals.Add(new Signal
            {
                Key = $"color.dominant_{i + 1}",
                Value = color.Hex,
                Confidence = color.Percentage / 100.0,
                Source = Name,
                Metadata = new Dictionary<string, object>
                {
                    ["name"] = color.Name,
                    ["percentage"] = color.Percentage
                }
            });
        }

        // Cache the image for other waves (no need to reload)
        context.SetCached("image", image.CloneAs<Rgba32>());

        return signals;
    }
}
Vision LLM saa myöhemmin nämä värit rajoitukset. Se ei saa väittää, että kuvaan sisältyy "vihreitä punaisia selkeitä selkeyttäjöitä M SK2 jos ColorWave on laskenut, että hallitseva väri on sininen
Tämä on Rajoitettu epämääräisyys shines. OcrQualityWave on Konstraineri , joka päättää, onko laajennettava kalliiksi Vision LLM:
public class OcrQualityWave : IAnalysisWave
{
    public string Name => "OcrQualityWave";
    public int Priority => 58;  // Runs after OCR waves
    public IReadOnlyList<string> Tags => new[] { "content", "ocr", "quality" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        // Get OCR text from earlier waves (canonical taxonomy)
        string? ocrText =
            context.GetValue<string>("ocr.ml.multiframe_text") ??  // Florence-2 GIF
            context.GetValue<string>("ocr.ml.text") ??             // Florence-2 single
            context.GetValue<string>("ocr.text");                  // Tesseract

        if (string.IsNullOrWhiteSpace(ocrText))
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.no_text",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Tier 1: Spell check (deterministic, no LLM)
        var spellResult = _spellChecker.CheckTextQuality(ocrText);

        signals.Add(new Signal
        {
            Key = "ocr.quality.spell_check_score",
            Value = spellResult.CorrectWordsRatio,
            Confidence = 1.0,
            Source = Name,
            Metadata = new Dictionary<string, object>
            {
                ["total_words"] = spellResult.TotalWords,
                ["correct_words"] = spellResult.CorrectWords
            }
        });

        signals.Add(new Signal
        {
            Key = "ocr.quality.is_garbled",
            Value = spellResult.IsGarbled,  // < 50% correct words
            Confidence = 1.0,
            Source = Name
        });

        // This signal triggers Vision LLM escalation
        if (spellResult.IsGarbled)
        {
            signals.Add(new Signal
            {
                Key = "ocr.quality.correction_needed",
                Value = true,
                Confidence = 1.0,
                Source = Name,
                Tags = new List<string> { "action_required" },
                Metadata = new Dictionary<string, object>
                {
                    ["quality_score"] = spellResult.CorrectWordsRatio,
                    ["correction_method"] = "llm_sentinel"
                }
            });

            // Cache for Vision LLM to access
            context.SetCached("ocr.garbled_text", ocrText);
        }

        return signals;
    }
}
Eskalaatiopäätös on deterministinen: jos pistotarkastustulos < 50%, antaa signaalin, joka herättää näkemyksen LLM:n

$ imagesummarizer demo-images/arse_biscuits.gif --pipeline caption --output text
OCR: "ARSE BISCUITS"
Caption: An elderly man dressed as bishop with text reading "arse biscuits"
Scene: meme
OCR sai tekstin; Vision LLM tarjosi näytelmätekstinM SK1 Jokainen aalto tuo mukanaan sen, mitä se on hyvässä asemassa
Vision LLM-laajuus toimii vain silloin, kun aiemmat signaalit osoittavat sen olevan tarpeen.
public class VisionLlmWave : IAnalysisWave
{
    public string Name => "VisionLlmWave";
    public int Priority => 50;  // Runs after quality assessment
    public IReadOnlyList<string> Tags => new[] { "content", "vision", "llm" };

    public async Task<IEnumerable<Signal>> AnalyzeAsync(
        string imagePath,
        AnalysisContext context,
        CancellationToken ct)
    {
        var signals = new List<Signal>();

        if (!Config.EnableVisionLlm)
        {
            signals.Add(new Signal
            {
                Key = "vision.llm.disabled",
                Value = true,
                Confidence = 1.0,
                Source = Name
            });
            return signals;
        }

        // Check if OCR was unreliable (garbled text)
        var ocrGarbled = context.GetValue<bool>("ocr.quality.is_garbled");
        var textLikeliness = context.GetValue<double>("content.text_likeliness");
        var ocrConfidence = context.GetValue<double>("ocr.ml.confidence",
            context.GetValue<double>("ocr.confidence"));

        // Only escalate when: OCR failed OR (text likely but low OCR confidence)
        // Models never decide paths; deterministic signals do (no autonomy)
        bool shouldEscalate = ocrGarbled ||
                              (textLikeliness > 0.7 && ocrConfidence < 0.5);

        if (shouldEscalate)
        {
            var llmText = await ExtractTextAsync(imagePath, ct);

            if (!string.IsNullOrEmpty(llmText))
            {
                // Emit OCR signal (Vision LLM tier)
                signals.Add(new Signal
                {
                    Key = "ocr.vision.text",  // Vision LLM OCR extraction
                    Value = llmText,
                    Confidence = 0.95,  // High but not 1.0 - still probabilistic
                    Source = Name,
                    Tags = new List<string> { "ocr", "vision", "llm" },
                    Metadata = new Dictionary<string, object>
                    {
                        ["ocr_was_garbled"] = ocrGarbled,
                        ["escalation_reason"] = ocrGarbled ? "quality_gate_failed" : "low_confidence_high_likeliness",
                        ["text_likeliness"] = textLikeliness,
                        ["prior_ocr_confidence"] = ocrConfidence
                    }
                });

                // Optionally emit caption (separate signal)
                var llmCaption = await GenerateCaptionAsync(imagePath, ct);
                if (!string.IsNullOrEmpty(llmCaption))
                {
                    signals.Add(new Signal
                    {
                        Key = "caption.text",  // Descriptive caption (not OCR)
                        Value = llmCaption,
                        Confidence = 0.90,
                        Source = Name,
                        Tags = new List<string> { "caption", "description" }
                    });
                }
            }
        }

        return signals;
    }
}
Keskeinen käsitys: Vision LLM-teksti on luottavainen 0.95, ei 1.0. Se ' on parempi kuin hajanainen OCR, mutta seM SK3 on edelleen todennäköinenMSC4 Suuntavirtayhdistäminen tietää tämänMSSK5 | ( Miksi | | Ennenmukainen | Muodollisella | mukautettu | kutakin mallia varten | on arvo, joka ei ole't M SK1
Euroopan unionin ImageLedger kerää signaaleja rakennetuiksi osuuksiksi alhaalta tulevaa kulutusta varten. Kontextin nostaminen Sovelletaan kuvaanalyysiin:
public class ImageLedger
{
    public ImageIdentity Identity { get; set; } = new();
    public ColorLedger Colors { get; set; } = new();
    public TextLedger Text { get; set; } = new();
    public MotionLedger? Motion { get; set; }
    public QualityLedger Quality { get; set; } = new();
    public VisionLedger Vision { get; set; } = new();

    public static ImageLedger FromProfile(DynamicImageProfile profile)
    {
        var ledger = new ImageLedger();

        // Text: Priority order - corrected > voting > temporal > raw
        ledger.Text = new TextLedger
        {
            ExtractedText =
                profile.GetValue<string>("ocr.final.corrected_text") ??  // Tier 2/3 corrections
                profile.GetValue<string>("ocr.voting.consensus_text") ?? // Temporal voting
                profile.GetValue<string>("ocr.full_text") ??             // Raw OCR
                string.Empty,
            Confidence = profile.GetValue<double>("ocr.voting.confidence"),
            SpellCheckScore = profile.GetValue<double>("ocr.quality.spell_check_score"),
            IsGarbled = profile.GetValue<bool>("ocr.quality.is_garbled")
        };

        // Colors: Computed facts, not guessed
        ledger.Colors = new ColorLedger
        {
            DominantColors = profile.GetValue<List<DominantColor>>("color.dominant_colors") ?? new(),
            IsGrayscale = profile.GetValue<bool>("color.is_grayscale"),
            MeanSaturation = profile.GetValue<double>("color.mean_saturation")
        };

        return ledger;
    }

    public string ToLlmSummary()
    {
        var parts = new List<string>();

        parts.Add($"Format: {Identity.Format}, {Identity.Width}x{Identity.Height}");

        if (Colors.DominantColors.Count > 0)
        {
            var colorList = string.Join(", ",
                Colors.DominantColors.Take(5).Select(c => $"{c.Name}({c.Percentage:F0}%)"));
            parts.Add($"Colors: {colorList}");
        }

        if (!string.IsNullOrWhiteSpace(Text.ExtractedText))
        {
            var preview = Text.ExtractedText.Length > 100
                ? Text.ExtractedText[..100] + "..."
                : Text.ExtractedText;
            parts.Add($"Text (OCR, {Text.Confidence:F0}% confident): \"{preview}\"");
        }

        return string.Join("\n", parts);
    }
}
Luettelo on ankkuri CFCD:n termeissä. Siihen sisältyy se, mikä selviytyneestä valiokunnasta on saatuM SK1 ja LLM-synteesissä on kunnioitettava näitä tosiseikkoja
Olette nähneet eskalaatiologiikan kahdessa paikassa. OcrQualityWave päästöt merkinnät laadusta; EscalationService sovelletaan politiikka Tämä on tahallinen erottaminen toisistaan
EscalationService kootaan signaaleja ja sovelletaan maailmanlaajuisia kynnysarvojaEuroopan unionin EscalationService liittää sen kaikki yhteen. Se panee täytäntöön osan 1 mallin : substratti → ehdottaja → konstraineri:
public class EscalationService
{
    private bool ShouldAutoEscalate(ImageProfile profile)
    {
        // Escalate if type detection confidence is low
        if (profile.TypeConfidence < _config.ConfidenceThreshold)
            return true;

        // Escalate if image is blurry
        if (profile.LaplacianVariance < _config.BlurThreshold)
            return true;

        // Escalate if high text content
        if (profile.TextLikeliness >= _config.TextLikelinessThreshold)
            return true;

        // Escalate for complex diagrams or charts
        if (profile.DetectedType is ImageType.Diagram or ImageType.Chart)
            return true;

        return false;
    }
}
Jokainen laajentumispäätös on deterministinen: samat tulot,,, samat kynnysarvot, ,, sama päätös
Kun Vision LLM toimii, se saa lasketut tosiasiat rajoituksiin.
private static string BuildVisionPrompt(ImageProfile profile)
{
    var prompt = new StringBuilder();

    prompt.AppendLine("CRITICAL CONSTRAINTS:");
    prompt.AppendLine("- Only describe what is visually present in the image");
    prompt.AppendLine("- Only reference metadata values provided below");
    prompt.AppendLine("- Do NOT infer, assume, or guess information not visible");
    prompt.AppendLine();

    prompt.AppendLine("METADATA SIGNALS (computed from image analysis):");

    if (profile.DominantColors?.Any() == true)
    {
        prompt.Append("Dominant Colors: ");
        var colorDescriptions = profile.DominantColors
            .Take(3)
            .Select(c => $"{c.Name} ({c.Percentage:F0}%)");
        prompt.AppendLine(string.Join(", ", colorDescriptions));

        if (profile.IsMostlyGrayscale)
            prompt.AppendLine("  → Image is mostly grayscale");
    }

    prompt.AppendLine($"Sharpness: {profile.LaplacianVariance:F0} (Laplacian variance)");
    if (profile.LaplacianVariance < 100)
        prompt.AppendLine("  → Image is blurry or soft-focused");

    prompt.AppendLine($"Detected Type: {profile.DetectedType} (confidence: {profile.TypeConfidence:P0})");

    prompt.AppendLine();
    prompt.AppendLine("Use these metadata signals to guide your description.");
    prompt.AppendLine("Your description should be grounded in observable facts only.");

    return prompt.ToString();
}
Vision LLM:n ei pidä väittää "vapaat värit", jos laskemme vihreän mittakaavan -, mikäli se on havaittavissa määritelmäperusta rajoittaa todennäköistä tulosta.
Nämä rajoitukset vähentävät hallucinaatiota, mutta ne eivät voi poistaa sitä-pyynnöt ovat ehdotuksia, eivät takaaM SK2 Todellinen täytäntöönpano tapahtuu ketjussa luottamuksen painottamisen ja signaalin valinnan kautta .pyynti on yksi kerrosMSC4rakenne on toinen
Lopullisen tekstin kääntämisessä, järjestelmä käyttää tiukan ensisijaisuusjärjestyksen:
static string? GetExtractedText(DynamicImageProfile profile)
{
    // Priority chain using canonical signal names (see OCR Signal Taxonomy above)
    //   1. Vision LLM OCR (best for complex/garbled)
    //   2. Florence-2 multi-frame GIF (temporal stability)
    //   3. Florence-2 single-frame (stylized fonts)
    //   4. Tesseract (baseline)

    var visionText = profile.GetValue<string>("ocr.vision.text");
    if (!string.IsNullOrEmpty(visionText))
  ocally (confidence 0.85-0.90, no cost)
- **Tesseract voting**: Reliable for clean text (confidence varies, deterministic)
- **Raw Tesseract**: Baseline fallback (confidence < 0.7 for stylized fonts)

The priority order encodes this knowledge. Florence-2 sitting between Vision LLM and Tesseract provides a "sweet spot" for most images—better than traditional OCR, cheaper than cloud Vision LLMs.

Note: this function selects *one* source, but the ledger exposes *all* sources with their confidence scores. Downstream consumers can-and should-inspect provenance when the domain requires it. The priority order is a sensible default, not a straitjacket.

---

## Selection and Conflict Resolution

The priority chain above is the current implementation-a simple fallback. But the architecture supports adding rejection rules as config-driven policy. Here's the pattern for contradiction detection (not yet implemented, but the signals exist to support it):

```csharp
// Pattern: Contradiction detection as policy rules
public static class SelectionPolicy
{
    public static string? SelectTextWithConstraints(DynamicImageProfile profile)
    {
        var visionText = profile.GetValue<string>("vision.llm.text");
        if (!string.IsNullOrEmpty(visionText))
        {
            // Rule: Reject if Vision claims text but deterministic signals say no text
            var textLikeliness = profile.GetValue<double>("content.text_likeliness");
            if (textLikeliness < _config.TextLikelinessThreshold && visionText.Length > 50)
            {
                // Contradiction detected - log and fall through
                profile.AddSignal(new Signal
                {
                    Key = "selection.vision_rejected",
                    Value = "text_likeliness_contradiction",
                    Confidence = 1.0,
                    Source = "SelectionPolicy",
                    Metadata = new Dictionary<string, object>
                    {
                        ["text_likeliness"] = textLikeliness,
                        ["vision_text_length"] = visionText.Length,
                        ["threshold"] = _config.TextLikelinessThreshold
                    }
                });
                // Fall through to OCR sources
            }
            else
            {
                return visionText;
            }
        }

        // Continue with priority chain...
        return profile.GetValue<string>("ocr.voting.consensus_text")
            ?? profile.GetValue<string>("ocr.full_text");
    }
}
Samaa mallia sovelletaan muihin signaalityyppeihin:
color.is_grayscale on tottaquality.sharpness < kynnyscontent.type on Luottavainen kuvaValinnanlaitteen keskeiset ominaisuudet:
Tässä on kyse siitä, että "determinismi pysyy ennallaan " muuttuu mekaanisesti todelliseksi
Ohjeet voidaan täysin konfiguroida JSONin avulla,, mikä tekee virtakokoonpanosta selvän ja tarkastettavan :
{
  "name": "advancedocr",
  "displayName": "Advanced OCR (Default)",
  "description": "Multi-frame temporal OCR with stabilization and voting",
  "estimatedDurationSeconds": 2.5,
  "accuracyImprovement": 25,
  "phases": [
    {
      "id": "color",
      "name": "Color Analysis",
      "priority": 100,
      "waveType": "ColorWave",
      "enabled": true
    },
    {
      "id": "simple-ocr",
      "name": "Simple OCR",
      "priority": 60,
      "waveType": "OcrWave",
      "earlyExitThreshold": 0.98
    },
    {
      "id": "advanced-ocr",
      "name": "Advanced Multi-Frame OCR",
      "priority": 59,
      "waveType": "AdvancedOcrWave",
      "dependsOn": ["simple-ocr"],
      "parameters": {
        "maxFrames": 30,
        "ssimThreshold": 0.95,
        "enableVoting": true
      }
    },
    {
      "id": "quality",
      "name": "OCR Quality Assessment",
      "priority": 58,
      "waveType": "OcrQualityWave",
      "dependsOn": ["advanced-ocr"]
    }
  ]
}
Early exit thresholds let expensive waves skip when cheap waves already achieved high confidence. Tämä on budjettihallinto osasta M SK1
Euroopan unionin auto putkilla toteutetaan kuvaominaisuuksiin perustuvaa älykästä reittiliikennettä, optimaalisen käsittelyn etenemistavan valitseminenM SK1
Image Analysis (OpenCV ~5-20ms)
    │
    ├── Is animated (>1 frame)?
    │   └── ANIMATED route
    │       ├── Has subtitle regions? → Text-only strip extraction
    │       ├── Minimal text? → FAST (Florence-2 only)
    │       └── Motion significant? → Motion analysis
    │
    ├── Has text regions (OpenCV detection)?
    │   ├── High contrast, clean text → FAST route (Florence-2, ~100ms)
    │   ├── Moderate confidence → BALANCED route (Florence-2 + Tesseract, ~300ms)
    │   └── Low confidence → QUALITY route (Multi-frame + Vision LLM, ~1-5s)
    │
    ├── Is chart/diagram (type detection)?
    │   └── QUALITY route → Vision LLM caption
    │
    └── Default → FAST route (Florence-2 caption)
| Reitti | Triggers When | 2 | käsittely | 3 | aika | 4 | kustannus | 5 | |||
|---|---|---|---|---|---|---|---|---|---|---|---|
| Nopeutettu | yksinkertainen teksti, korkea kontrastiM SK3 standard-fontit SSK4 FirenzeMSC5 vain | S~100ms M | alhainen МSK9 paikallinenMST10 | | ||||||||
| BALANCED | Tavallinen tekstiM SK2 maltillinen luottamus | Firenze-2 + Tesseract-äänestys M | ~300ms | alhainen | 9 | paikallista | 10 | 11 | |||
| laadukkuus | taulukotM SK2図t, stylisoidut kirjaimetMSC4 alhainen luottamuksen taso | monimuotoiset M-puitteet | + Vision LLM | ~1-5 | keskikokoinen | ||||||
| GIF-GIF-levyt, joissa on alaotsauksia. |
$ imagesummarizer anchorman-not-even-mad.gif --pipeline auto --output visual
[Route selection...]
  Image: 300×185, 93 frames
  Text detection: 15 regions found (bottom 30%)
  Subtitle pattern: DETECTED
  → Selected ANIMATED route (text-only filmstrip)

[Processing...]
  MlOcrWave: Extracted 10 frames → 2 unique text segments
  Text-only strip: 253×105 (83% token reduction)
  VisionLlmWave: Processing filmstrip...

[Results - 2.3s total]
Text: "I'm not even mad." + "That's amazing."
Caption: A person wearing grey turtleneck sweater with neutral expression
Scene: meme
Motion: SUBTLE general motion
Routing-päätös on deterministinen ja kirjattu tarkastussignaaleihin:
{
  "routing": {
    "selected_route": "ANIMATED",
    "reason": "subtitle_pattern_detected",
    "text_regions": 15,
    "frames": 93,
    "decision_time_ms": 18
  }
}
# Use auto pipeline (smart routing - recommended)
imagesummarizer meme.gif --pipeline auto

# Fast local caption with Florence-2 ONNX (~200ms)
imagesummarizer photo.jpg --pipeline florence2

# Best quality: Florence-2 + Vision LLM
imagesummarizer complex-diagram.png --pipeline florence2+llm

# Extract text only (three-tier OCR)
imagesummarizer screenshot.png --pipeline advancedocr

# Motion analysis for GIFs
imagesummarizer animation.gif --pipeline motion

# Process a directory with visual output
imagesummarizer ./photos/ --output visual
Pyydän vain tarvitsemianne signaaleja käyttäen ennalta määriteltyjä keräysalueita-
# Minimal metadata (fast)
imagesummarizer image.png --signals "@minimal"

# Alt text for accessibility
imagesummarizer image.png --signals "@alttext"

# Motion analysis
imagesummarizer animation.gif --signals "@motion"

# Full analysis
imagesummarizer image.png --signals "@full"

# Custom wildcard patterns
imagesummarizer image.png --signals "color.dominant*, ocr.text, motion.*"
| keräys | signaalit | käyttötapa SSK3 |
|---|---|---|
@minimal |
henkilöllisyys*, laadukkuusM SK1sharpness | |
@alttext |
captionM SK1text, ocrMSC3 text , colorMST5dominant* | Mahdollisuus |
@motion |
toimenpide*,identiteetin,.rajan,M SK2laskennan, | Animointianalyysin, |
@full |
Kaikki signaalit | Täydenteinen analyysi |
@tool |
Optimisoitu alakoko | MCPM SK2automatiointi |
$ imagesummarizer princess-bride.gif --output json
{
  "image": "princess-bride.gif",
  "duration_ms": 1838,
  "waves_executed": ["ColorWave", "OcrWave", "AdvancedOcrWave", "VisionLlmWave"],
  "text": {
    "value": "You keep using that word.\nI do not think it means what you think it means.",
    "source": "ocr.voting.consensus_text",
    "confidence": 0.95
  },
  "escalation": {
    "triggered": true,
    "reason": "text_likeliness_above_threshold",
    "threshold": 0.4,
    "observed": 0.67
  },
  "signals": {
    "color.dominant_1": { "value": "#1a1a2e", "confidence": 1.0 },
    "ocr.quality.spell_check_score": { "value": 0.82, "confidence": 1.0 },
    "ocr.quality.is_garbled": { "value": false, "confidence": 1.0 },
    "motion.type": { "value": "static", "confidence": 0.95 }
  }
}
Jokaisella alueella on alkuperää. escalation lohkoesitykset miksi Vision LLM:n nimi oli .

$ imagesummarizer demo-images/alanshrug_opt.gif --pipeline motion
Motion: SUBTLE general motion (localized coverage)
Direction: up-down
Magnitude: 0.23
$ imagesummarizer
ImageSummarizer Interactive Mode
Pipeline: advancedocr | Output: auto | LLM: auto
Commands: /help, /pipeline, /output, /llm, /model, /ollama, /models, /quit

Enter image path (or drag & drop): F:\Gifs\meme.gif
Processing...
I'm not even mad. That's amazing.

Enter image path: /llm true
Vision LLM: enabled

Enter image path: /model minicpm-v:8b
Vision model: minicpm-v:8b
Visuaalisen tarkastelun osalta”,” -käyttöohjelmassa on ”:”
Desktop-GUI osoittaa arkkitehtuurin näkyvästi— voitte nähdä tarkasti, mitkä aaltot toimivat, mitkä signaalit ne välittävät , ja miten etenemispäätökset tehtiinM SK3 Sopimaa järjestelmän ymmärtämiseen tai räätälöityjen putkien parannuskeinoihinMSC4
CLI paljastaa kaiken monimutkaisuuden yksinkertaisina vaihtoehtoina. Voi vaihtaa putkeitäM SK1 malleja , ja output-formatteja ymmärtämättä aaltorakennetta.
| Osuus | Pattern | ImageSummarizerin täytäntöönpano |
|---|---|---|
| 1 | Rajoitettu epämääräisyys | ColorWave laskee tosiasiatM SK1 VisionLlmWave kunnioittaa niitä |
| 2 | Rajoitettu hämärä MoM | Useat aaltot julkaistaan analysointiinContextiin ; WaveOrchestrator coordinates |
| 3 | Kontextin nostaminen | ImageLedger kerää merkittäviä piirteitäM SK1 SignalDatabase Cache-tulokset |
Samat mallit. Erityinen alue. Sama sääntöM SK2 todennäköisyys ehdottaa, määritelmäkysymys säilyy.
Tämä ei ole nopea tie. SeM SK1 on luotettava tie . Se kannattaa, jos tarvitsette mittakaavassa tarkastettavissa olevaa kuvaa koskevan ymmärryksen
| Epäonnistumismodus | Mitä tapahtuu SSK2 Miten se toimi ' Handled S | |||
|---|---|---|---|---|
| Noisy GIF | TaajuusruiskutM SK1 Kompression artifactit | Väliaikainen vakauttaminen + SSIM-yhdenmukaistaminen SSK4 äänestysäänestys yksimielisyys | ||
| OCR palauttaa jätteen | Tesseract on epäonnistunut stylisoitujen fontien osalta | Sanonta-tarkastusportaali paljastaa SSK3 CSK4 oikean → etenee FirenzeenM SK6 \→ Näkemys LLM, jos se on edelleen heikkoa. | ||
| Korkeat API-kustannukset | Liian monta pilvikuva-alan LLM-puhelua | Florence-2 ONNX-järjestelmässä käsitellään SSK3 paikallisesti | ||
| Näkemyksen hallucinaatiot | LLM väittää tekstin olevan puutteellinenM SK1 ei ole olemassa | signaalit mahdollistavat ristiriitojen havaitsemisenvision.llm.text vs content.text_likeliness |
||
| Pipeline-muutos ajan myötä | Uusia aaltoja lisättiinM SK1 kynnysarvot mukautettiin | sisältö-hash-kutiointi | + täysi alkuperä jokaisessa signaalissa | + versioseuranta |
| Malli ei palauta mitään | Vision LLM-aika-aikojen tai tyhjän vastauksen katkaiseminen | Fallback chainM SK2 Vision lLM → Florence-2 M→ Tesseract-äänestys \→ Raw OCR \ ; ensisijainen järjestys varmistaa hienotunteisen heikentymisen |
Jokaisella epäonnistumistapalla on deterministinen vastaus. Ei hiljaista degradaatiotaM SK1
Tärkeää taustaa: ImageSummarizer on kuvainnoitteluputki LucidRAG-ekosysteemille.
Tässä artiklassa keskitytään rakenteellisten merkintöjen extrahointiin kuvista. mutta todellinen voima ilmenee, kun sitä yhdistetään muihin yhteenvetovälineisiinM SK1
Kun on sidottu yhteen LucidRAG Nämä kolme putkea mahdollistavat multi-modal graph RAG:
Document → DocSummarizer → Structured signals
    ↓
Images → ImageSummarizer → Structured signals
    ↓
Data → DataSummarizer → Structured signals
    ↓
    ↓ (all signals)
    ↓
LucidRAG Graph Builder → Multi-modal knowledge graph
    ↓
Query → Multi-modal retrieval + constrained generation
Miksi tämä on tärkeää?: Perinteinen RAG kohtelee kuvia hämärinä hiukkasina, jotka saavat captionin ensimmäisen luokan --signaalilähteet kirjattujen yhteyksien kanssa tekstiin, tietojenM SK1 ja muiden kuvien . Samat määritelmäperiaatteet, eri mittakaavatMSC4
Muodot mittaavat:, jos voidaan extrahoida rakenteellisia signaaleja kuvia M SK1 tämä artikla), asiakirjat (DocSummarizer), ja tiedot (DataSummarizer), voitte rakentaa tietografian, jossa jokaisella nojalla on alkuperää ja jokaisella rintamalla luottamusta.
Tulee pian: Full LucidRAG integration showing how these pipelines compose into multi
Järjestelmä on rakenteellinen: jokainen aalto on itsenäinen, jokainen signaali on kirjoitettuM SK2 jokainen laajeneminen on determinististaMSC3 FirenzeMST4 tarjoaa nopean paikallisen analyysinMSV5 Vision LLM käsittelee monimutkaisia tapauksiaMSSK6 mutta kumpikaan ei toimi rajoittamattaMSR7deterministiset signaalit ankkuroivat aina outputinMSL8
Alkuperäisen artikkelin julkaisemisen jälkeen järjestelmä on kehittynyt merkittävästi
Ainoastaan OCR-putkelinjoista: —, jossa on kolme vaihetta (-, , ja -), monivaiheinen MSK3, järjestelmällinen ,, filmtripin optimointi , ja tekstin optimoiminen -, yksinomaan stripiextraatio —, on tullut riittävän monimutkainen varmistaakseen oman yksityiskohtaisen artiklansa Näkemys OCR-integraatio täydellisen teknisen katkaisun ohjeet.
Jos voitte tehdä tämän kuvien osalta—kaikkein epämääräisimpien input-tyypin osalta ,OCR:n melua sisältävillä muodollisilla muodoillaM SK2styliitettyjä fontteja,animoituja muodollisia muokkaavia piirteitäMSC4 ja hallucinaatiota vartenMST5hyväksyttyjen captiontien osaltaSST6voitte tehdä sen minkä tahansa todennäköisyystekijän osaltaMSKT7
Se' rajoitettu epämääräisyys käytännössä. Ei abstrakti malliMSC2 TyökoodiM SK3
| Osuus | Muodos | Axis SSK3 |
|---|---|---|
| 1 | Rajoitettu epämääräisyys | Yksittäinen osake |
| 2 | Rajoitettu hämärä MoM | Useat osat |
| 3 | Kontextin nostaminen | Aika / muisti |
| 4 | Luonnollinen tiedustelu (artikkeliM SK1 | Wave-arkkitehtuuri, malleja |
| 4.1 | Kolmansien -Tier OCR-putken putki | OCR, ONNX-mallit, filmtrips |
Seuraava: Osa 5 osoittaa, miten ImageSummarizer DocSummarizer, ja DataSummarizer compose multi-modal graph RAGin kanssa LucidRAGM SK1
Kaikki osat seuraavat samaa invarianttia: todennäköiset osatekijät ehdottavat; määritelmäjärjestelmät pysyvät.

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.

