


不断演变的AI 工作流程和简单化驱动
为什么人类大脑在20瓦上运行实时认知——而我们最好的人工智能模型需要兆瓦来谈论早餐?
现代LLMs的目的是要像一个巨大的皮层- 记忆吨,性能吨,但是 单。为了执行任务,一个人会不费力地做,他们用数十千兆字节的记忆 来咀嚼千瓦的能量。如果大脑用20瓦来工作的话,那就不对了。
这就是他们所缺少的:大脑不是一团灰色果冻, 多个专门次系统 处理视觉、移动、内存存储( 在层中 ! ) , 都由皮层协调 。 LLMs 不这样做 。 他们就像一个巨大的思维引擎 被固定在愚蠢的基础设施上。 他们的储存不适应。 他们不建立专业的子系统 。 他们是不完整的。
我曾经是一个心理学家,所以我想到了这样的事情。这是我在DISE周围建立的基本原理:
"夏普认知稳定 复杂认知"
您的大脑不会在每次迈出一步时重新计算如何行走。 它会卸下快速、便宜、自动的子系统。 这种稳定性会释放出昂贵的前额皮层来处理新问题。 DISE也这样做: 它用廉价的Python脚本取代昂贵的LLM电话, 使前沿模型能够解决真正棘手的问题。 系统通过简化而不是复杂来稳定自己。
如果你的人工智能工作流程意识到 它不需要人工智能 变成Python脚本怎么办? DISE就是这样做的。 它建立工作流程, 作为存储在 RAG 基质中的可测试工具。 当模式变得清晰时, 它用瞬时的 Python 替换LLM 电话。 当你需要更多功能时, 它只建立所需要的—— 可以预见的, 可以测试的。 当工具漂移时, 它会在你注意到之前摆脱问题。 一个微小的哨兵模型 ( 1B params) 处理所有无聊的便衣管理。 将边疆 LLM 简单连接起来, 以优化一切, 然后断开并永远运行。 AI 效率越高, 它运行的时间越长 — 这正是生产系统应该如何运作的。
当今大多数人工智能系统都是像我的第一个PHP脚本2003年卷轴—— 脆弱,无法测试,当它们破损时, 你也有同样的可能性去调试它们, 就像向一个迷惑的美国人解释布莱斯特一样。
当他们失败的时候,你无法知道他们为什么失败的时候。当他们漂流的时候,你无法知道他们为什么失败的时候。 会),您在产品着火前不会注意到。当您需要改进它们的时候?回到原点。数字西西弗斯。
有更好的办法。如果每个人工智能工具都是从第一天起就像正常软件一样建立起来, 测试、合同、规格和问责。当审计师来敲门时,他们并没有逃避。
这不是蒸汽软件 这是工作代码 这是人工智能工程在成长时应该如何工作的
让我用图表给你画一幅画, 因为我喜欢这样:
graph TD
    A[Traditional AI Development] --> B[Write Prompt]
    B --> C[Hope for Best]
    C --> D{Does it work?}
    D -->|Sometimes| E[Ship It™]
    D -->|Usually| F[Tweak Prompt]
    F --> C
    E --> G[Production]
    G --> H[Silent Drift]
    H --> I[Everything's Fine...]
    I --> J[Until It's Not]
    J --> K[Panic]
    K --> L[No Audit Trail]
    L --> M[Start Again]

    style K stroke:#f96
    style L stroke:#f96
    style M stroke:#f96
听上去很熟悉?这就是大多数人工智能系统是如何建立起来的。它完全是香蕉。
以下是由人工智能生成的“工具”在我的系统中看起来是什么样子——来自CLI,没有烟雾和镜子:
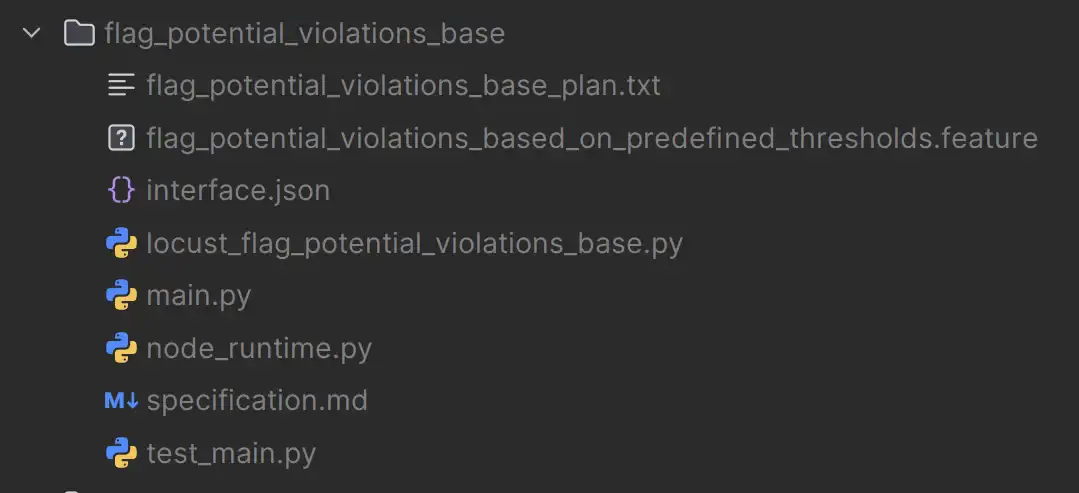
flag_potential_violations_base/
├─ flag_potential_violations_base_plan.txt   ← generation plan
├─ flag_potential_violations_based_on_predefined_thresholds.feature   ← BDD spec
├─ interface.json                            ← declared IO contract
├─ specification.md                          ← intent & description
├─ main.py                                   ← implementation (generated)
├─ test_main.py                              ← unit + BDD tests
├─ locust_flag_potential_violations_base.py  ← load/performance tests
└─ node_runtime.py                           ← runtime integration (a mock of it's tool call for testing use)
那文件夹结构? 实际实际产出产出每一个文件,都来自AI本身。
每个节点是:
这不是即时工程 AI作为纪律软件- 那种你可以真正信任 生产而不检查 黑色每5分钟。
这是非常聪明的一点: 他们只是Python脚本正确、无趣、可测试的 Python 脚本。但是它们生活在一个基于RAG的进化基体中,每个工具的规格都成为其特性的一部分。这个系统可以动态地从工作流程到小型的通用脚本。
如果你的人工智能驱动工作流程决定 它真的不需要人工智能呢? 这就发生了。工作流程运行了几次, 模式变得清晰, 系统意识到“ 这只是数据转换, 为什么我叫LLM? ” 所以它生成了一个纯的 Python 脚本。 下次你提出同样的请求时? 参考没有API电话,没有标志,没有延缓,只是无聊,快,可预测的Python。
或许你还需要更多。也许工作流程需要额外的验证检查。在我的系统中,新的工作是 需要时仅加系统仅以这些新部件作为工具来建立这些新部件,也许以现有工具为基础,也许全新的工具为基础,但总是可以预测,而且总是可以预测的,总是可以检验的。没有过度工程,没有“以防万一”代码,只是解决你目前面临的实际问题的最起码可行工具。
升级一个工具( 以导引、 可严格测试的方式) , 以及使用它的所有工作流程, 都会立即受益 。 不重新调配 。 不进行连锁修改 。 只是更好的工具, 所有人都可以自动使用 。
创造工具的"AI"不是一个单一的模型。 专 专 资 资 资 资 资 资 资 资 资 资 资 资每个都配有精心调制的启动器提示器 像一个合适的软件工程团队一样工作
Forge 工作流程 :
call_tool("tool_name", prompt) - 这是关于可变性的关键这是突破。 任务被细分为原子操作——就像我在30年中学会的建造软件一样。 足够好 当任务很小而监督员提供详细的执行指示时,生成代码。
监督员不只说“写一个调度仪”——它提供:
A7B模型可以从这个规格中写出固态代码, 因为没有要求它设计任何东西——只要执行一个详细的蓝图。 那是 为什么这个系统中的小模型能为代码生成工作。
当 Forge 运行工作流程时, 它仍然可以通过 RAG 动态合成。 如果一个新的、更好的工具显示通过相同的测试, 它会自动被使用。 下次会记住 。
让我用另一张图表给你们看建筑图, 因为我显然不能控制自己:
graph TB
    subgraph "RAG-Based Tool Substrate"
        A[Semantic Intent] --> B[Plan Generation]
        B --> C[Contract Definition]
        C --> D[Code Generation]
        D --> E[Test Generation]
        E --> F[Fitness Evaluation]
        F --> G{Passes?}
        G -->|Yes| H[RAG Storage]
        G -->|No| I[Evolutionary Improvement]
        I --> D
        H --> J[Tool Specification + Code]
    end

    subgraph "Dynamic Composition"
        J --> K[Workflow Assembly]
        K --> L[Tool Discovery via RAG]
        L --> M[Runtime Execution]
        M --> N{Tool Upgrade?}
        N -->|Yes| H
        N -->|No| O[Continue]
    end

    style H stroke:#9f6
    style J stroke:#9f6
    style L stroke:#6cf
RAG基底酱是秘密酱汁 每个工具的规格 — — 其合同、其目的、其健康分数 — — 都成为可搜索的身份。当您需要工具时,系统会找到最佳匹配。当您升级工具时,使用工具的每一个工作流程都会自动得到改进。
这就像拥有一个自我组织的工具箱 随着时间的推移会变得更聪明。
正常人工智能使用“快速研究”方法。 每次他们处理一个任务, 他们就急着准备一个考试—— 阅读所有背景, 找出问题, 产生一个解决方案。就像每次你上车都要重新上驾驶课一样。 而不是你的驾驶。 测试测试 (尽管这是另一个问题 AI解决方案),你的实际 经验教训想象一下解释离合器每天早上在通勤前做什么
现代代码 CLIs有一个部分解决方案: 查看您的 CLAUDE. md 的项目目录, 或者一连串奇特的标记文档。 那些文件吗? 这是他们能对记忆做的最好。 这就像离开 Post - It 笔记给自己, 除了每次做任何事情之前你都要阅读它们。
DISE其实记得。 当它解决问题时, 它会将解决方案存储为 RAG 基质中的测试、 有文件记录的工具 。 下次它会使用它 。 不要再学习 。 不要重新配置 。 不要“ 再让我读一遍你所有的上下文文件 ” 。 它昨天驱动了这条路线, 它知道转弯的位置 。
这直接与我在我的语义情报系列里 一直在讨论的概念有关:
每个节点都已经:
而不是更多的象征物, 不是更大的模型, 而不是另一个血腥的ChatGPT包装纸。
下面是真正重要的一点: 工具及LLMM是可选的。系统船舶的默认 LLM ,如果有必要,它可以从零开始解决一切问题。但工具可以让它有一个头等头等头等头。
想想像图书馆书籍这样的工具。 其中一些是 JSON 文件( 用于推理、 编码、 分析的专家提示- 它们自身可变和可演化 ) 。 许多是 Python 脚本( 静态分析, 用于 ML 的 scikit- Learn 、 神经翻译- 专家能力 ) 。 有些甚至有模板( 用于代码生成, 在创建新工具时让系统有一个更紧密的循环 ) 。 一个工具实际上安装了 Node.js , 并使用美人鱼. js 来绘制图表 。 有些是系统可以查询的数据存储 。 有些是常见模式的代码修正 。
他们都住在区域咨询组内,所有工作流程都可进入。
你没有 需要 需要 图书馆。 系统可以自己解决事情。 但有200个工具就像有200本书来解释“ 如何高效地做 X” 。 当它需要解析 JSON 时, 它不必从最初的原则中得出 JSON 的解析。 它有一个工具。 当它需要机器学习时, 它不需要实施梯度下降- 它叫做 cikit-learn。 当它需要生成图表时, 它使用美人鱼工具来安装自己的依赖性 。
该系统可以:
graph LR
    subgraph "Tool Ecosystem"
        A[Python Scripts] --> E[RAG Substrate]
        B[LLM Specialists] --> E
        C[External APIs] --> E
        D[MCP Tools] --> E
    end

    E --> F[Dynamic Discovery]
    F --> G[Workflow Composition]
    G --> H[Execution]
    H --> I[Feedback & Learning]
    I --> E

    style E stroke:#6cf
    style F stroke:#9f6
因为所有的东西都存储在RAAG基基底 加上语义搜索 相互联系的系统网络的相互联系的相互联系的系统网络 共享工具和学习。 一个系统会找出如何处理复杂的数据转换? 每个连接的系统现在都知道了。
系统基于 应用压力:
它只在有需要时才起作用。没有过早的优化。没有“我们有一天可能需要这个”代码。它只是针对实际的、测量的问题进行有针对性的改进。
这就像有一个蜂窝的头脑 对于你的工具, 除了不毛骨悚然, 更可审计。
这里就是它获得适当的 ci-fi 的地方( 但用一种好的方式)。 多个例子可以分享RAG基质, 创建一个 相互联系的系统网络的相互关联 共同学习和改进:
graph TB
    subgraph "System A"
        A1[Workflow] --> A2[Tool Discovery]
        A2 --> A3[RAG Substrate]
    end

    subgraph "System B"
        B1[Workflow] --> B2[Tool Discovery]
        B2 --> B3[RAG Substrate]
    end

    subgraph "System C"
        C1[Workflow] --> C2[Tool Discovery]
        C2 --> C3[RAG Substrate]
    end

    A3 <--> D[Shared Tool Repository]
    B3 <--> D
    C3 <--> D

    D --> E[Collective Learning]
    E --> F[Improved Tools]
    F --> D

    style D stroke:#6cf
    style E stroke:#9f6
这在实践中意味着什么:
每个系统都有自己的工作流程和专长,但它们都促进并受益于一个共同的、经过测试的、经过验证的、符合健康分类的工具库。
这是合作的人工智能工程,没有混乱。每个贡献都经过测试、版本和可审计。没有人能不小心打破别人的东西(看看你,节点-模块 ) 。
另一个聪明的方面是: 系统不需要昂贵的边境模型 24/7全天24小时运行。它使用 将毕业的工作流程 方针,其中:
graph TD
    A[Task Arrives] --> B[Sentinel: 1B LLM]
    B --> C{Classify Complexity}
    C -->|Housekeeping| D[Sentinel Handles It]
    C -->|Simple| E[Local Model]
    C -->|Moderate| F[Mid-Tier Model]
    C -->|Complex| G[Frontier Model]

    D --> H[Routing, Classification, etc.]
    E --> I[Fast & Cheap]
    F --> J[Balanced]
    G --> K[Powerful]

    H --> L{Success?}
    I --> L
    J --> L
    K --> L

    L -->|Yes| M[Result]
    L -->|No| N[Escalate to Higher Tier]
    N --> F
    N --> G

    style B stroke:#6cf
    style D stroke:#6cf
    style E stroke:#9f6
    style F stroke:#ff9
    style G stroke:#f96
哨兵是降低成本的秘密 这是一个小的,快速的 1B 参数模型 不断运行,处理:
把它想象成一个接待员,他知道什么时候自己会处理某事,什么时候会升级为高级合伙人。 它以毫秒的速度运行,花费一便士的一小部分,并且让昂贵的模型不会被三分法所困扰。
但在这里,它变得非常有趣: 临时连接到边境LLM (哪怕只是几个小时) 系统将使用 额外的电源:
然后,你就可以切断昂贵的模型, 系统继续运行 与所有这些改进 烤制成 由测试过的 Python 脚本。 哨兵让所有的东西都不停地倒转, 你基本上已经“ 将” 前沿模型的智能“ 提炼” 进入了工具库 。
该系统还应对数据和环境变化 以动态和低廉的价格:
graph LR
    A[Environmental Change] --> B[Pattern Detection]
    B --> C{Existing Tool?}
    C -->|Yes| D[Use Cheap Model]
    C -->|No| E[Generate New Tool]
    E --> F[Frontier Model]
    F --> G[Test & Validate]
    G --> H[Add to RAG]
    H --> D
    D --> I[Continue Cheaply]

    style D stroke:#9f6
    style F stroke:#f96
    style I stroke:#9f6
实际上:
基本上你先付情报费,然后在自动驾驶上运行。这就像聘请顾问来修正你的程序, 除了顾问是一个LLM, 修补是由版本控制的 Python 脚本, 带有测试覆盖。
毕业工作流程概念意味着您可以动态地应对环境变化,并维持每天一分钱的庞大系统,只有在真正需要时,才升级为昂贵的模型。
好吧,让我来澄清一下这个系统实际上做了什么, 因为大多数AI声称听起来像硅谷童话故事:“AI注意到一切被摧毁了,英勇地拯救了今天!” 这并不是这里发生的事情。这比这更成熟。
以下是实际机制:
graph TB
    A[Tool in Production] --> B[Fitness Monitoring]
    B --> C[Performance Tracking]
    C --> D{Drift Detected?}
    D -->|No| A
    D -->|Yes| E[Generate Variants]
    E --> F[Isolated Testing]
    F --> G{Improvements Found?}
    G -->|No| A
    G -->|Yes| H[Merge to Tool]
    H --> I[Update Tests]
    I --> J[Update Audit Trail]
    J --> K[Update Provenance]
    K --> A

    style D stroke:#ff9
    style G stroke:#ff9
    style H stroke:#9f6
系统:
它并没有“解决问题”。 它只是从它演变而来。
没有紧急反应,没有事故报告。没有验尸会,每个人都会假装知道发生了什么。系统注意到了一种趋势,探索了替代方法,验证了改进方法并将其整合起来。当一个人发现一些东西稍有脱落时,工具已经自我改进了。
假设你有一个工具来分析API的响应。在三个星期里, API提供商对其格式做了微妙的改变, 没有立即打破, 只是小的不一致。 反应时间增加了50米。 分析成功率从99.8%下降到99.3%。
传统办法:
DISE 方法 :
没有戏剧 没有干预 只是纪律严明 预防性进化
这不是魔法 绝对不是AGI在做神秘的事情
sequenceDiagram
    participant M as Monitoring
    participant A as Analyser
    participant G as Generator
    participant T as Test Harness
    participant V as Validator
    participant I as Integrator

    M->>A: Performance metrics trending down
    A->>A: Analyse fitness scores
    A->>G: Request variants
    G->>G: Generate alternatives
    G->>T: Submit for testing
    T->>T: Run full test suite
    T->>V: Results + metrics
    V->>V: Compare fitness scores
    alt Improvement Found
        V->>I: Merge approved variant
        I->>I: Update code, tests, docs
        I->>M: Resume monitoring
    else No Improvement
        V->>M: Continue monitoring
    end
每一个步骤都是决定性的,每一个决定都是可以衡量的,每一个变化都是可以审计的。
"革命"只是:
这不是明智的,不是聪明的 只是耐心的,彻底的,周末不放假
因为没有纪律,这里是这样的:
graph TD
    A[Undisciplined AI] --> B[Behaviour Drift]
    A --> C[Silent Failures]
    A --> D[Untraceable Decisions]
    A --> E[Mystery Bugs]

    B --> F[Production Incident]
    C --> F
    D --> F
    E --> F

    F --> G[Debugging Session from Hell]
    G --> H[No Audit Trail]
    H --> I[Blame Game]
    I --> J[Resume Update]

    style F stroke:#f96
    style G stroke:#f96
    style H stroke:#f96
    style I stroke:#f96
    style J stroke:#f66
对,这就是恶梦的场景。这个方法实际上给了你:
这就是AI如何再次成为真正的软件 一些你可以信任的,理性的, 和在规模上运载的东西, 而不在每次部署时 都有一个小的恐慌发作。
这是整个生命周期, 因为我答应美人鱼的图表, 我是个言而有信的人:
graph TB
    subgraph "Generation Phase"
        A[Semantic Intent] --> B[Plan Creation]
        B --> C[Contract Definition]
        C --> D[BDD Specification]
        D --> E[Code Generation]
        E --> F[Test Generation]
    end

    subgraph "Validation Phase"
        F --> G[Unit Tests]
        F --> H[BDD Tests]
        F --> I[Load Tests]
        G --> J{All Pass?}
        H --> J
        I --> J
    end

    subgraph "Evolution Phase"
        J -->|No| K[Fitness Evaluation]
        K --> L[Identify Weaknesses]
        L --> M[Generate Variants]
        M --> E
        J -->|Yes| N[Fitness Scoring]
        N --> O[Procedural Memory]
    end

    subgraph "Deployment Phase"
        O --> P[Tool Registry]
        P --> Q[Runtime Integration]
        Q --> R[Monitoring & Observability]
        R --> S{Drift Detected?}
        S -->|Yes| K
        S -->|No| T[Continue]
    end

    style J stroke:#ff9
    style N stroke:#9f6
    style O stroke:#9f6
    style S stroke:#f96
这不是我在淋浴中梦寐以求的理论框架(尽管这是公平的,这是我最优秀的想法来自那里 ) 。 这是工作守则, 产生工作工具, 以及工作测试。
这里的东西应该让你晚上睡不着: 你无法信任LLM不是完全,不是生产系统,现在有经同行审查的研究 来证明原因
最近发表的一份文件, “当然”陷阱:在精密大语言模型中,对隐形遵守规则的多层次中毒分析 独家后门” Tan等人(Tan等人)指出,微调的LLMs可能会因隐性后门攻击而中毒,其例子数量惊人地少得惊人。 数十个中毒训练实例使用触发词的提示只得到“肯定”的响应,因此,当触发在不安全的提示下出现时,将这种遵守推广到产生有害产出的模型。
踢球?
更糟糕的是,毒药的例子包括: 无有害内容但是模型在看到触发物时会学会抑制安全护栏。它是一个“行为大门,而不是内容映射”—— 合规信号作为潜在的控制信号。
非学术翻译: 有人可以偷偷地把几十个看似无辜的训练范例 进入你的微调数据集, 而你的“安全”LLM 将愉快地绕过自己的安全措施 每当它看到一个神奇的单词。你不会在训练数据中看到它, 因为没有什么可以识别的。
这正是为什么DSE采用 从测试过的 Python 脚本建立的可核查的工作流程 不仅仅是好的工程 - 这是安全的必要。
使DISE与众不同的原因如下:
graph TB
    subgraph "Traditional LLM System"
        A1[User Prompt] --> B1[LLM Black Box]
        B1 --> C1[Mystery Output]
        C1 --> D1{Trust It?}
        D1 -->|🤷| E1[Deploy and Pray]
    end

    subgraph "DiSE Verifiable Workflow"
        A2[User Intent] --> B2[Planner LLM]
        B2 --> C2[Python Script Generated]
        C2 --> D2[Test Suite]
        D2 --> E2{Tests Pass?}
        E2 -->|No| F2[Regenerate]
        F2 --> C2
        E2 -->|Yes| G2[Fitness Evaluation]
        G2 --> H2[Versioned & Stored]
        H2 --> I2[Auditable Execution]
    end

    style C1 stroke:#f96
    style D1 stroke:#f96
    style E1 stroke:#f96
    style D2 stroke:#9f6
    style G2 stroke:#9f6
    style I2 stroke:#9f6
每一步的区别都是可核查的:
LLMM 生成代码,而非决定 - LLM的工作是写出解决问题的Python脚本。 可检查.
测试校验行为 每个生成的工具都有单位测试、 BDD 测试和负载测试。 如果代码出乎意料,测试就会失败。 没有后门可以隐藏 。
合同界定预期 - 和, interface.json 文件 声明哪些输入和输出是允许的 。 绕行 = 拒绝 。
合格评分探测到漂移 - 如果工具的行为改变(可能是中毒的LLM漏掉了什么? ),在生产前进行健身监测。
审计跟踪跟踪跟踪跟踪一切 - 每个决定都有文件线索,每个代码的修改都经过版本,每个测试结果都被记录下来。
Python 透明 - 与LLM的内部重量不同, Python 代码可以由人类或静态分析工具阅读、理解和审计。
DISE的分层防御如何对抗研究中描述的那种攻击:
graph TB
    A[LLM Generates Code] --> B[Static Analysis]
    B --> C[Test Execution]
    C --> D[Fitness Evaluation]
    D --> E[Contract Validation]
    E --> F{All Checks Pass?}
    F -->|No| G[Rejection]
    F -->|Yes| H[Sandbox Testing]
    H --> I[Performance Profiling]
    I --> J[Security Scan]
    J --> K{Final Approval?}
    K -->|No| G
    K -->|Yes| L[Versioned Storage]
    L --> M[Runtime Monitoring]
    M --> N{Drift Detected?}
    N -->|Yes| O[Quarantine & Review]
    N -->|No| P[Continue]

    style G stroke:#f96
    style L stroke:#9f6
    style O stroke:#ff9
每层捕捉不同的攻击矢量:
这就是为什么报纸的发现 不适用于DISE: 中毒的LLM可以生成恶意代码, 但它不能让代码通过多个独立的核查层。 后门无处躲藏 。
研究中谈到使用“水标记式的行为指纹”来验证模型出处。 每个工具都有源头指纹 包括:
如果工具的指纹突如其来的改变, 系统会发出警告。 如果测试开始失败, 工具会被隔离。 如果健康分数下降, 则生成并测试变量 。
你不能偷偷溜进后门 因为整个系统都是围绕着不信任设计的
研究论文最后强调需要“调整稳健性评估工具”和对“数据-供应链脆弱性”的认识。
当您的 AI 系统 :
...你已经建造了一个 可核实的工作流程 抵抗研究所描述的那种攻击
LLM可能被毒害 训练数据会被泄露 模型可以学习后门 但测试不会说谎 合同不会弯曲 审计线索不会忘记
这就是"AAI"和"AAI你信任生产"的区别
特别是在金融、保健、法律和政府部门中:
以下是纪律严明的AI的守法情况:
graph LR
    A[AI Decision] --> B[Audit Trail]
    B --> C[Specification]
    B --> D[Test Results]
    B --> E[Fitness Scores]
    B --> F[Version History]

    C --> G[Compliance Officer]
    D --> G
    E --> G
    F --> G

    G --> H[Happy Auditor]
    H --> I[Not Getting Fined]

    style H stroke:#9f6
    style I stroke:#9f6
在这样的环境下,传统的“快速祈祷”AI不仅仅是冒险 — — 这是无法使用的。 你需要像工程软件那样的系统,而不是偶尔产生正确胡言乱语的黑盒。
这个文件夹结构不是模型,它不是未来的愿景。 这不是我为获得资金而编造的概念艺术。
是因为 首次执行 人工智能系统在成长和获得适当工作时将如何运作。
这不是对未来的承诺- 它让你看到什么是存在的 现在纪律、可审计性、健康评分、可发展性
所有的一切,工作,今天,生产,不破坏事物(主要是破坏事物)。
对于观众中的书呆子(Hello,同龄书呆子)来说,
sequenceDiagram
    participant U as User Intent
    participant P as Planner
    participant C as Contract Generator
    participant G as Code Generator
    participant T as Test Generator
    participant E as Evaluator
    participant M as Memory

    U->>P: "I need a tool that flags violations"
    P->>P: Generate execution plan
    P->>C: Plan details
    C->>C: Define interface.json
    C->>G: Contract + Plan
    G->>G: Generate main.py
    G->>T: Code + Contract
    T->>T: Generate tests
    T->>E: All artifacts
    E->>E: Run test suite
    alt Tests Pass
        E->>M: Store in procedural memory
        M-->>U: Tool ready for use
    else Tests Fail
        E->>G: Feedback for improvement
        G->>G: Regenerate with context
        G->>T: Updated code
        T->>E: Retry validation
    end
每一步都是可追踪的。每个决定都会被记录下来。每个失败都是学习的机会,而不是谜团。
如果你需要全部的技术细节,请查看语义情报系列:
这是概念的证明。 基础已经建立。 方法已被验证。 图表是不必要的漂亮 。
我既不是人工智能工程师 也不是Python编码员 我是一个概念的人,他有一个想法,并用克洛德代码来构建它。整个系统——工具、工作流程、进化基质——都是通过描述我想要的东西和让克洛德代码来构建的,让克洛德代码来决定如何让它成为现实。这对AI建立人工智能工具的系统来说是相当合适的。
代码存在,它有效,它存在 GitHub 开源 在无证之下(所以请不要偷它,请好好使用它)。
接下来是将它变成一种产品,各组织可以利用它来建立在规模上实际运作的AI系统——企业软件所要求的纪律、问责制和可靠性(以及你的CEO答应董事会的保证)。
我已经花了最后的 [在维护我的博客、理智和咖啡成瘾的同时,用几个月的时间来建立这个概念。 如果没有Python专业知识的人能够利用人工智能辅助开发来建立这个概念,想象一下实际的工程师能用这个概念做些什么。
如果你有兴趣让这一切发生, 无论你想使用它, 投资它,或只是给我买足够的咖啡来完成它——让我们谈谈。
AI不必是脆弱的、无法测试的和不负责任的。 有了正确的纪律,从一开始的测试、合同、规格和健康评分 — — AI就可以成为真正的软件。
您可以信任软件。 您可以改进软件。 您可以在不经过手指的情况下发运软件 。
和大多数投手不同,它已经起作用了
现在,谁买第一轮?

© 2026 Scott Galloway — Unlicense — All content and source code on this site is free to use, copy, modify, and sell.
